Attention Alternatives 与 MoE
当我们把一个 decoder-only Transformer 真的训练起来以后,很快会遇到两个看似不同、实际上同源的问题:上下文越长,attention 越贵;模型越大,每个 token 要走过的参数越多。沿着这个问题继续往下推,我会把它们都转成“稀疏化”的系统设计问题:在时间维度上,不一定让每个 token 都看见所有 token;在参数维度上,不一定让每个 token 都激活所有参数。
这不是简单地把模型砍小。更准确地说,我们希望保留足够的表达能力,同时让计算量、显存访问、通信和推理延迟不要按最坏方式增长。注意力替代方案解决的是 context length 带来的二次成本,Mixture of Experts 解决的是 total parameters 和 active parameters 的解耦。
标准 attention 为什么贵
标准 attention 的输入可以记成三个矩阵:\(Q\in\mathbb{R}^{n\times d_k}\)、\(K\in\mathbb{R}^{n\times d_k}\)、\(V\in\mathbb{R}^{n\times d_v}\)。这里 \(n\) 是序列长度,\(d_k\) 是 query/key 的维度,\(d_v\) 是 value 的维度。忽略缩放系数后,attention 的核心形式是:
贵的地方先出现在 \(QK^\top\)。\(Q\) 有 \(n\) 行,\(K\) 也有 \(n\) 行,因此打分矩阵是 \(n\times n\)。每个 query 都要和每个 key 做一次内积,所以这一步的计算量大约是 \(O(n^2d_k)\);得到 attention 权重以后,再乘上 \(V\),还有大约 \(O(n^2d_v)\)。这就是长上下文模型里反复出现的二次成本。
这里的关键不是“大 O 符号很吓人”,而是它会直接撞上系统边界。上下文长度从 8K 到 32K,不是贵 4 倍,而是在 attention map 相关路径上接近贵 16 倍。即使 FlashAttention 这类 kernel 能把中间矩阵的显存占用降下来,它也没有改变 full attention 在 token 对上的组合规模。于是我们会自然问:如果每个 token 不必显式和所有 token 两两交互,能不能保持足够好的建模能力?
线性注意力的第一步推导:换一下乘法顺序
先看一个故意简化的情况:如果 \(\rho\) 是恒等函数,也就是先暂时不考虑 softmax,那么 attention 里的乘法可以重新结合:
如果按标准 attention 的顺序先算左边,第一步会产生 token-token 矩阵:
这个矩阵的第 \(i\) 行表示第 \(i\) 个 query token 和所有 key token 的相似度。后面再乘 \(V\),等价于让每个 token 按这一行权重读取所有 value。计算量大致是:
所以总复杂度是:
右边的计算顺序完全不同。它先把所有 key-value 信息聚合成一个不随序列长度二次增长的摘要矩阵:
然后每个 query 再去读这个摘要:
对应计算量约为:
也就是:
当 \(d_k\) 和 \(d_v\) 是固定 head 维度时,真正增长的变量主要是 \(n\)。左边显式构造 \(n\times n\) 关系,所以随上下文长度二次增长;右边把历史压成 \(d_k\times d_v\) 的状态,所以随 token 数线性增长。
真实 attention 的困难在 softmax。对第 \(i\) 个 query,标准 attention 可以展开为:
也可以写成分子和分母的形式:
这里每个 query \(q_i\) 都有自己的归一化分母。指数函数和按行归一化让 \(\operatorname{softmax}(QK^\top)V\) 不能直接通过结合律改成 \(Q(K^\top V)\)。这就是为什么线性注意力不是简单删除 softmax,而是要把 softmax kernel 近似成可分解的内积形式:
代入后,分子可以重排:
分母也可以重排:
于是两个可维护的状态自然出现了。第一个状态保存历史 key 对 value 的加权汇总:
第二个状态保存归一化所需的 key 特征总量:
它们对应的递推式就是:
当前 token 的输出则变成:
这个式子的直觉是:标准 attention 每次都摊开所有历史 token,显式计算当前 token 和每个历史 token 的关系;线性 attention 则维护一个“历史摘要账本”。新的 key-value 进来时,把 \(\phi(k_t)v_t^\top\) 加到账本 \(S_t\) 里,把 \(\phi(k_t)\) 加到归一化账本 \(z_t\) 里。query 到来时,不再逐个扫描历史 token,而是用 \(\phi(q_t)\) 去读这两个状态。
所以线性注意力的收益来自状态压缩:它把显式的 \(n\times n\) attention map 换成固定维度的 \(S_t\) 和 \(z_t\)。训练时可以用并行 scan 或等价矩阵形式批量计算;推理时则像 RNN 一样逐 token 更新状态。代价也在这里:历史 token-token 关系不再完整保留,而是被压进特征映射 \(\phi\) 定义的状态空间里,因此效果和稳定性很依赖 \(\phi\) 的选择。
特征映射通常怎么设计
特征映射 \(\phi\) 的设计目标,是让 softmax attention 里的指数相似度可以近似写成两个向量的内积:
这样才能把历史 key-value 聚合进 \(S_t\) 和 \(z_t\)。一个实用的 \(\phi\) 通常要满足三点:输出最好非负,避免归一化分母出现正负抵消;维度 \(d_\phi\) 不能太大,否则 \(S_t\in\mathbb{R}^{d_\phi\times d_v}\) 本身会变贵;数值上要稳定,避免指数或累积状态溢出。
设计方式 |
典型形式 |
直觉 |
主要取舍 |
|---|---|---|---|
正值激活 |
\(\phi(x)=\operatorname{elu}(x)+1\) 或 \(\operatorname{softplus}(x)\) |
直接构造非负特征,让注意力可以线性递推 |
简单、快、稳定,但不是严格近似 softmax |
随机特征 |
\(\phi(q)^\top\phi(k)\approx \exp(q^\top k)\) |
Performer / FAVOR+ 这类方法用随机特征近似 softmax kernel |
更接近原始 softmax,但特征数太少会有方差,太多又会增加状态大小 |
多项式近似 |
\(\exp(q^\top k)\approx 1+q^\top k+\frac{(q^\top k)^2}{2}\) |
从指数函数的 Taylor 展开构造特征 |
数学直观,但高阶项维度膨胀很快 |
可学习映射 |
\(\phi(x)=\operatorname{positive}(Wx)\) |
让模型自己学习适合任务的特征空间 |
灵活,但训练稳定性和长上下文外推更难保证 |
因此,简单 baseline 常用 \(\operatorname{elu}(x)+1\) 或 \(\operatorname{softplus}(x)\);如果目标是更认真地保留 softmax 的性质,会考虑 Performer 这类随机特征方法。核心判断是:\(\phi\) 决定了历史 token 被压缩成什么样的状态。它越接近 softmax kernel,行为越像标准 attention;它越简单,计算越便宜,但状态压缩造成的信息损失也可能越明显。
从线性注意力到 Mamba-2:递推状态需要会遗忘
纯线性注意力的问题也很直接:如果状态只是不断累加,它不容易表达“这段上下文现在不重要了”。于是下一步自然是给状态加门控。Mamba-2 可以从这个角度理解:它在状态更新里加入一个位置相关的衰减项 \(\gamma_t\),让模型决定旧状态应该保留多少。
Linear:\(S_t=S_{t-1}+k_tv_t^\top\)
Mamba-2:\(S_t=\gamma_tS_{t-1}+k_tv_t^\top\)
这个变化很小,但含义很大。没有 \(\gamma_t\) 时,所有历史都以同样方式进入状态;有了 \(\gamma_t=f(x_t)\),当前 token 可以控制状态记忆的衰减速度。这样模型不再只是“压缩历史”,还可以学习不同语境下的时间尺度。RetNet、Mamba-2、fast weight programmer 之间可以建立联系,也正是因为它们都在围绕“用可更新状态替代完整注意力矩阵”这件事做文章。
Gated Delta Net 继续往前走一步:它不仅能给旧状态打折,还能沿着当前 key 的方向选择性擦除状态。直觉上,普通递推像往笔记本里不断追加内容;带擦除的递推则允许模型说:“这个方向上的旧记忆已经被新证据覆盖了。”这比单纯累加更接近可控记忆系统。
为什么现代模型喜欢混合,而不是押注单一替代品
如果线性注意力这么诱人,为什么不把 full attention 全换掉?原因是 full attention 的表达能力很强:任意两个 token 都可以直接建立关系,模型不必把所有历史信息塞进一个固定大小的状态。线性或状态空间类方法虽然更便宜,但状态压缩本身会带来信息瓶颈。
因此很多新模型采用混合结构,而不是二选一。MiniMax M1 使用类似 7 个 linear attention 层配 1 个 full attention 层的结构;Nemotron 3、Qwen 3.5 / Qwen Next 也使用 Mamba、Gated Delta Net 与 attention 的混合。这样做的逻辑是:大部分层用便宜的状态更新承担局部和常规依赖,少数层保留 full attention,让模型仍然能周期性地做全局信息交换。
这个思路和后面要讲的 MoE 很像:不要让每一步都走最贵路径,而是在结构上安排“多数廉价路径 + 少数全能力路径”。它不是把 Transformer 推翻,而是在系统成本最敏感的地方做稀疏化。
稀疏注意力:不是所有 token 都值得看
另一条控制长上下文成本的路线,是保留 attention 的基本形式,但减少每个 token 可以看的位置。局部 attention 或 sliding window attention 让 token 只看附近窗口,成本从全局二次关系降下来;global attention 或周期性 full attention 则负责把远距离信息重新连起来。
可以把它理解成图结构问题。标准 full attention 是一个完全图,每个 token 都连到所有 token;滑动窗口 attention 是一条带宽有限的局部图;混合注意力则在局部图上周期性加入全局边。这样一来,模型的表达能力取决于信息在多少层之后能传到远处,而系统成本取决于每层实际保留多少条边。
DeepSeek Sparse Attention 这类方法进一步引入轻量 indexer,让模型不只是按固定窗口看上下文,而是选择更可能相关的 token。它的吸引力在于可以在 dense short-context 预训练之后做 post-hoc 适配,代价是实现和验证复杂度都会上升:一旦选择机制错过关键 token,模型就没有机会在那一层使用它。
方法 |
省的是什么 |
付出的代价 |
|---|---|---|
Linear attention |
显式 |
需要用可递推状态近似或替代 softmax attention |
Mamba / GDN hybrid |
大部分 full attention 层 |
状态更新规则更复杂,需要验证长程依赖能力 |
Sliding window attention |
每层的远距离 token-token 连接 |
长程信息传播变慢,需要和 full attention 交错 |
Sparse attention |
不相关 token 的 attention 边 |
选择机制本身可能错过关键信息 |
MoE :增加总参数,但不增加每个 token 的计算量
注意力替代解决的是序列长度。MoE 解决的是另一个维度:模型参数规模。dense Transformer 的 FFN 是每个 token 都要经过同一组大矩阵。如果把 FFN 做得更宽,模型容量增加了,但每个 token 的 FLOPs 也一起增加;训练和推理都会变贵。
MoE 的核心做法是把一个大 FFN 换成很多个 expert FFN,再用一个 router 为每个 token 选择少数几个 expert。假设我有 64 个 expert,但每个 token 只走 2 个,那么总参数量可以接近 64 份 FFN,单 token 的 FFN 计算却只接近 2 份。于是 total parameters 和 active parameters 被拆开了:模型可以“知道更多”,但每次只“调用一小部分”。
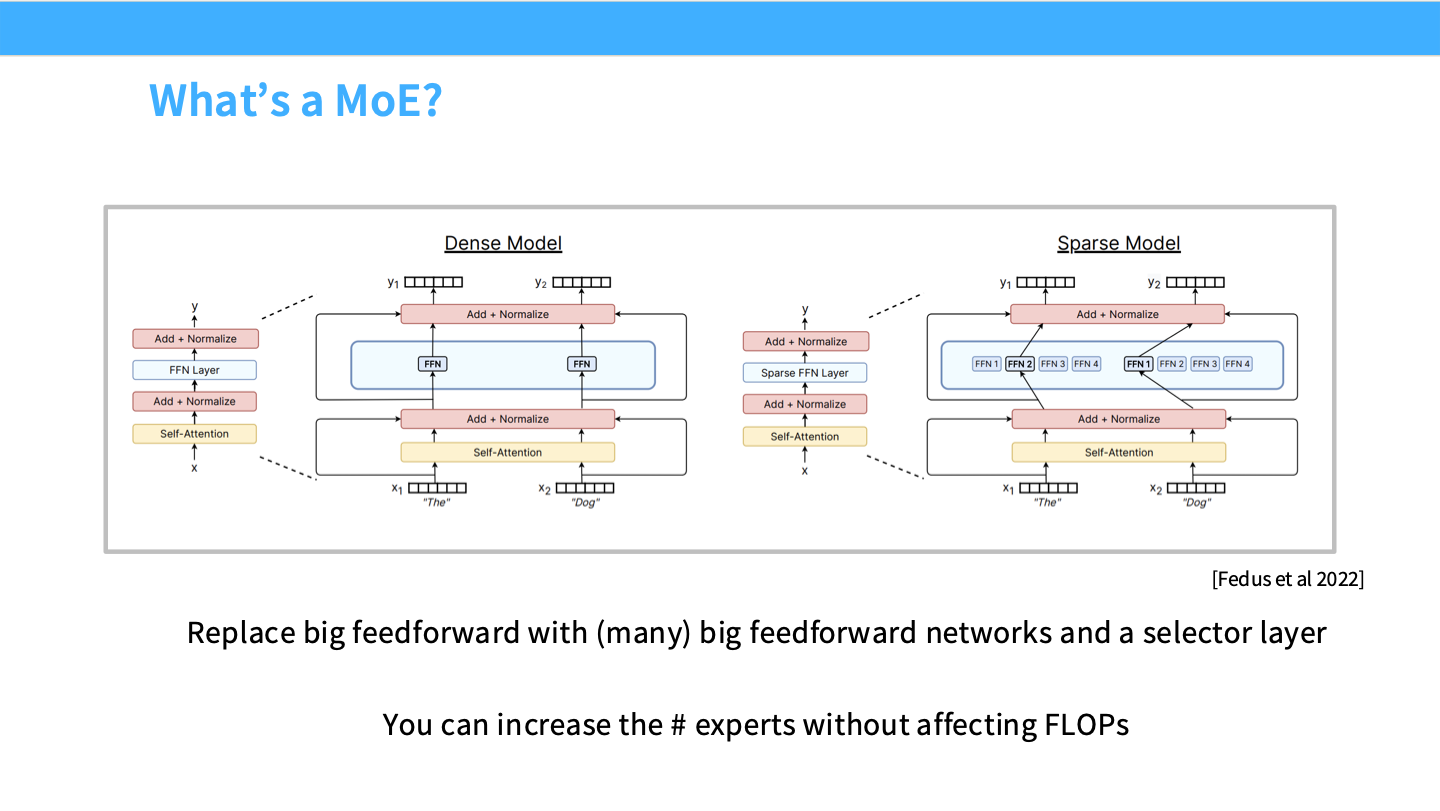
这也是 MoE 近年重新流行的根本原因。同样 FLOPs 下,更多参数通常能给模型更多容量;训练时 expert 可以分布到多台设备上;推理时如果路由和通信处理得好,active compute 仍然可控。它不是免费午餐,但它把“更大模型”从纯计算扩张变成了稀疏调度问题。
Top-k routing:每个 token 自己选择专家
最常见的 MoE router 是 token-choice top-k。对每个 token 表示 \(x\),router 先算一组 expert logits,可以理解为 \(r=xW_{\mathrm{router}}\)。这些分数表示“这个 token 应该交给哪个 expert”。然后模型选择分数最高的 \(k\) 个 expert,把 token 发过去计算,最后按 gate 权重把 expert 输出合并回来。
这个过程有三个容易混淆的点。第一,router 是按 token 决策,不是按整句统一决策;同一个 batch 里的不同 token 可以走不同 expert。第二,\(k\) 是 active experts 数,不是总 expert 数;Switch Transformer 取 \(k=1\),GShard、Mixtral、Grok 常取 2,Qwen/DBRX 可取 4,DeepSeek 系列会更大。第三,top-k 之后是否再 softmax、是否用 sigmoid 评分、是否有 shared experts,都是具体实现差异,但主线仍是“稀疏激活”。
除了 token-choice,还有 expert-choice 和全局匹配式 routing。expert-choice 让 expert 挑 token,全局匹配则把路由看成优化问题。它们在负载均衡上可能更自然,但实现复杂度和训练习惯不同。现代公开 MoE 大多仍然使用 token-choice top-k,因为它简单、可扩展、也足够有效。
为什么 MoE 训练难:离散路由不可微,负载还不能失衡
MoE 最难的地方不是“有很多 FFN”,而是 router 的选择是离散的。top-k 选择像一次 \(\operatorname{argmax}\) 或排序,严格来说不可微;如果直接让梯度穿过硬选择,会出现训练信号不稳定、expert 使用不均衡等问题。早期思路包括用强化学习优化路由、给路由加随机扰动、或者用辅助损失鼓励负载均衡。实践里最常见的是第三类:heuristic balancing losses。
为什么负载均衡这么重要?因为 MoE 的效率来自专家并行。假设 8 台机器各放一部分 experts,如果 router 总把 token 发给同一台机器,那台机器会成为 straggler,其他机器空转;如果某个 expert 超过容量,还可能发生 token dropping。于是训练目标不能只优化语言模型 loss,还要让 token 在 experts 或 devices 之间更均匀地分布。
Switch Transformer 的 load balancing loss 可以从直觉上这样理解:如果某个 expert 被选得太频繁,它对应的 router 概率会受到更强的下调压力;如果某个 expert 长期闲置,则模型会被鼓励把一部分 token 分过去。DeepSeek v1/v2 还会做 per-device balancing,因为跨设备通信是否均衡同样影响吞吐。DeepSeek v3 又引入 per-expert bias,用在线方式调 expert 被选中的倾向,试图减少传统 auxiliary loss 对主任务优化的干扰。
训练问题 |
为什么会发生 |
常见处理 |
|---|---|---|
路由不可微 |
top-k 选择是离散操作 |
用 soft gate、随机扰动、辅助目标或在线 bias 近似优化 |
专家负载不均 |
router 会偏好少数 expert |
per-expert / per-device balancing loss |
token dropping |
expert 容量有限,热门 expert 超载 |
容量因子、负载均衡、减少 batch 内竞争 |
router 数值不稳 |
router logits 直接决定稀疏路径 |
router 用 FP32,必要时加 z-loss |
小数据微调过拟合 |
稀疏路径在小样本上容易专门化 |
只微调非 MoE MLP、增加 SFT 数据或约束 router |
系统侧的 MoE:计算少了,通信变成主角
从算法图看,MoE 只是把 FFN 换成多个 experts;从系统实现看,它会引入一次很重的 token dispatch。每个 token 经过 router 后,可能要被发送到持有目标 expert 的设备上;expert 算完后,结果还要被收集回来并按权重合并。这通常涉及 all-to-all 通信。
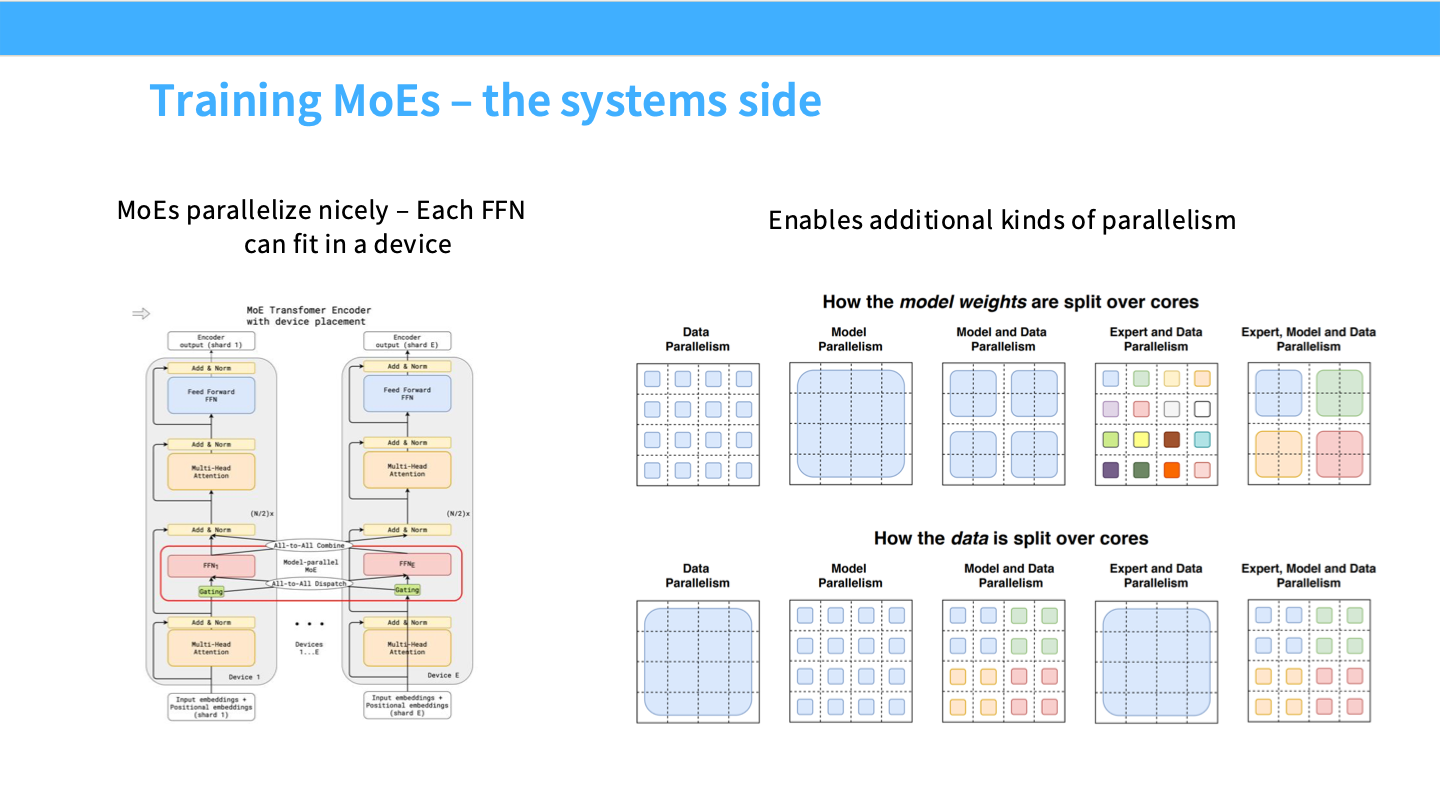
这解释了为什么 MoE 在多机多卡上既有吸引力,也很麻烦。吸引力在于每个 expert 可以放在不同设备上,模型总参数可以远大于单卡容量;麻烦在于 token 路由会制造动态、稀疏、不规则的通信模式。现代库如 MegaBlocks 会把这些稀疏 token-expert 计算组织成更高效的 sparse matrix multiplication,减少 padding 和碎片化。
还有一个重要方向是减少通信量本身。以 Nemotron 3 采用的 down-projecting activations 为例,我们可以在专家并行通信前先把 token 表示压到更低维,从而降低 all-to-all 需要搬运的字节数。当然,这会引入额外投影,也可能影响表达能力,所以仍然是 compute、communication 和 quality 的三方权衡。
MoE 的随机性:为什么别人的请求会影响我的输出
MoE 还有一个容易被忽略的现象:推理时可能出现额外随机性。原因不是采样温度,而是 routing 和容量限制常常在 batch 级别发生。如果多个用户的 token 被打包在同一个 batch 里,它们会竞争 expert 容量。当某个 expert 满了,后来的 token 可能被 drop 或改路由。于是别人的 token 分布可能间接影响我的 token 是否进入原本最优的 expert。
这也是为什么生产系统里 MoE 不能只看模型结构,还要看 serving scheduler、batching 策略、capacity factor、router 精度和 fallback 行为。对用户来说,它表现为“同样输入偶尔不完全一样”;对系统来说,它是稀疏调度带来的可观测性问题。
从 upcycling 到 DeepSeek MoE:把 dense 模型改造成 sparse 模型
训练一个 MoE 不一定要完全从零开始。upcycling 的思路是用已有 dense LM 初始化 MoE:把原来的 FFN 复制或拆分成多个 experts,再继续训练 router 和 experts。这样可以复用 dense 模型已经学到的语言能力,降低从随机初始化训练稀疏模型的风险。MiniCPM 和 Qwen MoE 都提供了这类成功案例。
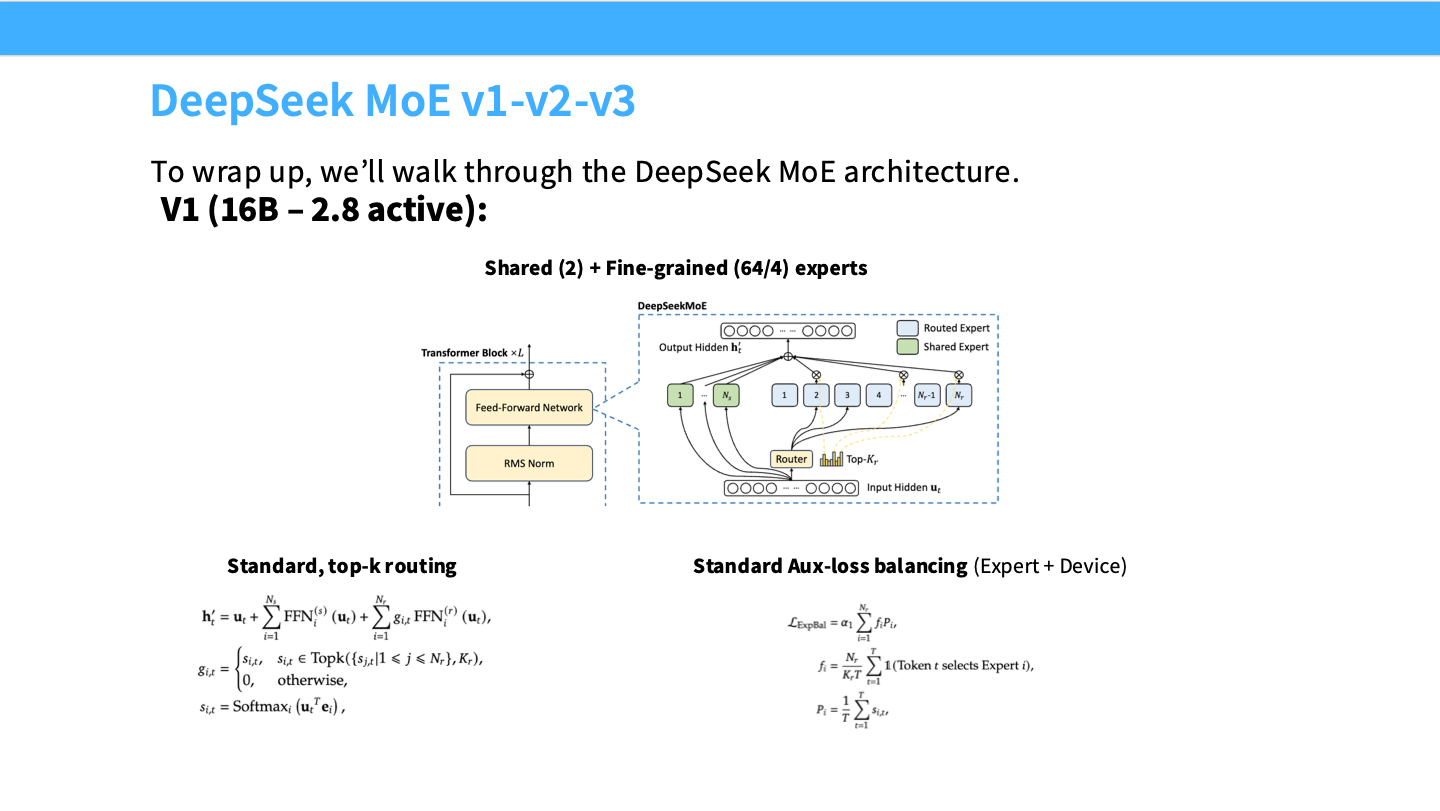
DeepSeek MoE 的演进可以看作一个很好的工程样本。V1 使用 shared experts 和 fine-grained experts,再配合标准 top-k routing 与 expert/device auxiliary balancing;V2 扩大到更多专家和更高 active parameter,并加入 top-M device routing 与通信平衡目标;V3 进一步使用 sigmoid + softmax top-k、top-M 以及更少依赖传统 aux loss 的平衡方式。这个演进方向不是单纯“专家越多越好”,而是在更细粒度专家、更强路由、更少通信和更稳定训练之间持续调参。
版本 |
规模直觉 |
关键变化 |
我会关注的风险 |
|---|---|---|---|
DeepSeek MoE V1 |
16B total,约 2.8B active |
shared experts + fine-grained experts,标准 top-k,expert/device balancing |
路由质量和负载均衡是否足够稳定 |
DeepSeek MoE V2 |
236B total,约 21B active |
更多 experts,top-M device routing,通信 in/out balancing |
跨设备通信是否抵消稀疏计算收益 |
DeepSeek MoE V3 |
671B total,约 37B active |
sigmoid + softmax top-k,per-expert bias,sequence-wise aux |
弱化 aux loss 后是否还能长期维持负载平衡 |
MLA:继续压缩 KV cache,但要处理 RoPE 冲突
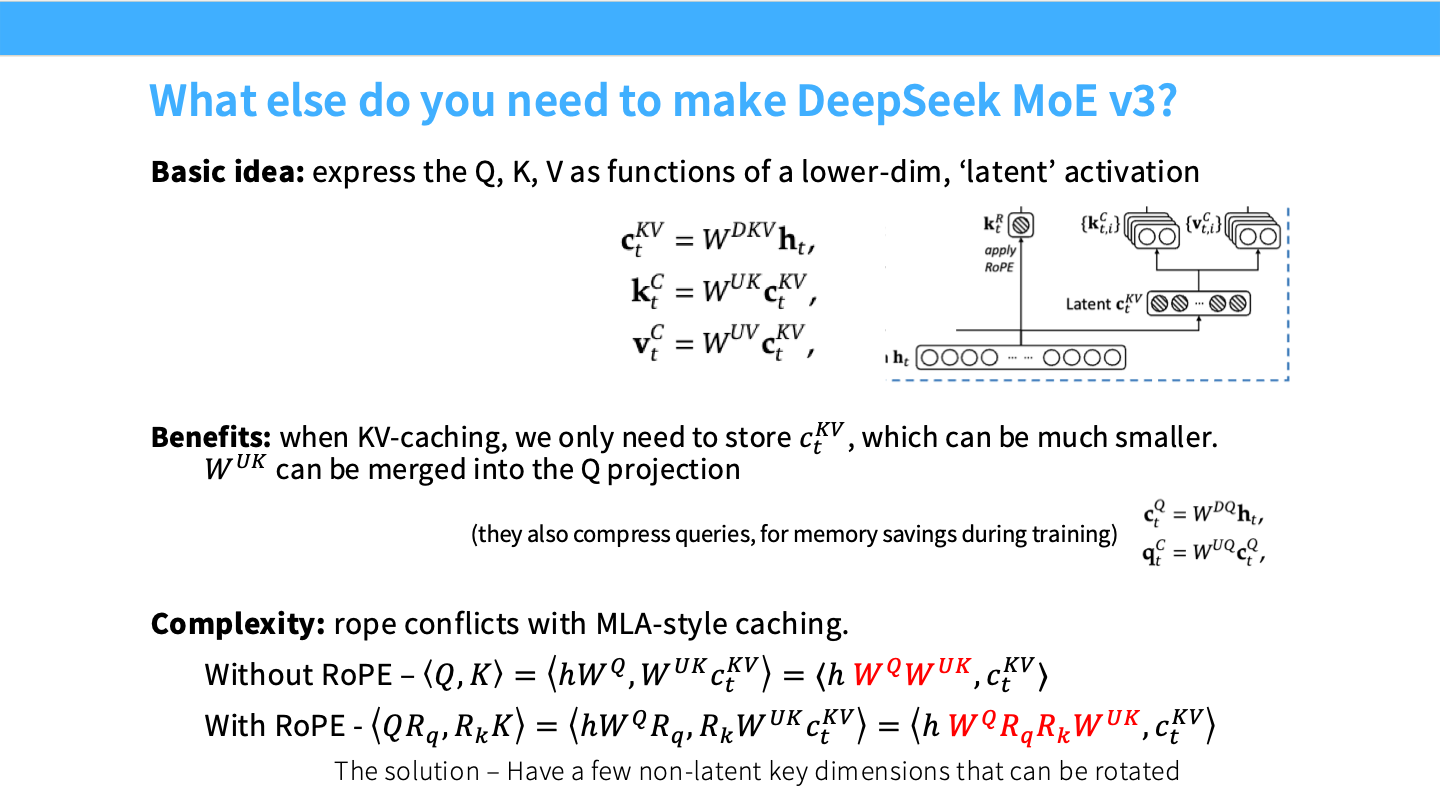
前面分析过,生成时 KV cache 是推理成本的核心来源之一。MLA,也就是 Multihead Latent Attention,可以理解为把 key/value 的缓存从显式高维向量压成低维 latent activation。生成时我们只保存较小的 \(c_t^{KV}\),需要 query-key 打分或 value 聚合时,再通过投影把相关量恢复出来。
这个想法为什么有效?因为 KV cache 是按层、按 token、按 batch 累积的。只要上下文变长,缓存就线性增长;只要并发 batch 变大,缓存也线性增长。如果能把每个 token 的缓存维度压小,收益会在长上下文推理里被放大。
但 MLA 和 RoPE 会发生一个具体冲突。没有 RoPE 时,某些 key 侧上投影可以和 query 投影合并,等价地把计算挪到 query 路径上;有 RoPE 时,query 和 key 会分别乘上位置相关旋转矩阵,旋转打破了这种简单合并。DeepSeek 的解决思路是保留一小部分 non-latent key dimensions 专门参与 RoPE,让主干 KV 仍然能以 latent 形式缓存。这是一个很典型的系统型折中:为了保留 RoPE 的相对位置信号,牺牲一点压缩纯度。
怎样选择 Attention alternatives 和 MoE
如果目标是训练一个标准 dense 模型,不应该一开始就上最复杂的 linear attention 或 MoE。推荐默认顺序是:先把普通 full attention baseline 跑稳;如果上下文长度成为主要成本,就优先尝试滑动窗口 + 周期性 full attention,因为它最接近原始 attention 的语义;如果推理 KV cache 成本成为瓶颈,再考虑 GQA、MQA 或 MLA;如果目标是扩大总参数量而保持 active FLOPs 可控,再引入 MoE。
MoE 的引入也要满足几个前提。第一,训练系统必须能稳定处理 token dispatch、all-to-all、expert capacity 和 sparse GEMM。第二,监控必须能看到每个 expert 的 token 数、drop rate、router entropy、per-device load 和通信时间。第三,评估不能只看 perplexity,还要看延迟、吞吐、显存、微调稳定性和 batch 级非确定性。没有这些配套,MoE 很容易从“省计算”变成“把问题转移到系统层”。
小结
把前面几讲的线索连起来看,训练资源账本、现代 Transformer 默认架构、长上下文和参数规模扩张其实落在同一个问题上:单靠 dense full attention 已经不够。我们需要在 token 维度、时间维度、参数维度和设备维度上同时考虑稀疏化。
线性注意力告诉我们,attention 可以被改写成状态更新;Mamba 和 Gated Delta Net 告诉我们,这个状态还可以学会遗忘和擦除;滑动窗口和混合注意力告诉我,全局连接可以周期性保留;MoE 告诉我,总参数量可以大于每个 token 实际使用的参数量;MLA 则把 KV cache 继续压缩到 latent 表示。它们共同指向一个结论:下一代 LLM 架构优化不是单个 trick 的竞赛,而是围绕“哪些信息、哪些参数、哪些通信在当前 token 上真的值得付费”的系统设计。