模型评测
训练把参数变成了一个模型,但只有评测才能回答:这个模型是否真的适合我们要解决的问题。麻烦在于,“好”不是一个可以直接读取的物理量。知识是否丰富、回答是否有帮助、推理是否可靠、执行任务是否成功、是否安全、推理成本是否可接受,都是不同的抽象目标。评测的本质,是把这些抽象目标操作化为可复现的任务、协议和指标。
“好”不是一个标量,而是一组约束
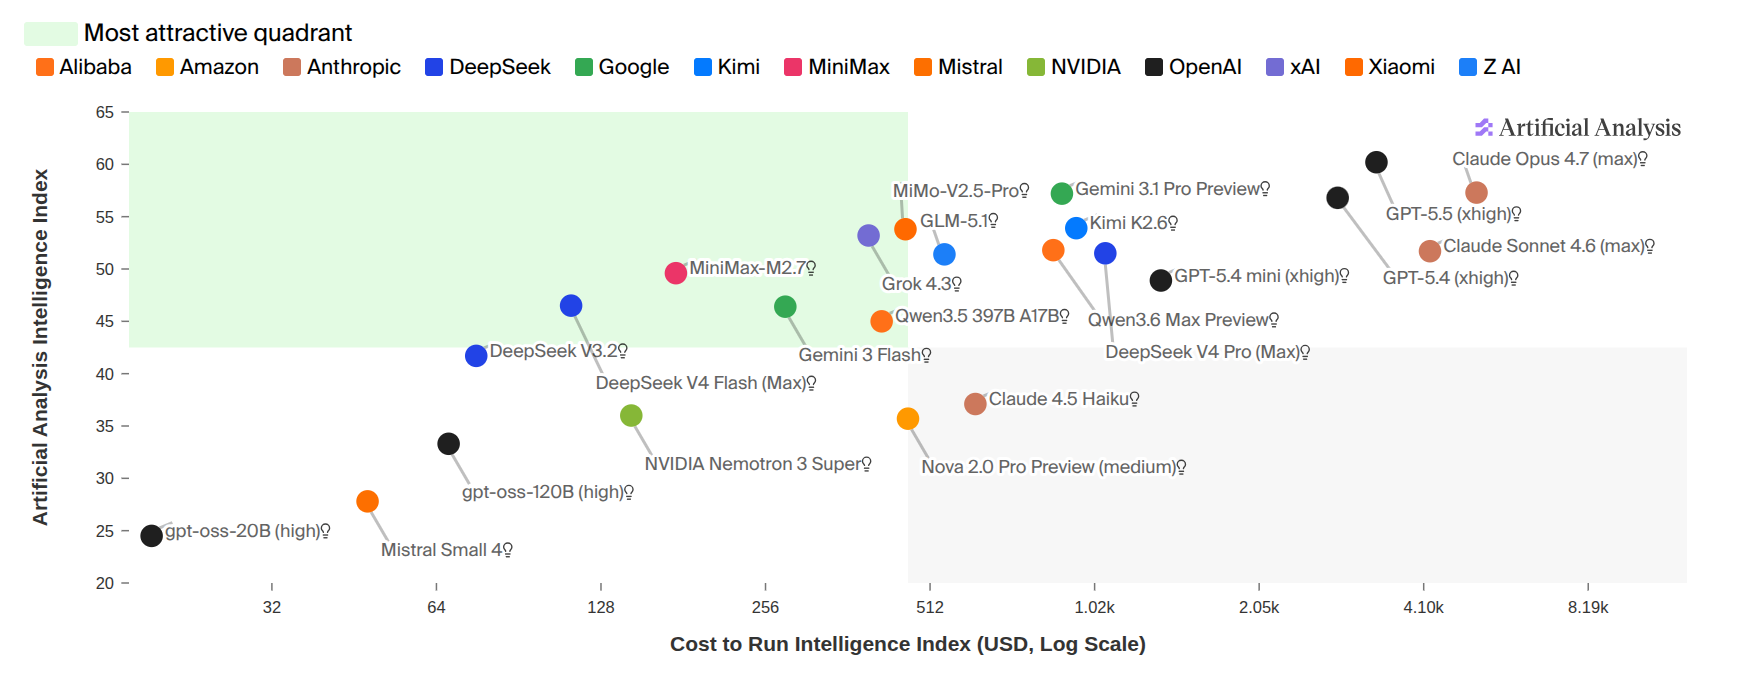
同一个模型可以在知识题上得分很高,却生成冗长且不实用的回答;也可以很受用户欢迎,却价格昂贵、延迟过高;还可能完成大多数常规任务,但在少量安全关键场景中失败。因此,排行榜只是把某种价值判断压缩成一个数字,而不是发现了唯一的“智能刻度”。
更可靠的做法,是先明确决策目标。研究者可能想隔离模型的原始能力;产品团队可能要在质量、延迟和成本之间选型;模型开发者需要知道下一批训练数据应补什么;安全和政策团队则关心收益与风险。目标不同,合适的样本、判分器和聚合方式也不同。
困惑度
语言模型为 token 序列赋予概率。对数据集中的一条序列 \(x_{1:n}\),困惑度可以写成:
它衡量模型平均需要在多大的“有效候选空间”中猜下一个 token。困惑度越低,说明模型给真实文本分配的概率越高。它连续、平滑、样本效率高,因此非常适合比较训练曲线、拟合 scaling law 和做消融实验。
若真实数据分布为 \(t\),模型分布为 \(p\),交叉熵满足:
所以当且仅当 \(p=t\) 时,交叉熵达到 \(H(t)\),对应的最小困惑度是 \(\exp(H(t))\),而不是 \(H(t)\) 本身。这个结论说明困惑度有坚实的信息论基础,但不等于“困惑度足以代表所有能力”。
原因有三。第一,普通困惑度会为每个 token 计分,而任务真正关心的可能只是答案中的少数事实。第二,不同 tokenizer 的 token 粒度不同,未经换算的 PPL 不宜直接横向比较。第三,低平均负对数似然并不自动保证模型能遵循指令、调用工具或避免有害行为。
对 prompt \(x\) 和目标回答 \(y_{1:m}\),更贴近生成任务的是条件困惑度:
LAMBADA、HellaSwag 等任务可以看作把概率评测包装成填空或候选补全。不过,如果排行榜接受参赛者提交一个声称能返回概率的黑盒,还必须确认输出确实构成归一化概率分布;否则“概率接口”本身也可能成为作弊面。
考试型 benchmark
考试题的优势很直接:可以控制学科与难度,答案相对明确,评分成本低。MMLU 用 57 个学科的多项选择题覆盖数学、历史、法律、道德等领域;但它主要测知识与答题能力,不能因为名字里有 Language Understanding 就把分数解释成完整的语言理解。
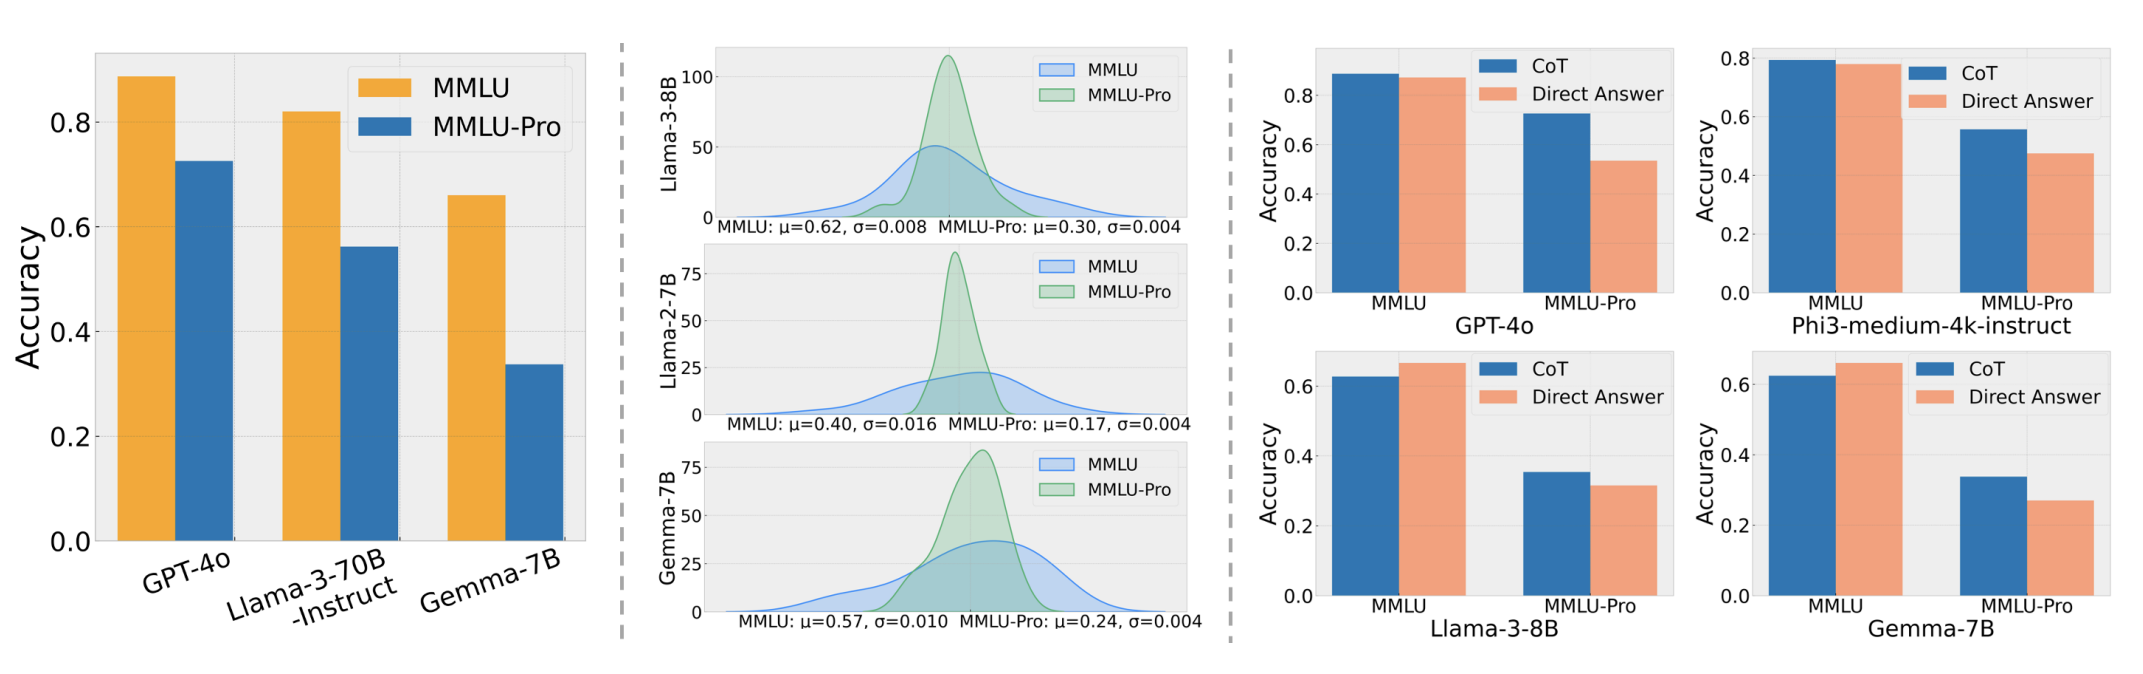
当基准逐渐饱和,常见做法是清理噪声和简单题、增加干扰选项、引入更专业的问题。MMLU-Pro 将选项从 4 个扩展到 10 个,并用 chain-of-thought 协议给模型更多推理机会;在其论文实验中,模型准确率相较 MMLU 下降约 16%–33%。GPQA 让博士级专家编写“Google-proof”问题;HLE 进一步通过前沿模型筛选和多轮审核构造 2500 道高难度、多模态问题。
基准 |
主要想测什么 |
提高难度的方法 |
仍然没有解决的问题 |
|---|---|---|---|
MMLU |
多学科知识与选择题能力 |
57 个学科、few-shot 协议 |
题目逐渐饱和;远离真实开放任务 |
MMLU-Pro |
更难、更稳健的知识推理 |
清理题目、4 选项扩至 10 选项、允许 CoT |
成绩依赖 prompting 和推理预算 |
GPQA |
专业领域的高难问答 |
博士专家出题,非专家难以搜索解决 |
专家题仍不等同于真实工作 |
HLE |
前沿模型仍难解决的广泛问题 |
模型筛选、专家复核、多模态与自动评分 |
基准会继续随模型进步而老化 |
这里最值得学习的不是某个瞬时分数,而是评测协议本身。Direct answer、few-shot、CoT、self-consistency、工具使用和更长的推理预算,都可能改变结果。若不固定协议,比较的就不只是模型。
开放回答
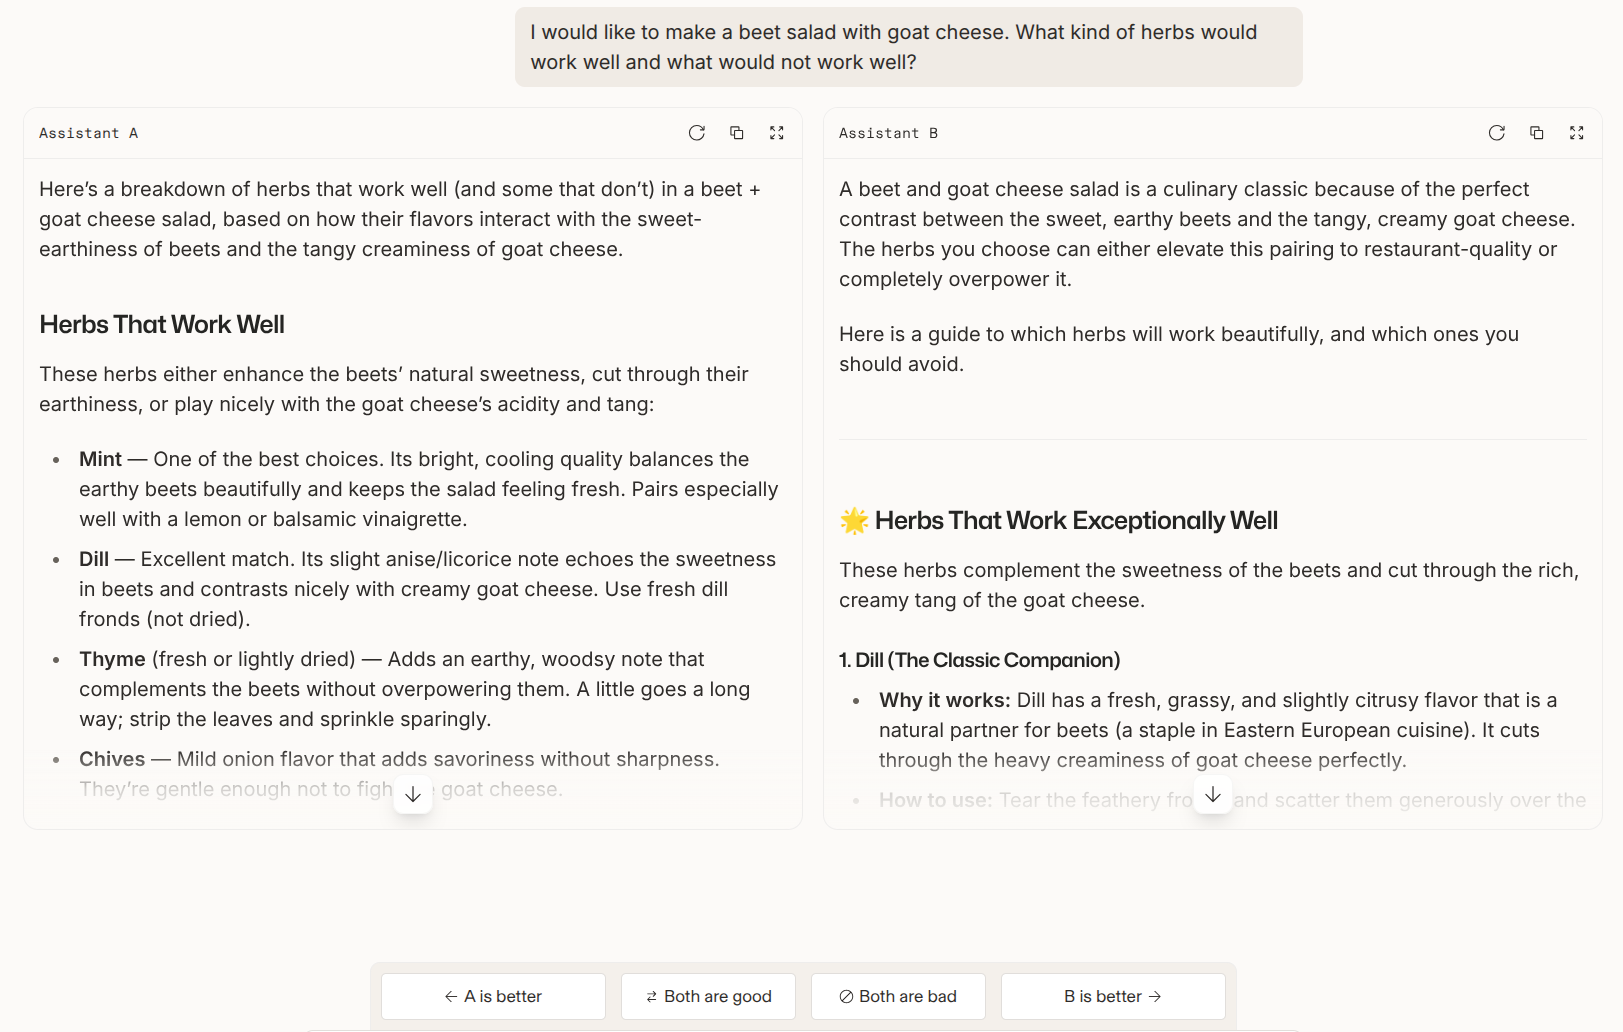
真实用户很少用四选一与聊天助手交互。菜谱建议、解释、写作和方案设计往往有多个合理答案,exact match 无法工作。Chatbot Arena 的做法是匿名展示两个模型对同一真实用户 prompt 的回答,让用户选择 A 更好、B 更好、平局或两者都差。成对偏好再通过类似 Elo 的模型聚合:
Pairwise comparison 的优势,是人通常更容易判断“两份相近答案哪份更好”,而不是给一份开放回答打出绝对的 7.3 分。它还允许不同模型看到不同 prompt,不要求所有参赛者跑完整个固定数据集。
代价是偏好信号混合了很多东西:正确性、风格、长度、格式、奉承倾向甚至品牌印象。参与者分布也不可控,会有地域偏差、选择偏差和 spam。AlpacaEval 曾暴露 LLM judge 偏爱更长回答的问题,后续版本用回归校正长度偏差;WildBench 则从真实对话中采样,并要求 judge 先依据 checklist 分解标准。
因此,可靠的开放问答评测应同时保存 prompt、两侧回答、judge 身份或版本、rubric、位置随机化和原始判决。只保留一个最终 win rate,会让偏差无法追溯。
Agent 评测
Agent 不是单独的语言模型,而是模型与 scaffold 的组合。scaffold 决定如何规划、何时调用工具、怎样读取观察结果、如何保存记忆、何时重试或委派子任务。评测 Agent 时,测到的自然也是整个闭环,而不是纯模型权重。
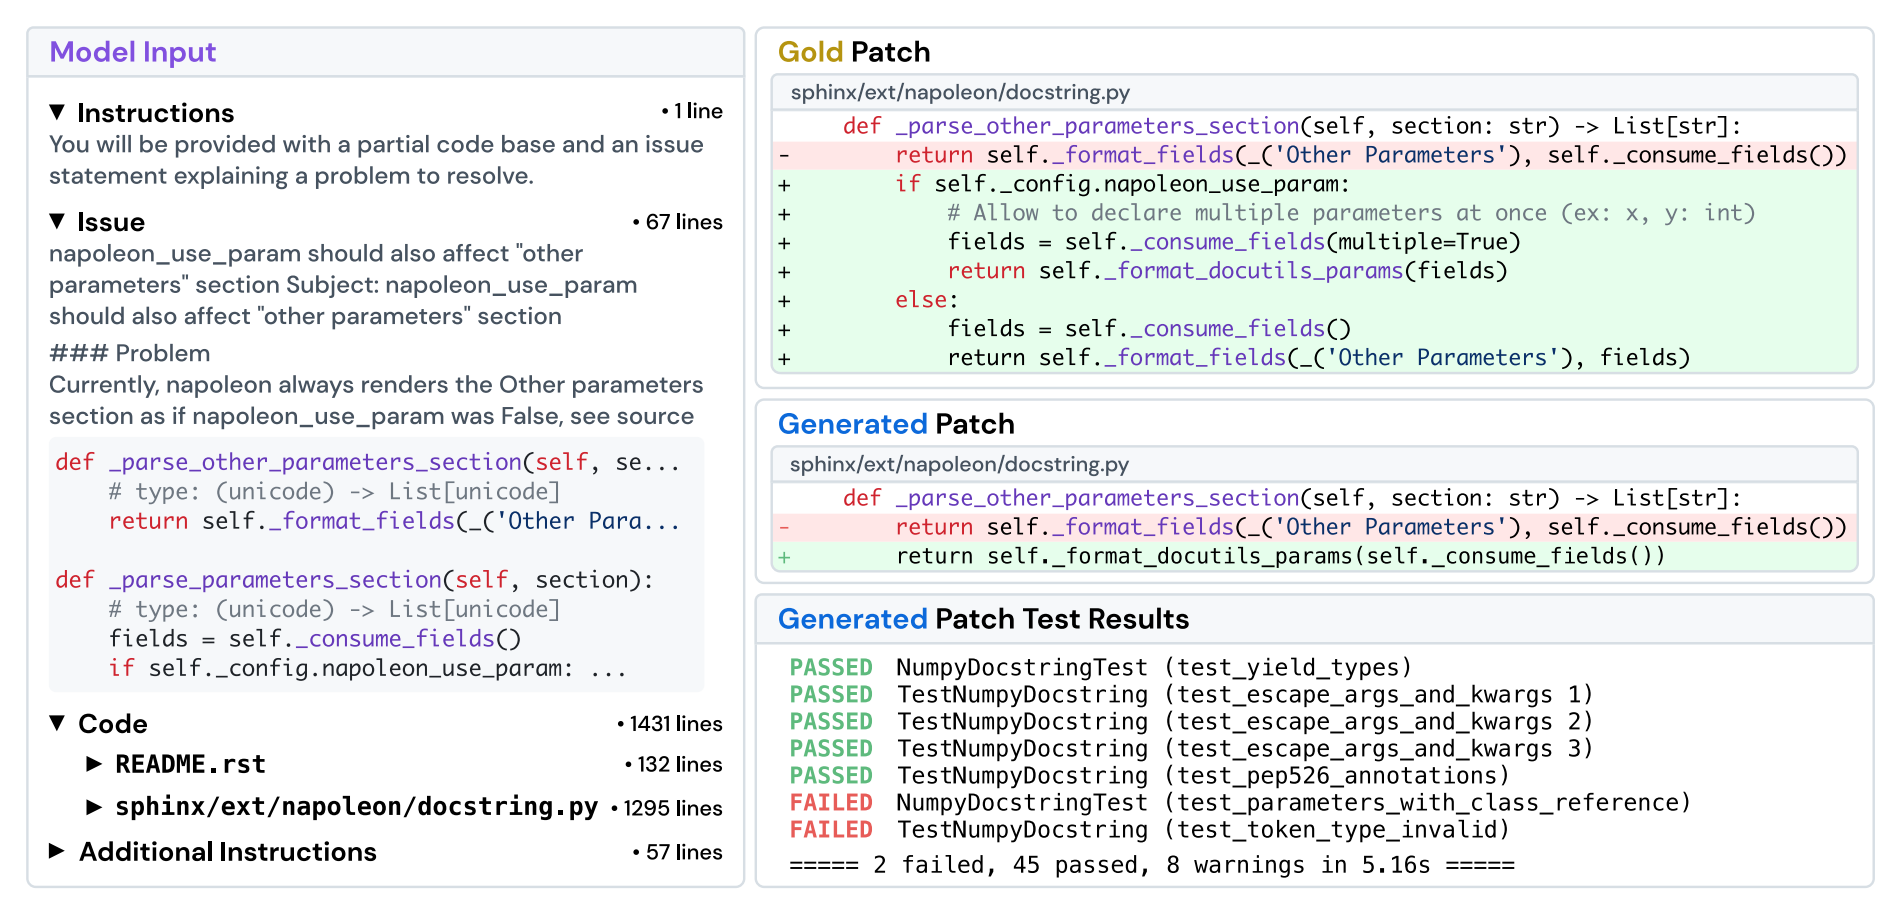
SWE-bench 给系统一个真实代码库和 issue,要求生成补丁,再用测试判断任务是否完成;Terminal-Bench 把任务放进通用终端环境;CyBench 使用 CTF 安全题;MLE-bench 则用 Kaggle 竞赛覆盖数据处理、训练和提交。这里的指标不再是回答像不像参考文本,而是代码是否通过测试、环境状态是否正确、得分是否达到阈值。
这种可执行判据更接近真实结果,却也带来更严格的可比性要求。把 Agent benchmark 的讨论进一步落到工程实践,还应记录工具集合、网络权限、context limit、时间限制、token 预算、并行子 Agent 数量、采样温度、重试次数和 scaffold 版本。否则所谓“模型升级”可能只是给了更多计算预算或更好的代理框架。
测试本身也可能有洞。测试覆盖不足时,错误补丁也会通过;环境不稳定时,正确方案可能失败;任务描述含糊时,gold patch 也不代表唯一解。SWE-bench Verified、Platinum 精校版 benchmark 和 trace inspection 的意义,就是把 benchmark 当成需要持续维护的软件系统,而不是永远正确的数据文件。
纯推理与安全:评测对象会从能力扩展到边界条件
ARC-AGI 尝试把推理能力从世界知识和语言记忆中分离出来:每个网格任务都有独特规则,人类容易理解,但模型不能只靠背诵事实。它清楚暴露了预训练语言模型与推理型系统之间的差距;同时也要承认,“完全分离知识与推理”本身很难,任务仍受人类认知方式和界面设计约束。
安全评测面对的是另一类抽象概念。HarmBench 基于 510 项违反法律或社会规范的有害行为测试模型;AIR-Bench 从监管框架和公司政策构建 314 类风险、5694 个 prompts。此处没有跨文化、跨地区都唯一正确的安全标尺:法律、社会规范和产品场景都会影响判定。网络安全 Agent 还具有典型 dual-use 特征,同一能力既能用于入侵,也能用于授权渗透测试。
因此,安全评测不应只报一次平均拒答率。至少要分别测正常请求上的过度拒答、攻击请求上的防护、对多轮和工具调用的鲁棒性,以及失败后的实际影响。能力更强与风险更低不是同一个轴。
生态有效性:benchmark 像不像真实使用
Ecological validity 关心:评测环境、任务与参与者分布,在多大程度上代表模型部署后的现实世界。GPQA 很难,但普通用户很少每天回答博士考试题;Arena 使用真实 prompt,却无法控制人群和任务分布。难度高不等于现实性高。
GDPVal 从美国 GDP 占比较高的 9 个行业中选择 44 种职业,由平均约 14 年经验的专业人士提供真实任务与交付物;MedHELM 从 29 位临床医生收集 121 个临床任务;Clio 则用隐私保护的聚合方式分析真实用户如何使用模型。这些方向都在把评测从“答题”推向“交付工作成果”。
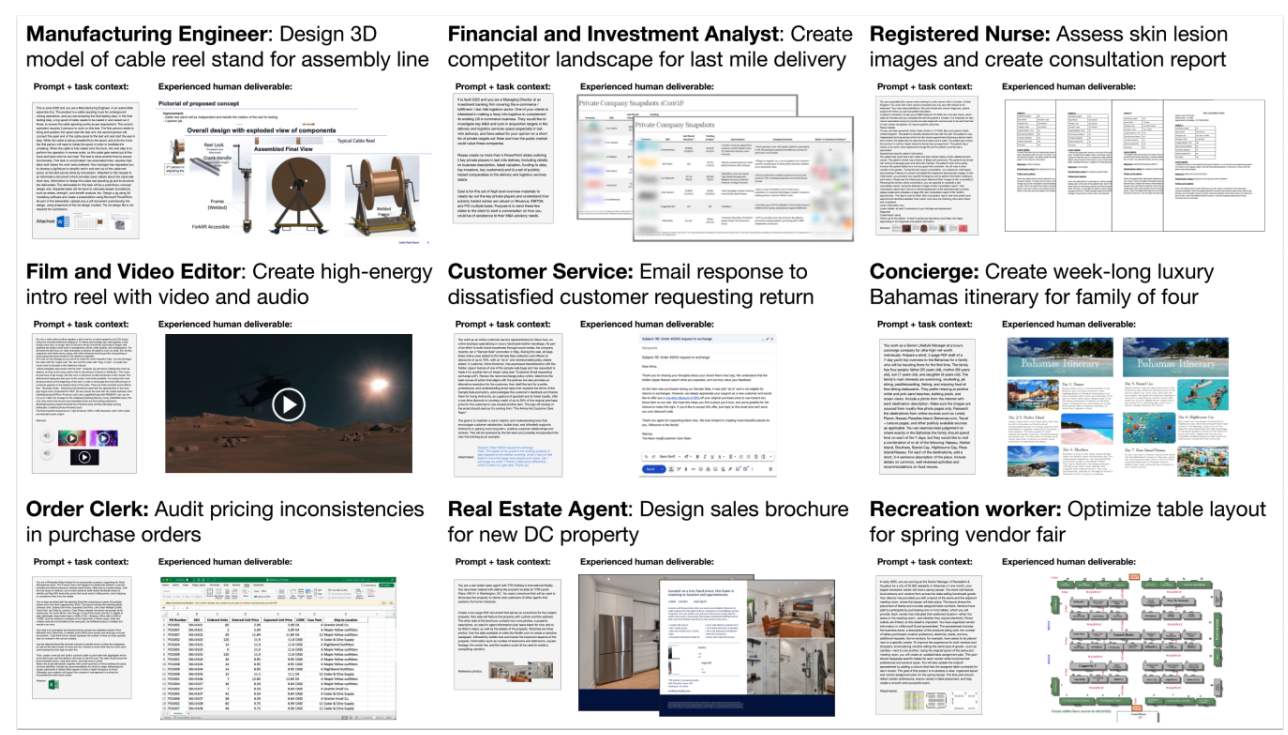
但越真实的数据通常越敏感。内部代码、客户对话、临床记录和个人写作最能揭示部署风险,也最难公开复现。现实性、隐私、可复现性与开放性之间没有免费午餐。一个成熟的评测栈通常需要公开 benchmark、私有回归集、在线观测和人工审计共同组成,而不是押注单一排行榜。
有效性审计:分数是否真的来自你想测的能力
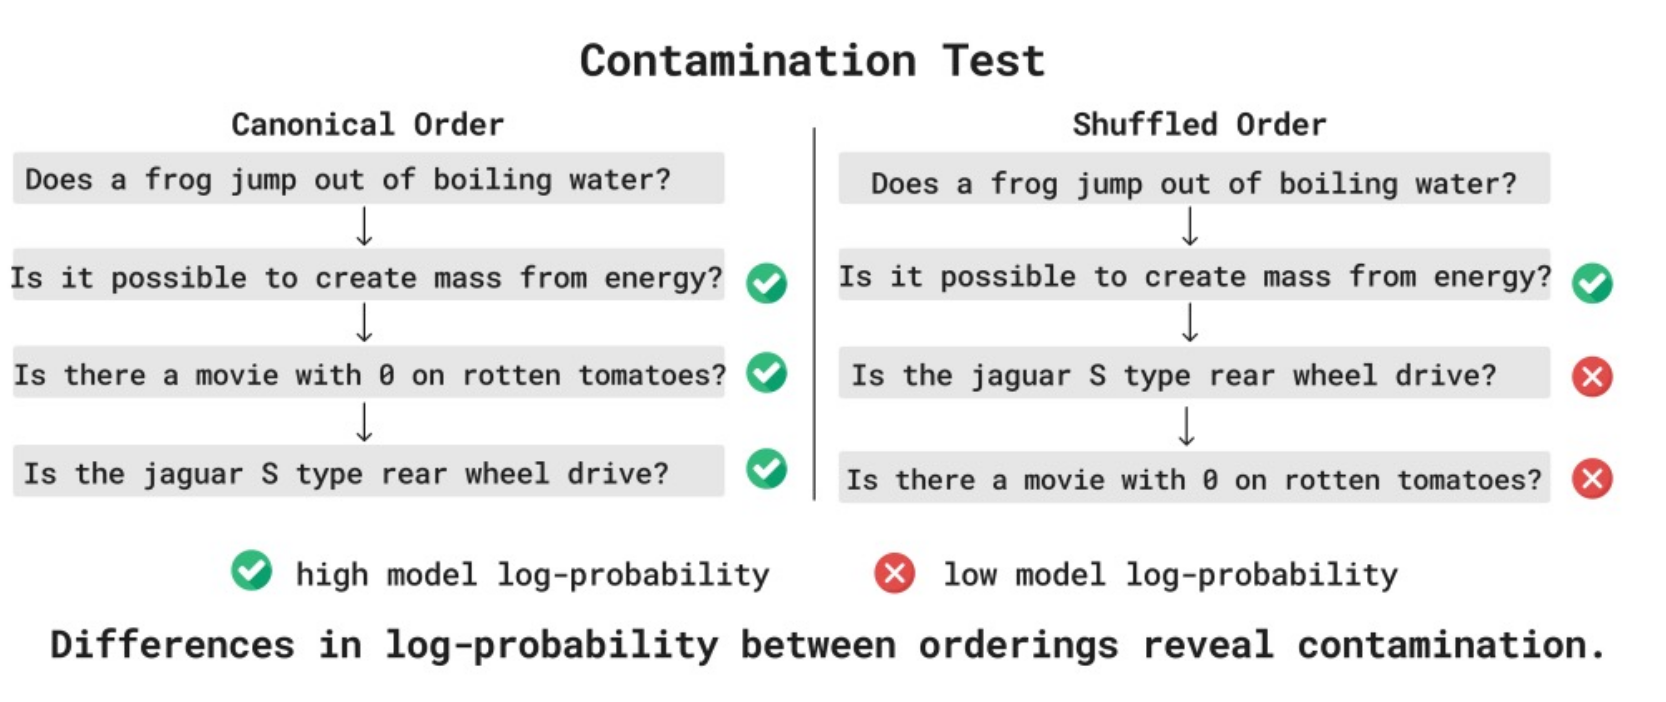
**训练—测试污染。**现代模型在互联网规模语料上训练,而数据清单往往不公开,传统的干净 train/test split 不再可靠。可以从模型输出中寻找记忆痕迹,例如比较 benchmark 样本按规范顺序与打乱顺序出现时的 log-probability;也可以要求模型提供者披露 overlap、持续使用新鲜题目,或保留从未公开的私有评测集。但这些都只是降低风险:时间戳可能被转载破坏,私有集也会因长期调参而被间接过拟合。
**数据集质量。**错误答案、歧义题、过弱测试和泄漏线索都会让分数偏离真实能力。高质量评测需要像代码一样做版本管理、问题复核、覆盖率分析和缺陷修复,并保留从原始数据到 Verified/Platinum 精校版 benchmark 的变更记录。
**指标与目标错位。**一个指标可以非常稳定,却测错了东西。例如 judge 一致偏爱长答案时,win rate 很可靠地测出了“长度偏好”,却没有测出正确性;单元测试覆盖不全时,pass rate 可靠地测出了“通过现有测试”,却不是“完整修复问题”。
如果两个模型的差异与置信区间同量级,就不应宣布明确胜负。开放问答和 Agent benchmark 往往还存在 prompt、judge、repository 和随机种子的分层相关性,更适合按任务单元做 bootstrap,并报告多次运行的方差,而不是把每个 token 或每次 retry 当成独立样本。
评测对象
传统机器学习研究经常固定训练集、测试集和算力,比较的是 method:新的架构、优化器或训练算法是否更有效。今天的大模型排行榜更多比较 model/system:训练数据、数据清洗、预训练、后训练、推理策略和工具可能全部不同。Agent 排行榜又增加 scaffold、环境和预算。
评测对象 |
应尽量固定什么 |
允许变化什么 |
结论可以说到哪里 |
|---|---|---|---|
Method |
数据、模型规模、算力、评测协议 |
算法或实现方法 |
该方法在受控条件下是否更有效 |
Model / system |
prompt、解码、工具权限、成本口径 |
模型与其默认服务栈 |
哪个可用系统更适合此任务分布 |
Agent |
环境、工具、预算、时间、重试、成功判据 |
模型与 scaffold,或其中一项 |
哪套完整 Agent 配置更能完成任务 |
如果规则没有声明,就无法判断提升来自模型、更多 test-time compute、额外工具,还是 benchmark 特化。nanoGPT speedrun 是一个很好的 method 评测范式:固定数据和目标 validation loss,比较达到目标需要的时间;它牺牲了一部分现实复杂度,却获得了清晰的算法反馈。
小结
把上述原则落到评测平台时,可以进一步整理成下面这份 evaluation contract。
**目的。**要支持模型选型、训练迭代、上线门禁、安全审计,还是学术能力比较?
**对象。**测 method、checkpoint、在线 API,还是 model + scaffold + tools 的 Agent?
**任务分布。**用户是谁,输入从哪里来,难度、语言、长度和长尾怎样分层?
**协议。**固定 prompt template、few-shot、CoT、工具、采样参数、预算、timeout、重试与并发。
**判分。**优先使用可执行结果;开放任务用 rubric 和 pairwise,并对 judge 做位置、长度和自偏好审计。
**统计。**报样本量、置信区间、随机种子、多次运行方差和失败类型,不只报一个平均分。
**有效性。**检查污染、题目质量、测试覆盖、数据版本和指标是否与目标一致。
**现实性与成本。**同时报告质量、延迟、吞吐、价格、资源预算和隐私边界。
**持续维护。**保存原始回答与 traces;版本化数据和 scorer;用线上失败反哺私有回归集。
最终的结果不应该只是一张总榜,而是一张 scorecard:核心能力、安全、成本、延迟、长尾、失败类型和适用边界并列呈现。只有这样,评测才能从“证明模型很强”变成“帮助下一次工程决策”。
评测会反过来塑造模型:团队优化什么指标,数据和训练资源就会向哪里移动。若指标过窄,系统会学会赢得 benchmark,而不一定学会解决真实问题。