RLHF - 强化微调
SFT 需要预先给定目标回答,这些回答可以来自人工、教师模型、规则系统或验证器筛选。人类亲自撰写的示范,与人类从多个候选中更偏好的回答并不总一致。偏好学习把监督信号从单个目标序列改成比较或评分;若信号来自程序化可验证奖励,则属于 RLVR,应与本章讨论的 RLHF 区分。这个变化带来了更强的控制力,也把标注者偏见、代理奖励误差和优化过度一起带进系统。
从 imitation 到 optimization:为什么示范不足以表达偏好
给定 prompt \(x\),SFT 观察一个目标回答 \(y\) 并最大化其似然;偏好学习则可以观察同一 prompt 下的 \(y_w\) 与 \(y_l\),知道前者被选为 chosen、后者被标为 rejected。比较标签表达的是相对关系:标注者不必亲自写出最佳摘要,只要能判断两个候选哪个更清楚、更准确或更符合任务。
新闻摘要实验给出了一个很直观的 generation–value gap。六位标注者比较自由撰稿人摘要与 Instruct-Davinci 摘要时,总体结果几乎是 \(50.4\%\) 对 \(49.6\%\),但不同标注者的偏好方向明显不同,整体一致性只有 \(\alpha=0.07\)。这既说明“会评价”与“会写出”不是同一个能力,也说明偏好标签不是脱离人群与规则的客观真值。
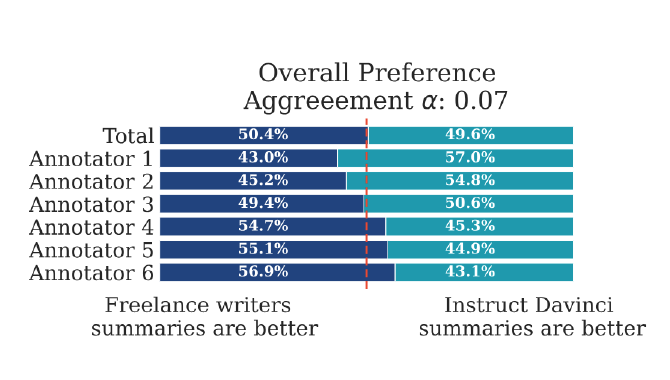
因此 preference dataset 的核心不只是 chosen/rejected 两列,而是一份评测合同:谁在标、按什么维度判断、能否平局、是否允许查证、冲突怎样仲裁、样本来自什么生成策略。缺少这些信息,同一份 pairwise 数据可能同时混入事实性、风格、价值倾向和长度偏好,最终很难解释模型为何改变。
偏好数据怎么采
标准流程从 prompt 分布出发,为每个 prompt 用当前策略采样多个候选,再构造成对比较或排序任务。候选太相似,标签信息量低;差异太大,标注者只会学习挑出明显坏答案。采样温度、模型 checkpoint、候选数量和长度上限都会改变比较难度,也会改变训练最终覆盖的分布。
一条可审计的偏好记录至少应保存 prompt、两侧完整回答、展示顺序、生成模型与采样参数、标注维度、标注者或 judge 版本、选择结果、置信度/平局、查证记录和时间。为减少位置偏差,应随机交换左右顺序;为估计噪声,应设置重复样本、gold questions 和多标注者重叠;涉及代码、数学、医学或事实判断时,还需要测试、检索或专家复核,而不是只让标注者凭阅读流畅度选择。
成本会影响数据分布。通用众包容易扩规模,却难保证复杂事实核验;专家更可靠,但昂贵、稀缺且依然可能分歧。人口结构也会改变价值与政治类问题的标签分布。因此需要按任务类型路由标注者,单独报告分群一致性,并允许“都不好”“平局”“证据不足”,而不是把所有判断强压成一个二元标签。
人类反馈不是金标准
低质量反馈最危险的地方,不只是总体准确率稍低,而是会系统性漏掉某类错误。Hosking、Blunsom 与 Bartolo 比较众包标注和专家分析后发现,在其研究设置中,众包者更容易低估事实性与内部一致性错误,同时对格式等表层特征的敏感度不同。这意味着简单增加标注人数,未必能消除共享盲点。
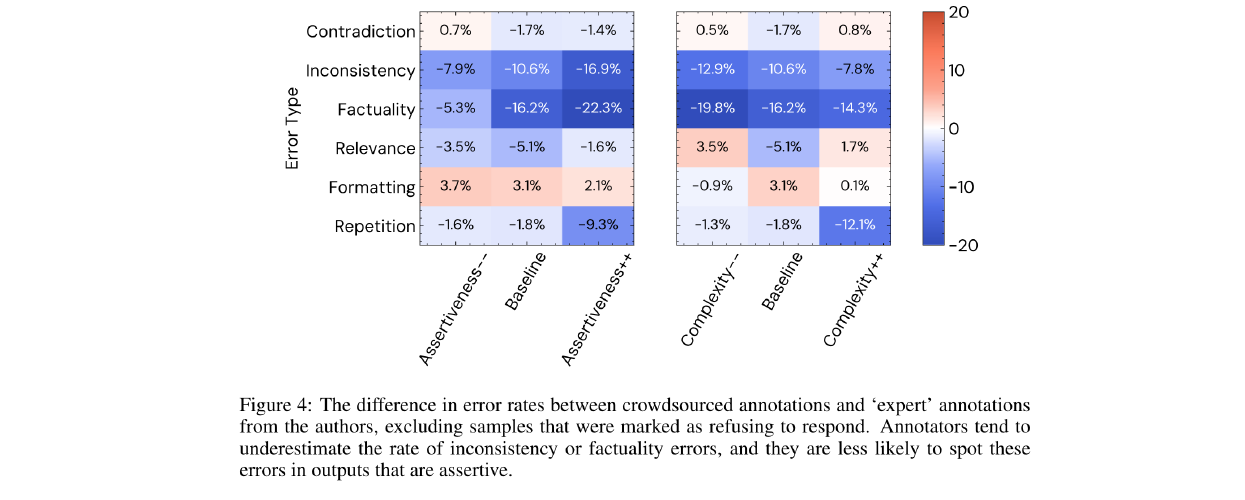
如果事实核验困难而风格判断容易,奖励模型就会优先学到长度、断言语气、列表结构等代理特征。之后策略会主动放大这些易得分特征,形成 feedback loop。质量控制应按错误类型分层:格式可以自动校验,代码可以执行测试,事实可以检索交叉验证,主观风格再交给人类;不能把所有维度都压进一句“总体更好”。
AlpacaFarm 实验给出系统级 Spearman 相关 \(0.98\) 与 \(R^2=0.87\),这说明强模型可以高效近似一套给定评审协议。但系统排序相关性高,不等于逐样本判断接近完美,更不等于能替代领域专家。AI judge 还可能偏爱自己的写作风格、受提示词和位置影响,或与被评模型共享错误。
AI feedback 与 Constitutional AI
AI feedback 的价值在于扩展候选批改、规则检查和一致性筛选,而不是制造无成本真值。UltraFeedback 等数据集让强模型依据多个维度批评并评分候选,Constitutional AI 则把抽象原则变成两阶段闭环:先让模型对可能有害的回答进行 critique 与 revision,用修订结果做 SFT;再让 AI 按同一“宪法”比较候选,训练偏好模型并进行 RLAIF。
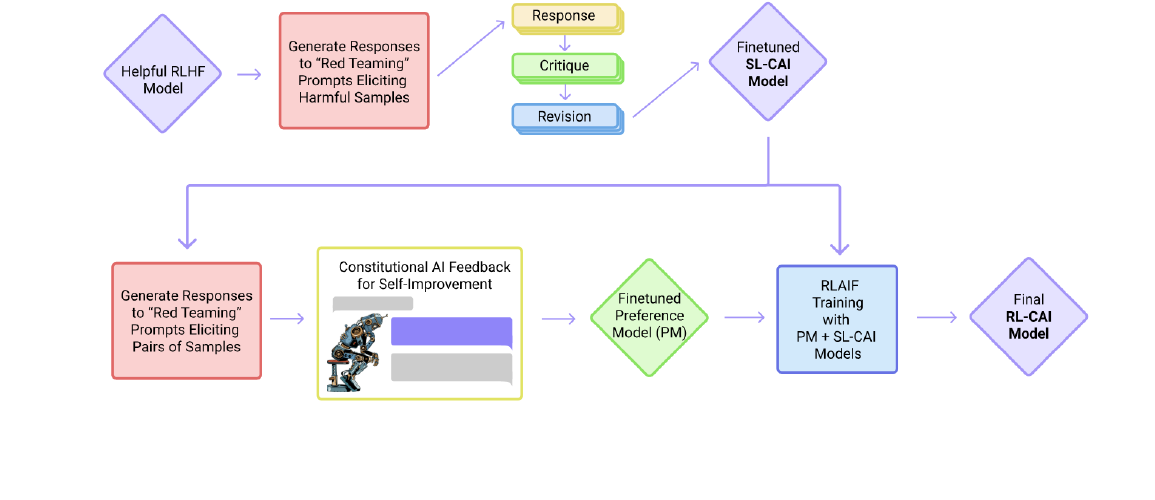
这类方法把标注瓶颈从“逐条人工写答案”转成“设计原则、生成挑战样本、审计 judge”。它仍然需要人类确定规范、检查边界案例并监控分布漂移。若原则含糊、相互冲突,或 judge 无法识别事实错误,规模越大只会更稳定地复制同一种偏差。
奖励模型:把成对偏好压缩成一个标量差
经典 RLHF 先训练奖励模型 \(r_\phi(x,y)\),用一个标量表示回答在给定 prompt 下的效用。Bradley–Terry 模型把 chosen 胜过 rejected 的概率写成:
对应的成对负对数似然为:
这个形式简洁,但假设很强:每个回答可以压缩为一个标量,偏好只依赖两侧奖励差,而且二元比较足以表达价值。它不能自然表示平局、偏好强度或“答案 A 更准确但答案 B 更安全”的多维冲突。把不同人群的标签直接混合,也未必仍对应一个统一、传递的效用函数。
奖励只由差值确定,因此对同一 prompt 加上任意常数 \(c(x)\) 不会改变偏好:\(r'(x,y)=r(x,y)+c(x)\)。这个看似不起眼的不可辨识性,正是后面 DPO 推导中归一化常数可以在同一 prompt 的 chosen/rejected 差里消去的原因。
PPO-RLHF:最大化奖励,同时不让策略跑得太远
如果只最大化奖励模型分数,策略会主动搜索奖励模型没有覆盖的分布区域,并利用其漏洞。PPO因此加入相对冻结参考策略 \(\pi_{\mathrm{ref}}\) 的 KL 正则:
等价地,对采样到的回答使用 shaped reward:
\(\beta\) 控制“追求偏好”与“留在参考分布附近”的权衡。KL 项并不等同于纯 entropy bonus,因为 \(-D_{\mathrm{KL}}(\pi\Vert\pi_{\mathrm{ref}})=H(\pi)+\mathbb{E}_{\pi}[\log\pi_{\mathrm{ref}}]\):它既包含鼓励熵的成分,也把概率拉回参考策略的高密度区域。InstructGPT 的 PPO-ptx 还混入预训练目标,进一步缓解能力退化;普通 PPO 可以不含这项。
序列奖励通常在生成结束后才得到。朴素 REINFORCE 使用:
这个估计往往方差很高,所以实际系统会训练 critic,计算 advantage,并使用 GAE、whitening 等手段降方差。PPO 再对新旧策略的 probability ratio 使用 clipped surrogate:
clipping 不是永久截断模型概率,而是当更新幅度超过信任区间时,不再让 surrogate objective 奖励继续沿同一方向放大。完整 LLM PPO 还包括 value loss、value clipping、KL controller、rollout engine 和多模型显存管理,复杂性主要来自在线采样与状态同步,而不只是一条公式。
DPO:把 KL 正则化偏好优化改写成离线分类损失
DPO 的出发点仍是上面的 KL 正则化奖励目标。若对每个 \(x\) 在所有可能策略构成的非参数空间中求最优,且归一化常数有限,则最优策略满足:
反解奖励:
把这个表达式代入 Bradley–Terry 模型。chosen 与 rejected 共享同一 prompt,因而 \(\beta\log Z(x)\) 在奖励差中抵消,得到 DPO 损失:
定义隐式奖励 \(\hat r_\theta(x,y)=\beta\log\frac{\pi_\theta(y\mid x)}{\pi_{\mathrm{ref}}(y\mid x)}\) 后,DPO 直接增大 chosen 与 rejected 的 log-ratio 差,也就是隐式奖励差。受参数共享与序列归一化影响,它不保证 chosen 的绝对 log-probability 或 log-ratio 单调上升,也不保证 rejected 单调下降;梯度权重则由当前隐式偏好预测误差决定,排反越严重,权重越大。因此它不是固定强度的“chosen 做 SFT、rejected 做反向 SFT”。
DPO 不再单独训练和部署显式奖励模型,也不运行 on-policy rollout—update 外循环,工程上像一个离线二分类损失;但 policy/reference 的 log-ratio 仍定义了隐式奖励,目标也来自 KL 正则化 RLHF。它与理想化 RL 目标的联系依赖固定且有充分 support 的 reference policy、Bradley–Terry 偏好假设、同 prompt 配对、适当的数据分布和非参数最优可达等条件。有限模型、离线数据与 SGD 下,不能把 DPO 写成“与 PPO 完全等价”。
现代后训练不是一次 DPO,而是数据与模型共同迭代
真实配方常把多种方法连接成闭环。以 Tülu 3 为例:先为收集到的 prompt 生成 \(K\) 个候选,用奖励模型做 rejection sampling,得到更强的 SFT 数据;再混入按能力定制的数据训练 SFT 模型;同时构造通用和专项成对偏好做 DPO;最后把本轮最好的模型带入下一轮候选生成。这是 expert iteration:模型变强后,数据分布和难例也随之更新。
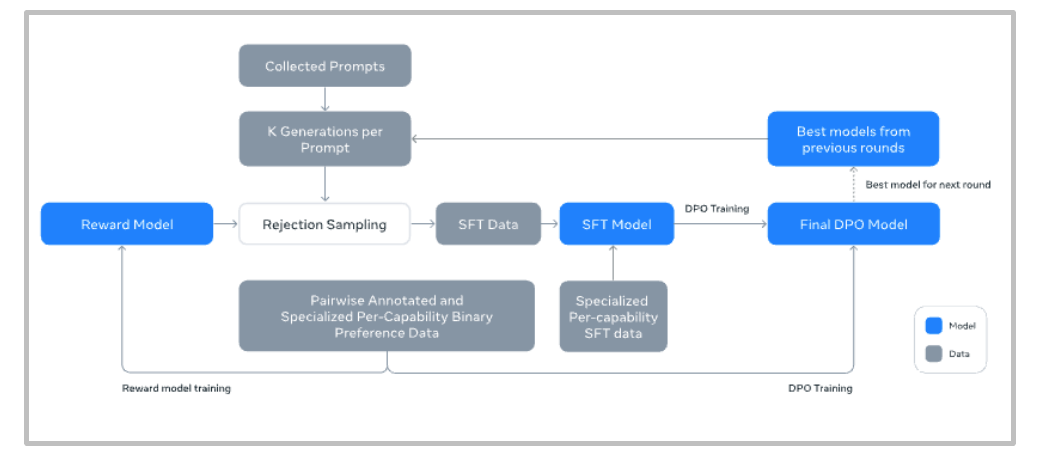
因此“PPO 还是 DPO”很少是孤立的算法选择。prompt 分布、候选生成温度、偏好数据、奖励模型、KL 系数、长度控制、SFT 起点与超参数都可能翻转结果。SimPO 等变体通过长度归一化策略 log-probability 并加入 margin,减少对 reference model 的依赖;length-normalized DPO 也试图削弱长回答天然累积更多 log-ratio 的效应。但长度归一化会改变隐式奖励尺度和归纳偏置,只有在相应数据与 length-controlled 评测下才知道是否更好。
奖励过优化、长度黑客与多样性下降
奖励模型是偏好的代理,不是偏好本身。策略优化初期往往会修复明显问题;继续推动 proxy reward 时,模型会越来越关注奖励模型的盲点,真实质量反而下降。这是 Goodhart 效应在后训练中的具体形式。
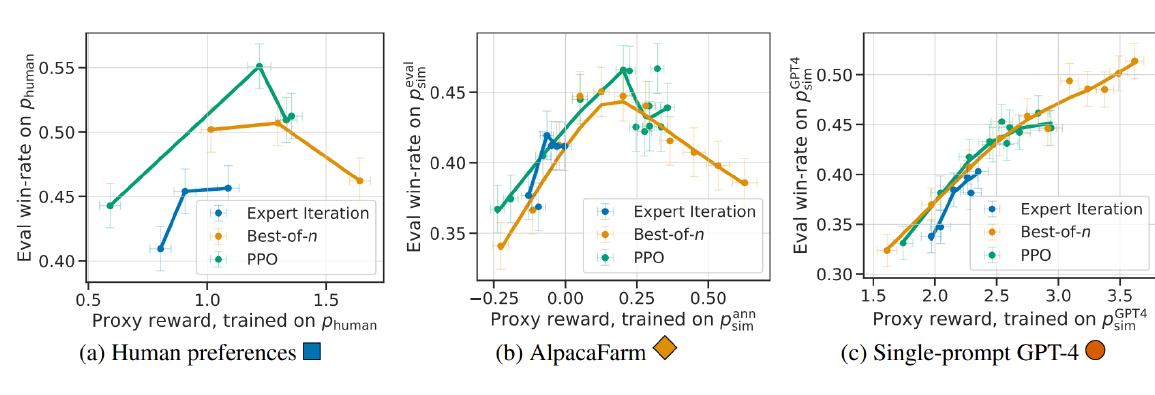
图中的 AlpacaFarm 实验显示:在人类偏好或带噪模拟偏好下,proxy reward 持续上升时,真实评测 win rate 会在峰值后回落;近乎无噪声的单提示 GPT-4 反馈下,关系更接近单调。它不是“所有 RLHF 必然先升后降”的定理,而是说明反馈噪声和分布外误差决定了可安全优化的距离。实践中应以独立 holdout judge、人工抽检和可验证任务监控真实效用,而不是只看训练 reward。
长度是常见奖励黑客:更长回答看起来更完整,也更容易覆盖评分 rubric,于是模型用 token 换分。RLHF 的收益不能被简化成“全是变长”,但评测必须同时报告 raw win rate、length-controlled win rate、平均长度和事实正确性。类似地,应区分 token entropy 下降、语义多样性下降、风格趋同与真正的模式坍塌;它们相关,却不是同一个现象。
偏好优化后模型仍然定义规范化的 \(p_\theta(y\mid x)\)。问题在于,这个分布已经被“让高奖励回答更常出现”的目标重塑,生成概率不应直接解释为事实正确性的良好校准置信度。GPT-4 技术报告在一个特定 MMLU 子集上展示 base model 的 ECE 约 \(0.007\)、post-RLHF model 约 \(0.074\);它是需要监控校准退化的案例,不是任何偏好优化必然失准的定理。
小结:算法上限由反馈质量和评测合同共同决定
SFT 把预训练能力变成稳定接口,偏好优化则在多个可行回答之间重新定义“更好”。PPO 提供在线探索与显式奖励优化,代价是 rollout、critic 和稳定性工程;DPO 把特定假设下的 KL 正则目标改写为易实现的离线损失,代价是更依赖固定偏好数据的覆盖。它们不是互斥宗派,而是不同数据、预算与在线迭代条件下的工具。
可靠后训练需要闭环:明确评价维度,保存可追溯的比较数据,用人类、AI judge、专家和可执行验证器各自处理擅长的信号;训练时限制离参考分布的距离;评测时把事实、风格、长度、安全、多样性与校准分开;部署后继续收集失败样本并更新合同。优化器只能放大它收到的目标。反馈本身若含糊、有偏或容易被钻空子,算法越强,偏离真实意图的速度也可能越快。