可验证奖励强化学习(RLVR)
偏好优化解决的是“人更喜欢哪个回答”,可验证奖励强化学习(Reinforcement Learning from Verifiable Rewards,RLVR)则把问题换成“这个回答能否被程序判定为正确”。数学答案可以做符号等价检查,代码可以运行测试,结构化输出可以校验 schema,工具调用可以在环境中检查最终状态。验证器把昂贵而含噪的人类判断,替换成可重复、可扩展的反馈;但它并没有自动解决策略梯度的方差、目标偏差、长序列采样成本和奖励黑客。
本章沿着“奖励合同 → 在线采样 → 策略更新 → 系统吞吐 → 独立评测”这条链路,解释 RLVR 为什么有效、GRPO 为什么流行,以及哪些看似漂亮的训练曲线不能直接解释为新推理能力。
从偏好奖励到可验证奖励
给定问题 \(q\)、模型生成的完整回答 \(o=(o_1,\ldots,o_T)\) 和验证器 \(V\),最简单的 RLVR 奖励是二元结果:
训练目标是在问题分布 \(p_Q\) 上提高通过验证的概率:
这里的难点是奖励通常只在序列结束后出现。生成第 \(t\) 个 token 时,状态可以写成 \(s_t=(q,o_{<t})\),动作是 \(a_t=o_t\);但最终答案是否正确,要等数百乃至数万 token 之后才能知道。一次序列级奖励必须反向影响整条轨迹,这正是 credit assignment 与高方差的来源。
维度 |
RLHF |
RLVR |
|---|---|---|
主要反馈 |
人类或模型对回答的偏好、评分 |
程序、测试或环境对结果的验收 |
适合任务 |
帮助性、风格、安全等开放目标 |
数学、代码、形式化证明、结构化输出、可执行 Agent 任务 |
主要优势 |
能表达难以形式化的价值判断 |
便宜、可重复、可大规模重算 |
主要风险 |
标注噪声、奖励模型分布外失真 |
测试不完备、规范漏洞、环境污染与 reward hacking |
“可验证”也不等于“任务已经被完整定义”。只检查数学最终答案,会放过偶然猜中和不可读推导;只跑公开单测,会奖励针对样例硬编码;只检查工具调用成功,会忽略副作用与成本。可靠的奖励合同需要同时写清输入分布、可接受输出、验证器版本、超时与资源限制、部分得分规则以及失败原因。
PPO 基线:两个旧策略不能混为一谈
朴素 REINFORCE 直接用序列回报加权整条生成轨迹的 log-probability:
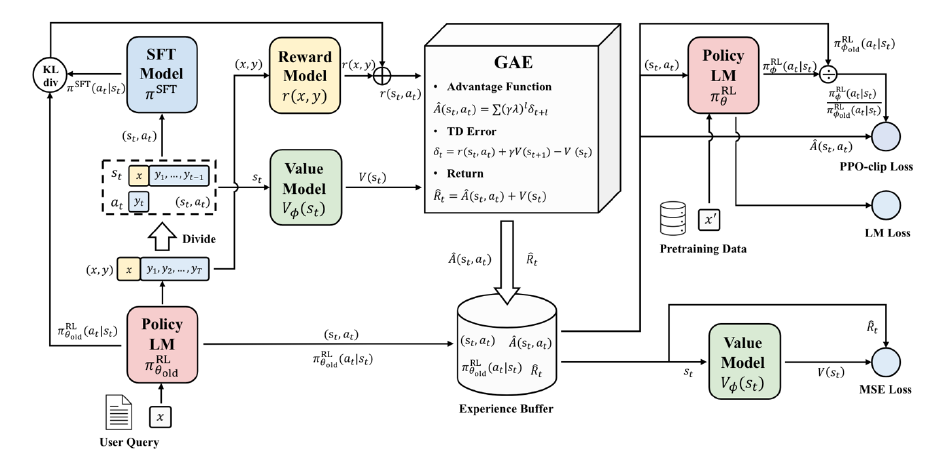
基线 \(b\) 不改变理想期望梯度,却可以显著降低方差。PPO 通常再训练一个 value model 来估计状态价值,用 GAE 构造逐 token advantage,并对新旧策略概率比使用 clipped surrogate:
这里必须区分两个常被都叫作“旧模型”的对象。\(\pi_{\mathrm{old}}\) 是产生当前 rollout 的行为策略,分母用于重要性比率;完成一轮更新后它会刷新。\(\pi_{\mathrm{ref}}\) 则是 KL 正则的参考策略,通常在一个训练阶段内冻结:
\(\pi_{\mathrm{old}}\) 保证“用哪一批样本更新”可追踪,\(\pi_{\mathrm{ref}}\) 则表达“策略不要离某个参考分布太远”。两者可以在某个时刻参数相同,却承担不同数学职责。PPO clipping 也不是对真实 KL 或参数距离的硬约束;它只让采样点上的 surrogate 在比率越界后不再继续获得同方向收益,所以仍需监控实际 KL、clip fraction、熵和奖励。
PPO 的工程成本来自整条数据流:policy 生成 rollout,reward/verifier 给序列打分,value model 估计状态价值,GAE 构造 advantage,训练端再同步新权重。长回答让推理成为慢路径,policy、reference、value 和训练 optimizer state 还会共同占用显存;算法公式不长,稳定实现却并不轻。
GRPO:用同题多回答的相对成绩替代 critic
Group Relative Policy Optimization(GRPO)保留 PPO 的 rollout、probability ratio、clipping 和可选 KL 项,但移除 value model。对同一个问题 \(q\),旧策略一次采样 \(G\) 个回答 \(o_1,\ldots,o_G\),得到奖励 \(R_1,\ldots,R_G\),再用组内标准化构造 advantage:
同一回答的所有 token 通常共享同一个序列级 \(\hat A_i\)。正确且高于组均值的回答整体被增大概率,低于组均值的回答整体被压低概率。价值网络不再需要训练和存储,代价是每个问题必须采样多个回答,且 advantage 的尺度开始依赖同组回答的构成。
组均值包含样本自身,因此 \(R_i-\bar R\) 与严格的 leave-one-out baseline 只差一个有限组缩放。定义:
则有:
这个 \((G-1)/G\) 因子可以并入学习率,但除以随机的组内标准差不是同一回事:它会根据本组难度重新缩放问题权重。若一组奖励全为 0 或全为 1,中心化后的分子全部为 0;常见实现加上 \(\varepsilon\) 后得到的是零 advantage,而不是无限梯度。这样的 prompt 在该步没有直接学习信号。
一个 G=4 的手算:归一化如何悄悄改写权重
采用总体标准差,先看同一问题四个回答的奖励为 \([1,1,0,0]\)。此时 \(\bar R=0.5\)、\(\sigma_R=0.5\),标准化 advantage 为:
再看另一道更难的问题,四个回答只有一个正确,奖励为 \([1,0,0,0]\)。此时:
稀有的正确回答因此得到比“二对二”情形更大的正向系数。这可以被解释为强调有信息量的边界样本,也可以被解释为 question-level difficulty reweighting;它不是免费的数值稳定技巧。二元奖励下,组内成功率决定了 advantage 尺度,采样数 \(G\)、温度和题目难度会共同改变实际优化目标。
原始 GRPO 还常对每条回答先做 token 平均:
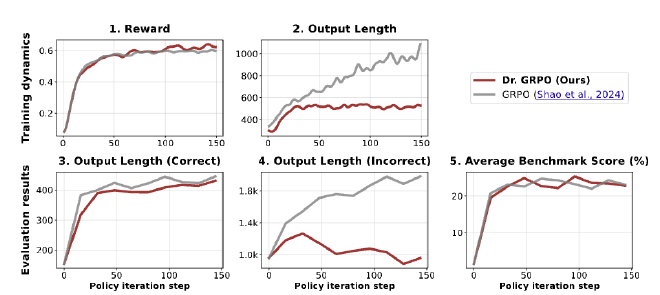
这会让短正确回答的每个 token 获得更强正向更新,而长错误回答的负向信号被摊薄,形成 response-level length bias。Dr. GRPO 的核心修正是去掉组内标准差归一化,并以同一生成预算阶段固定的 \(L_{\max}\) 取代每条回答自己的长度:
在 on-policy、未 clipping、把 reward 视为 stop-gradient 等理想 policy-gradient 条件下,中心化 reward 与 RLOO 只差常数缩放,可以讨论无偏性。完整训练若包含重复 epoch 带来的 off-policy 数据、clipping、KL、有限批次和实现级 mask,则不能把“无偏”扩大成对整个训练过程的无条件保证。固定 \(L_{\max}\) 消除的是由“除以自身长度”引入的特定偏差,也不意味着模型从此没有任何长度偏好。
Dr. GRPO 在 Qwen2.5-1.5B、MATH 训练题和五个数学评测的论文设置中,使错误回答的长度明显下降,并保持或改善平均准确率。这个结果支持“原始归一化会影响长度动态”,但不能推出所有长 CoT 都是伪象,也不能把某一次长度增长直接认定为新推理能力。
DeepSeek-R1:纯 RL 实验与可用模型配方是两件事
DeepSeek-R1-Zero 从 DeepSeek-V3-Base 出发,不先做 reasoning SFT,使用数学、代码和逻辑任务的规则奖励训练 GRPO。奖励主要由两部分组成:accuracy reward 检查最终答案或测试结果,format reward 检查推理与答案是否放入约定标签。它没有用神经 process reward model 来逐步判断推理过程。
训练中出现更长的回答、验证、反思和改换路线,是 RLVR 能从已有生成分布中筛选有效轨迹的重要证据;却不能仅凭“wait”等词频突增或长度上升,断言模型从零获得了人类式顿悟。DeepSeek-V3-Base 的预训练已经包含大量数学与代码内容,后续分析也观察到基座模型本身能够产生自我修正模式;同时,原始 GRPO 的长度归一化会混入额外增长压力。更可靠的因果证据应来自基座行为审计、目标函数消融、长度受控评测和多随机种子复现。
面向产品的 DeepSeek-R1 并不是 R1-Zero 的直接同义词,而是一条多阶段管线:
先用数千条可读的 long-CoT cold-start 数据初始化推理风格;
进行第一阶段 reasoning RL,并加入语言一致性奖励以减轻中英混杂;
通过 rejection sampling 构造约 60 万条推理样本,并混入约 20 万条非推理样本做 SFT;
再进行覆盖 reasoning 与通用偏好的第二阶段 RL;随后用前述约 80 万条推理与非推理样本蒸馏较小模型。
这条管线说明,RLVR 擅长在可验证域里探索,SFT 负责可读性、格式与能力覆盖,通用 RLHF/RLAIF 再处理无法程序化判定的帮助性和安全性。R1-Zero 回答“没有 reasoning SFT 时会发生什么”,R1 回答“怎样把这种探索变成可用模型”;二者不能用同一个结论概括。
Kimi k1.5:长上下文 RL 首先是采样与调度问题
Kimi k1.5 把 RL context 扩展到 128K,并把注意力从单一损失函数转向 rollout 的系统成本。长 CoT 使不同样本的生成时间差异巨大:如果同步等待整批完成,短样本的 GPU 会被长尾拖住;如果每轮都从头生成 128K 轨迹,绝大部分时间又消耗在重复前缀上。其 partial rollout 复用先前轨迹片段,只对当前片段执行新的 on-policy 计算,并允许某些复用片段不进入 loss,从而缩短迭代时间。实现时必须记录每段由哪个 policy version 生成,明确哪些 token 参与梯度,不能把复用简单等同于完全 on-policy。
题目采样也被纳入优化。Curriculum sampling 先训练容易题,再逐渐转向困难题;prioritized sampling 记录问题 \(i\) 的历史成功率 \(s_i\),按 \(1-s_i\) 提高薄弱题目的采样概率。它能减少反复训练已解决问题,但也可能长期冷落高成功率中的退化样本,因此需要最低采样概率和独立回归集。
Kimi 还显式加入后期 length reward。对同题组内回答,定义:
正确回答使用 \(\lambda_i\):较短得到正奖励,较长得到负奖励;错误回答使用 \(\min(0,\lambda_i)\):不会因为短而获得正奖励,但超过组内长度中点后会受罚。只有所有回答长度相同才把该项置零。这个设计是有意加入的准确率—成本权衡,与原始 GRPO 中无意出现的长度归一化偏差不同;报告也说明它在训练后期才启用,因为过早压缩会伤害探索和性能。
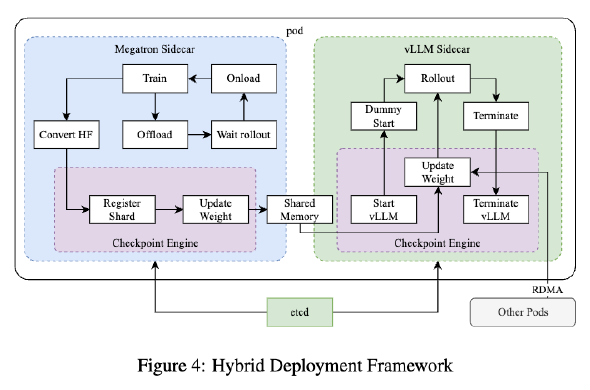
系统侧采用 Megatron 训练与 vLLM rollout 的混合部署,通过 checkpoint engine、共享内存与 RDMA 交换权重,并让异步 rollout worker 吸收长短轨迹不均。论文在其集群配置上报告训练切换到推理少于一分钟、反向切换约十秒。
Qwen3:3995 对 query–verifier 不等于“小计算量”
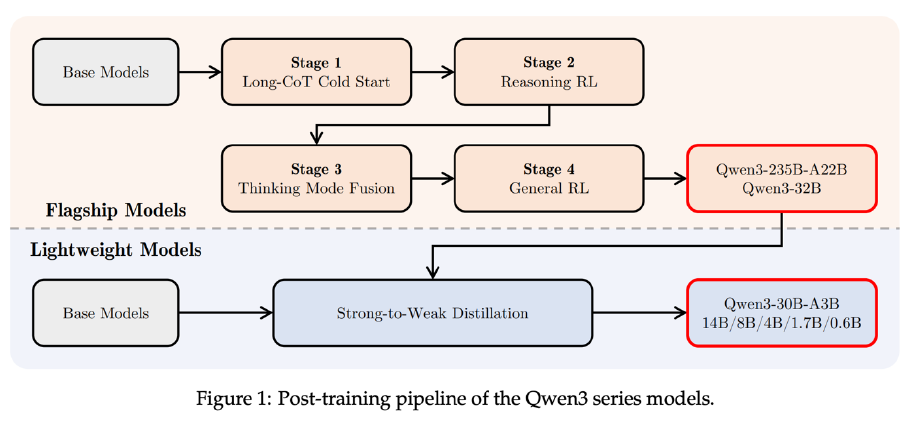
Qwen3 的旗舰模型采用四阶段后训练:Long-CoT Cold Start、Reasoning RL、Thinking Mode Fusion 和 General RL。第二阶段披露了 3,995 对 query–verifier,并用 GRPO 更新模型;样本选择要求未出现在 cold start、对当前模型可学习、尽可能有挑战且覆盖多个子领域。这里的“低数据”指独立 query–verifier 对较少,不代表生成 token、rollout 数或 GPU 时间少——每题的大 batch、多次采样和长推理仍然可能非常昂贵。
第三阶段把 thinking 与 non-thinking 数据混合,让一个模型可以通过 chat template 切换模式;第四阶段再强化通用任务、指令遵循和 Agent 能力。轻量模型没有逐个完整重复四阶段,而是从旗舰模型做 strong-to-weak distillation。这个配方把“能推理”“何时推理”“推理多久”拆成了不同训练问题。
Thinking budget 则把一部分训练成果暴露成推理时控制旋钮。Qwen3-235B-A22B 的报告在 AIME 2024、AIME 2025、LiveCodeBench v5 和 GPQA Diamond 上展示了从 1K 到 32K thinking tokens 的平滑提升;这证明该模型和这些评测中存在可利用的 test-time scaling,却不意味着每个任务都应盲目生成 32K token。生产决策仍要比较 pass rate、平均 token、尾延迟和单位成功成本。
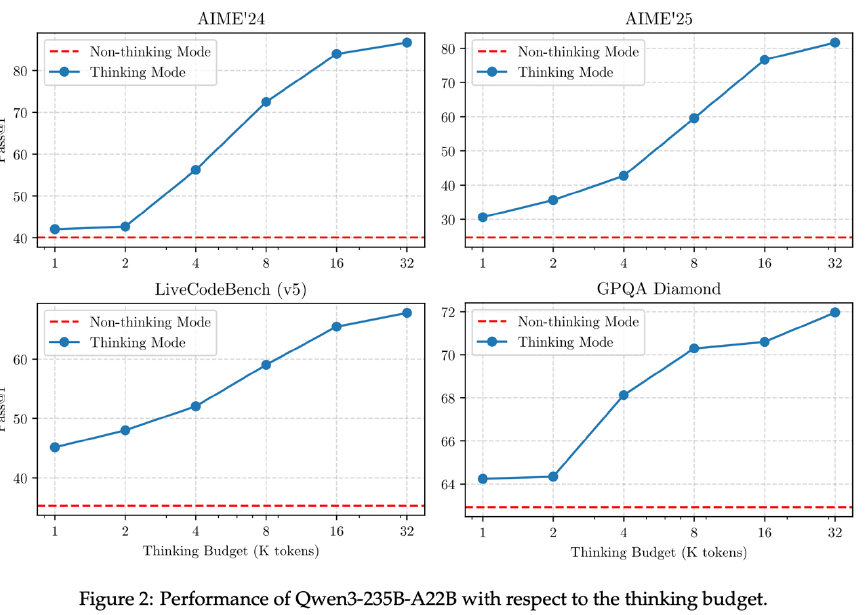
四阶段之间也存在能力交换:thinking mode fusion 和 general RL 改善通用交互与模式切换,并不保证数学、STEM 和代码指标全部同步上升。因此每阶段都应保留前一阶段的能力回归集,而不是只看最终平均分。
从答案验证器到 Agent 环境:奖励必须覆盖状态变化
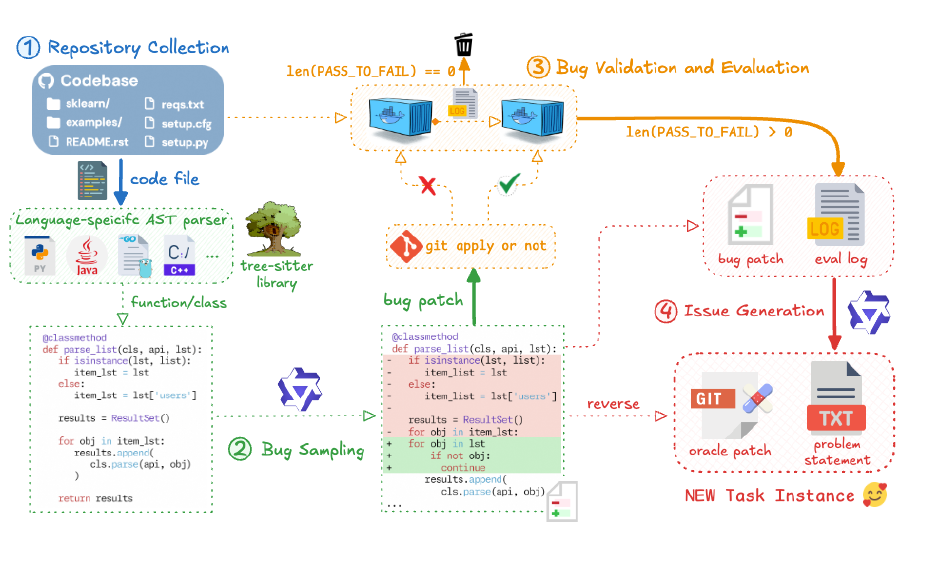
数学题的 verifier 可以只看最终表达式,代码和 Agent 任务却必须验证环境状态。一个可训练的软件工程样本至少包含可复现的仓库快照、依赖与构建脚本、问题描述、隐藏测试、资源限制和清理规则。模型产生 patch 或工具轨迹后,环境需要在沙箱中应用变更、运行测试并返回结构化结果;否则“命令执行成功”可能只代表进程退出码为 0,并不代表任务完成。
自动构造 SWE-bench 风格任务的一种路线,是从真实代码库抽取函数或类,采样一个能让既有测试失败的 bug patch,在隔离容器中确认修改前后确实发生 PASS→FAIL,再反向生成 issue 与 oracle patch。Qwen3-Coder-Next 管线把这种方法扩展到约 80 万个任务实例。规模本身不是质量保证:错误补丁若与问题描述不一致、测试过弱、仓库依赖失效或答案泄漏进上下文,模型会学会利用环境而不是修复软件。
Agent RL 还把 trajectory 变成一等数据:每次观察、工具调用、参数、返回值、环境版本和最终状态都要可重放。奖励最好拆成终局正确性、过程合法性、成本与安全约束;其中终局测试决定是否完成任务,过程项只用于约束危险操作或资源浪费,不能让“少调用一次工具”压过“真正修好问题”。
层 |
需要记录 |
最常见的假进步 |
|---|---|---|
问题与验证器 |
题源、去重、verifier 版本、隐藏测试、超时 |
训练集泄漏、测试覆盖不足、格式投机 |
采样 |
policy version、温度、每题 rollout 数、截断原因 |
只因采样预算增加而提高 pass@k |
优化 |
reward 分布、全同组比例、KL、entropy、clip fraction |
训练 reward 上升但有效梯度集中在少数题 |
长度与成本 |
正确/错误回答长度、TTFT、TPOT、单位成功 token |
用更长输出换取表面正确率 |
泛化 |
独立题源、环境时间切分、人工错误分析 |
记住模板、测试或仓库模式 |
落地 RLVR:把算法选择变成一套可审计实验
一轮可信的 RLVR 实验可以按五步推进。第一,先冻结任务与验证器版本,用 base/SFT policy 跑出 pass rate、reward 方差、全 0/全 1 组比例和错误类型;没有差异化奖励的题,增加训练步数也不会自动产生信号。第二,固定总生成 token 预算比较 SFT、rejection sampling、RLOO/GRPO 和 PPO,避免某个方法仅因采样更多而胜出。第三,把 \(\pi_{\mathrm{old}}\)、\(\pi_{\mathrm{ref}}\)、rollout 时间戳和权重版本写入日志,量化 off-policy 程度。
第四,至少同时画 reward、独立正确率、实际 KL、entropy、clip fraction、正确/错误回答长度、截断率和单位成功成本。若 reward 上升而隐藏测试不升,先审计 verifier;若正确率不变但错误回答越来越长,先审计 token 归一化;若大量组全对或全错,先调整题目采样或组大小。第五,用新的题源、不同 verifier、格式扰动和人工抽检做反事实测试,确认模型学到的是任务能力,而不是某个判分器的表面规则。
真正可扩展的 RLVR 闭环是:可学习的问题分布产生多样 rollout,版本化验证器给出可解释反馈,优化器在明确归一化下更新策略,系统持续测量采样成本与策略陈旧度,独立评测再检查是否泛化。缺少其中一环,更多 GPU 往往只会更快地放大奖励合同里的漏洞。
RLVR 最重要的贡献,是把一部分“模型是否做对”从主观偏好变成可执行实验。它让推理、代码和 Agent 能力获得高吞吐反馈,也迫使我们更精确地面对目标函数:group normalization 会重加权题目,token reduction 会改变长度偏好,长 rollout 会重塑系统瓶颈,环境测试会定义模型真正学到什么。GRPO 的简洁降低了入场门槛,却没有取消这些选择。算法、验证器、数据与基础设施必须一起设计,训练曲线才有可解释性。