大模型推理优化基础
训练一个 Transformer 时,最常见的两个症状是“跑得慢”和“放不下”。它们看起来像两个问题,实际上共享同一个根因:我们还没有把计算、数据移动、张量生命周期和跨设备通信放进同一张账本。
如果没有可信的测量,所谓优化可能只是把等待时间挪到了计时区间之外;如果没有显存分解,混合精度、算子融合和激活检查点就只能靠试错;如果没有通信模型,多加 GPU 甚至可能让每张卡算得更少、等得更多。
本章建立一条单 GPU 的完整推理链:
先让时间与显存数据可信;
再拆解单卡训练的显存来源;
用 FlashAttention-2 理解“少搬数据”为什么常常比“少做计算”更重要;
性能优化的第一原则:先证明自己测到了真实工作
GPU 计时最容易犯的错:只量到 CPU 发射时间
CUDA 调用通常是异步的。CPU 调用一次矩阵乘后,往往只把任务排进 GPU 队列便继续向下执行。因此,下面这种直觉上的计时方式并不可靠:
start = timer()
y = torch.matmul(a, b)
elapsed = timer() - start
elapsed 可能主要反映 Python 调用与内核发射开销,而不是矩阵乘真正完成所需的时间。可靠的边界应该让 CPU 等待此前排队的 CUDA 工作完成:
torch.cuda.synchronize()
start = timer()
train_step()
torch.cuda.synchronize()
elapsed = timer() - start
同样的陷阱也存在于分布式通信中。即使集合通信使用 async_op=False,调用返回也可能只意味着操作已经排入 GPU,而非通信已经完成。测 GPU 上的通信时间,仍需在测量边界同步。
冷启动不是稳态性能
第一次执行通常混有一次性初始化工作,因此不能把首轮延迟直接当成训练稳态。一个可复现的实验至少需要:
固定模型形状、批大小、上下文长度、精度和执行路径;
预先准备输入,避免把无关的数据生成时间混入目标区间;
先运行若干预热步骤;
对正式步骤逐次同步并计时;
同时报告均值与标准差,而不是只挑一个最好数字;
对多进程运行收集所有 worker 进程(rank)的结果,因为一步训练最终受最慢的参与者约束。
预热次数不是神奇常数。可从约 5 次预热开始,再观察连续测量是否进入稳定分布;只做 1~2 次预热仍可能把部分一次性成本留在正式区间。
“多快”与“为什么快”是两类测量
端到端计时回答的是:一次前向、一次前后向或一次完整训练步要多久。它适合判断某项改动是否真的改善最终目标,却不能告诉我们时间消失在哪里。
执行剖析则回答:CPU 在发射什么,GPU 在运行哪些 kernel,矩阵乘、归一化、softmax、优化器更新与集合通信各占多少。使用 Nsight Systems 一类时间线工具时,可以用 NVTX range 标记预热、前向、反向、优化器以及注意力内部阶段,再从 CPU API 调用追到对应的 GPU kernel。剖析本身有开销,因此只打开当前问题需要的追踪项;回溯信息虽然有用,却可能显著拖慢整次运行。torch.compile 还可能把多个源代码操作融合,使“某一行 Python 对应哪个 kernel”不再直观,分析时需要同时看融合前后的边界。
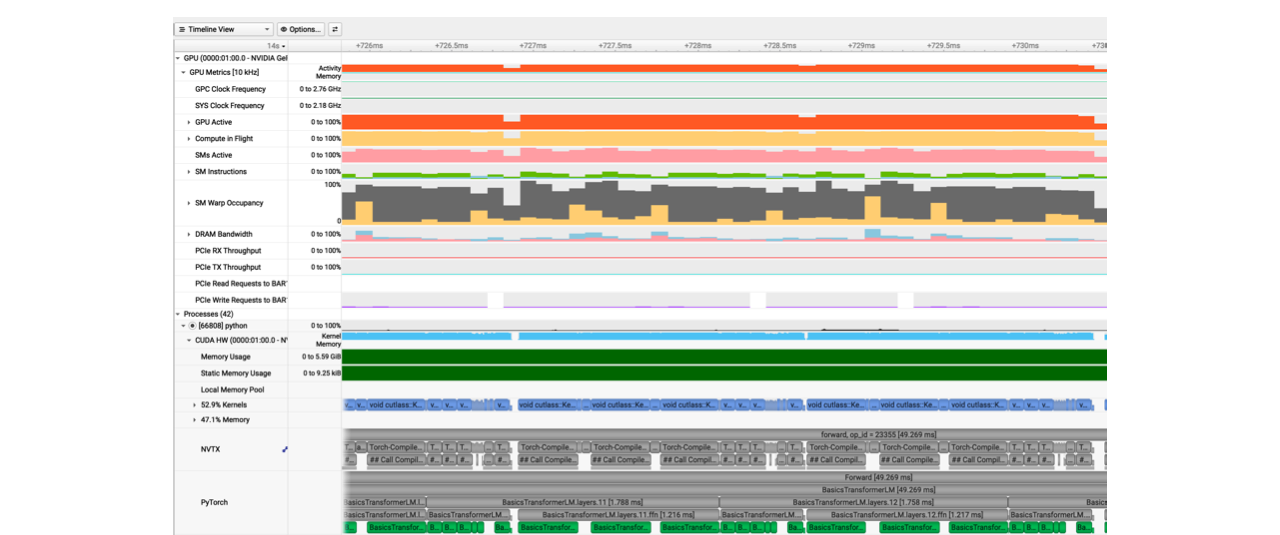
图 1:Nsight Systems 将 CPU 侧 CUDA 调用、GPU kernel、显存指标与 NVTX 语义区间关联起来。
显存剖析回答第三类问题:什么时候分配了多大的张量,它活了多久,又由哪段调用栈产生。峰值显存不是“所有见过的分配之和”,而是某一时刻仍然存活的分配集合。因此要看时间线,并把峰值与前向、反向、优化器阶段对齐。
一个稳健的优化闭环可以概括为:
单 GPU 显存:先把“放不下”拆成几本账
设模型参数总数为 \(P\),权重、梯度与优化器状态中每个元素的字节数分别为 \(s_w\)、\(s_g\)、\(s_o\)。以维护两份逐参数状态的 AdamW 为例,在不计框架元数据和临时缓冲区时,静态训练状态可粗略写成:
若低精度计算之外还保留一份 FP32 主权重,还要再加 \(P s_{\text{master}}\)。FP32 是 32 位浮点格式;BF16(bfloat16)是 16 位浮点格式,保留了与 FP32 相同宽度的指数域。这里的“主权重”是供优化器持续累积更新的高精度参数副本。这也解释了为什么“把计算改成 BF16”不等于“训练显存减半”:矩阵乘输入可以是低精度,但主权重、优化器累积量以及某些归约仍可能保持 FP32。混合精度的价值既包括 Tensor Core 吞吐,也包括部分张量与通信载荷的缩小,但必须逐类核算。
静态状态之外,至少还有三类动态显存:
类别 |
生命周期 |
典型决定因素 |
|---|---|---|
为反向保存的张量 |
从前向某个算子持续到其反向完成 |
批大小、序列长度、隐藏维度、算子分解方式 |
临时中间结果 |
某个 kernel 或融合区域内 |
分块(tile)大小、算子实现、工作区策略 |
当前层完整参数或通信缓冲 |
分片训练中短暂出现 |
预取窗口、层大小、通信精度 |
残差流只是下界,注意力矩阵才可能是平方项
残差流(residual stream)是沿残差连接在相邻 Transformer block 之间传递的隐藏状态主干;每个子层从中读取输入,并把更新结果加回这条主干。
若一个残差流张量形状为 \((B,T,D)\),其中 \(B\) 是批大小,\(T\) 是序列长度,\(D\) 是隐藏维度,元素大小为 \(s_a\) 字节,那么单个张量占用:
这个式子只描述一个张量。自动微分为了计算反向传播,会保存算子的输入、归一化统计量或其他中间结果;一层中可能同时保存多个同量级张量。真正危险的则是朴素注意力中的概率矩阵:若有 \(H\) 个头,其形状为 \((B,H,T,T)\),显存量级为
当上下文长度翻倍,残差流显存约翻倍,而注意力矩阵约变成四倍。这是长上下文首先撞上显存墙的直接原因。
算子融合:减少的不只是 kernel 数量
以 RMSNorm(Root Mean Square Normalization,均方根归一化)为例,它按特征维的均方根缩放隐藏向量。如果它由平方、均值、倒平方根和逐元素乘等多个细粒度算子组成,自动微分可能分别为这些节点保存张量。把整个归一化融合成一个单元后,反向只需围绕这个单元保存必要输入与少量统计量。
因此,融合有两类收益:
减少 kernel 发射和 HBM(高带宽显存)往返;
改变自动微分看到的边界,从而减少为反向长期保留的中间张量。
但融合无法消除所有激活。Transformer 层越多,需要跨越较长时间保存的张量仍会近似随层数增加。
激活检查点:用重算换取更短的张量生命周期
激活检查点(activation checkpointing,也常称 gradient checkpointing)不保存某个区域内部的全部中间结果,只保存该区域的入口。其执行过程是:
前向时记录检查点输入,并抑制区域内部张量的长期保存;
反向到达该区域时,先从入口重新执行一次前向,临时恢复反向所需张量;
紧接着完成该区域的反向并释放这些张量。
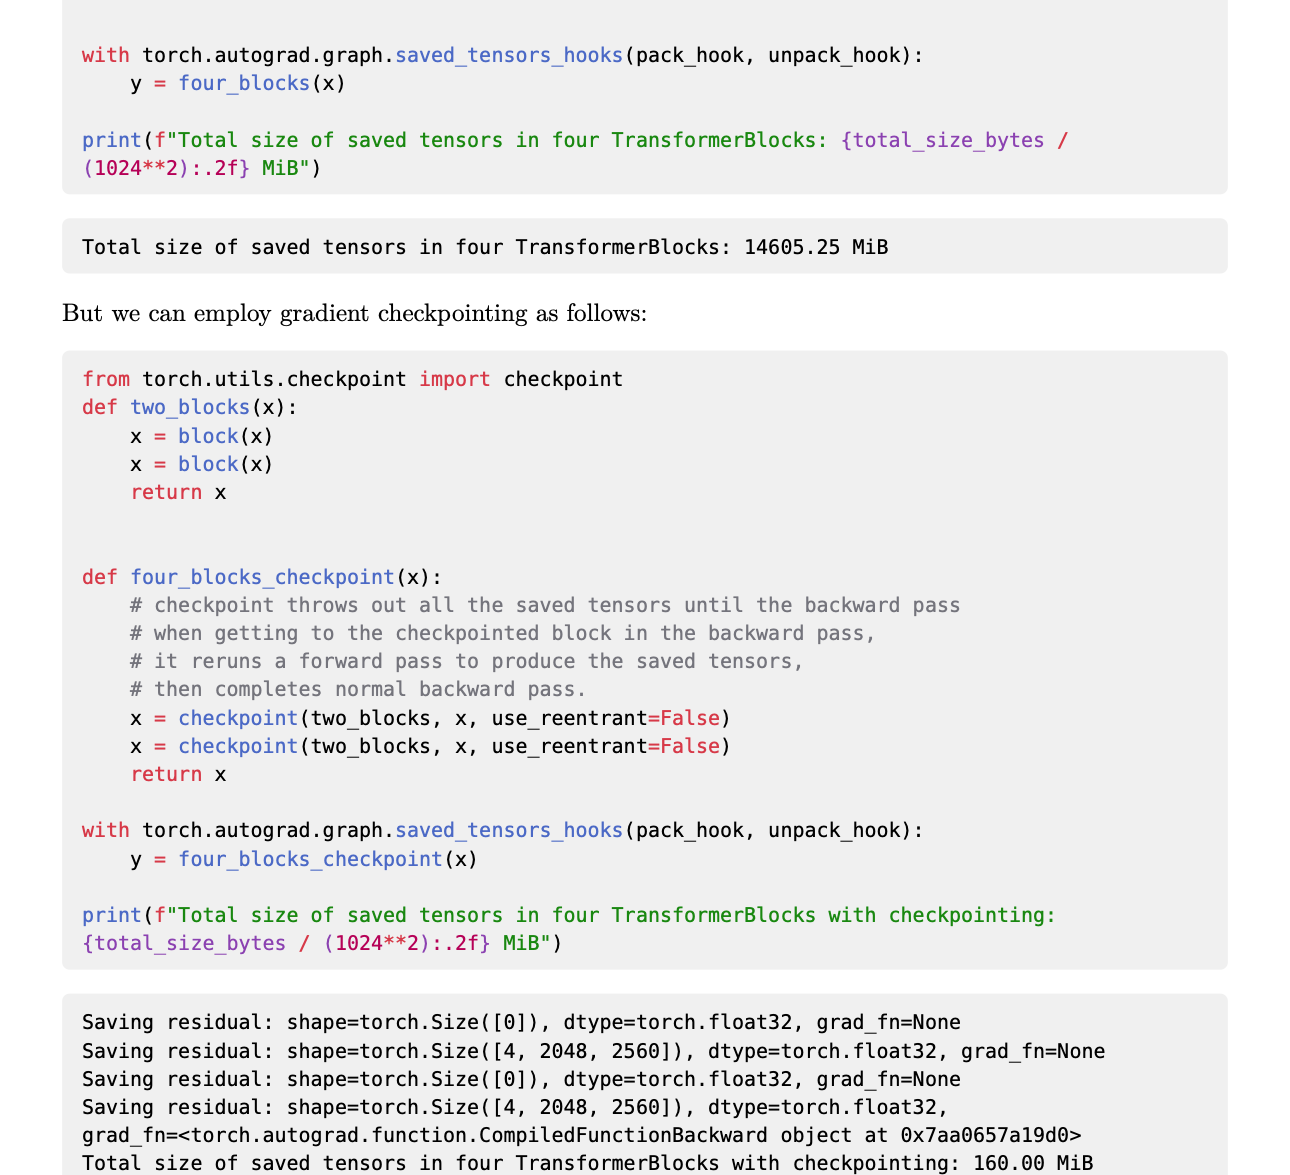
图 2:四个 Transformer blocks 的示例中,长期 saved tensors 从约 14605.25 MiB 降至 160 MiB。这只描述该示例的保存量,不等于完整训练峰值;反向重算时仍会短暂物化内部 residual。
它没有让中间结果凭空消失,而是把“所有层同时存活”改成“检查点入口长期存活 + 当前重算区域短期存活”。若把每 \(K\) 层划为一段,峰值激活可抽象成:
段越大,入口检查点越少,但一次重算要物化的内部张量越多;段越小则相反。合适的 \(K\) 不是固定经验值,而应通过目标形状下的显存时间线寻找。嵌套检查点还能进一步压低峰值,但会引入更多重算。因此顺序通常是:先去掉明显冗余的保存和物化,再用检查点换取最后所需的容量。
FlashAttention-2:注意力的瓶颈为什么首先是数据移动
设 \(Q\)、\(K\)、\(V\) 分别表示查询(query)、键(key)和值(value)矩阵,\(d\) 是每个注意力头的特征维度;\(S\) 表示缩放后的注意力分数,\(P\) 表示逐行归一化后的概率,\(O\) 表示输出。缩放点积注意力写作:
朴素实现会把 \(S\) 或 \(P\) 作为完整的 \(T\times T\) 矩阵写入 HBM,随后 softmax、与 \(V\) 相乘以及反向传播又会读取它们。SRAM(Static Random-Access Memory)在这里指 GPU 的片上高速存储,容量小但离计算单元近;HBM(High Bandwidth Memory,高带宽显存)容量更大,访问代价也更高。计算复杂度仍然值得关注,但这里更关键的系统问题是:巨大的中间矩阵反复穿过 SRAM 与 HBM 之间的窄门。
FlashAttention-2 并没有改变“每个 query 需要与相应 key 计算分数”这一事实,注意力的主要算术工作仍随 \(T^2\) 增长。它改变的是中间结果的物化方式:把 \(Q\)、\(K\)、\(V\) 切成 tile,在片上完成一小块分数、softmax 更新和输出累积,始终不把完整的 \(T\times T\) 概率矩阵写回 HBM。被消除的是显式二次方中间张量的存储和相关 HBM I/O,而不是二次方计算本身。
在线 softmax:不同 tile 的归一化如何拼成同一个答案
普通 softmax 看似必须先看到整行分数,因为分母为所有位置的指数和。在线算法的关键,是为每一行维护两个状态:
\(m_j\):处理到第 \(j\) 个 key tile 后的行最大值;
\(l_j\):以当前最大值为基准的指数和。
设新 tile 的分数为 \(S_j\)。更新最大值:
旧的指数和是以 \(m_{j-1}\) 为基准的。最大值变成 \(m_j\) 后,需要先换基准,再加上新 tile:
为什么这个更新是精确的?因为对任一旧分数 \(s\):
也就是说,乘上 \(e^{m_{j-1}-m_j}\) 就能把全部旧贡献统一换到新坐标系,而不必重新读取旧分数。输出累加器 \(A_j\) 使用同样的换基准方式:
处理完全部 key tile 后:
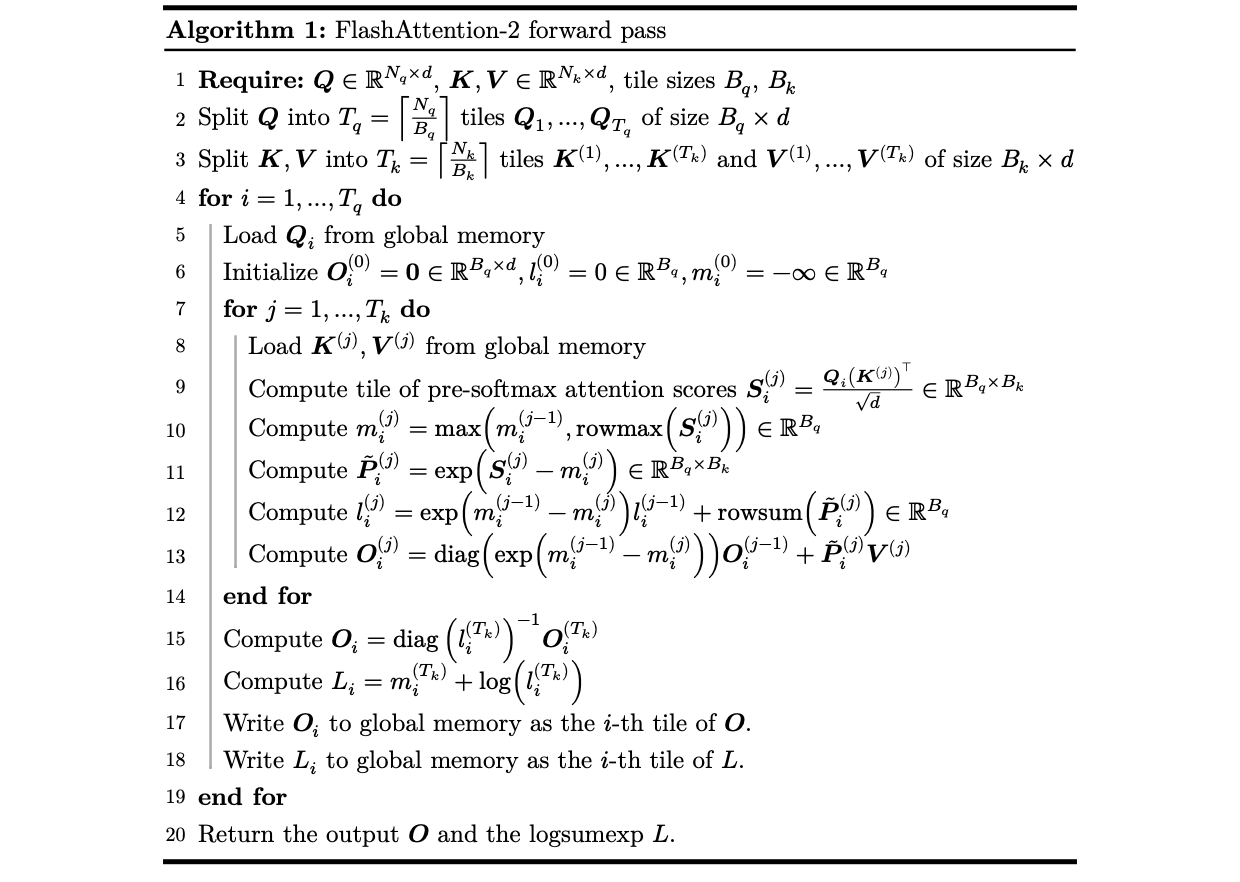
图 4:FlashAttention-2 前向逐块扫描 K/V,并维护 running maximum、normalizer 与输出 accumulator。
\(L\) 是每行的 logsumexp。它只有逐行大小,却足以让反向传播重建概率。
反向传播:保存小状态,重算大矩阵
朴素反向需要 \(P\):
FlashAttention-2 不在前向保存完整 \(P\),而是用 \(Q\)、\(K\) 和 \(L\) 按 tile 重算:
再预先计算逐行向量
其中 \(\circ\) 表示逐元素乘。由于 \(D\) 也等于 \(\operatorname{rowsum}(P\circ dP)\),softmax 的梯度可以写成:
随后按常规矩阵乘得到 \(dQ\)、\(dK\)、\(dV\)。这正是“重算比搬运便宜”时应采用的设计:增加部分算术,换掉大规模 HBM 读写与长期驻留。
模型训练结束,并不意味着计算成本已经结束。在线聊天、代码补全、智能体执行、离线批处理、模型评测和强化学习采样,都要反复调用同一个模型;训练通常只发生一次,推理却会随着产品使用持续累积。于是,决定系统体验与成本的核心问题从“能不能训练出来”变成了“每个 token 要搬多少数据、占多少显存、等多久、同时能服务多少请求”。
本章从算术强度出发,依次推导 prefill 与 decode 的瓶颈,再把 GQA、MLA、量化、剪枝、投机采样、continuous batching 和 PagedAttention 放回同一张系统地图。
TTFT、TPOT 与吞吐
同一个推理系统,在不同业务里会被完全不同的指标约束。聊天产品希望用户尽快看到第一个 token;代码补全更在意后续 token 是否连续流畅;批量评测和数据生成则更关心整台机器每秒能产出多少 token。只说“延迟更低”或“吞吐更高”,往往不足以判断一次优化是否真的有效。
指标 |
回答的问题 |
主要受什么影响 |
典型场景 |
|---|---|---|---|
TTFT(Time to First Token) |
请求发出后,多久看到第一个 token? |
排队、prefill、调度与首轮通信 |
聊天、搜索、代码补全 |
TPOT / inter-token latency |
进入生成阶段后,相邻 token 间隔多长? |
decode 的权重读取、KV cache 读取与同步 |
流式输出、语音交互 |
Throughput |
整个系统每秒一共生成多少 token? |
batch、并行度、调度、显存容量与利用率 |
离线推理、评测、RL rollout |
尾延迟 |
最慢的一小部分请求要等多久? |
请求长度分布、排队、抢占、抖动 |
有 SLO 的在线服务 |
这些指标之间并不总是一致。增大 batch 往往能摊薄权重读取成本、提高总吞吐,却也会让单请求排队更久、占用更多 KV cache,并恶化 TTFT 或 TPOT。推理系统的设计因此不是追求单一最大值,而是在产品目标、硬件预算和流量分布之间找工作点。
Prefill 与 Decode
自回归语言模型每次根据已有前缀预测下一个 token。若每生成一个 token 都把全部历史重新送进 Transformer,生成长度为 \(T\) 的序列时,第 \(t\) 步要处理长度为 \(t\) 的前缀,而一次 dense attention 的工作量又随前缀长度近似平方增长;把所有步骤加起来,会得到朴素实现的 \(O(T^3)\) 量级总计算。
关键观察是:旧 token 在每一层产生的 key 和 value 不会因为后面多生成一个 token 而改变。把它们缓存在 HBM 中,下一步只需为新 token 计算新的 query、key、value,再让新 query 读取历史 KV。这样,推理自然分成两个性质不同的阶段:
阶段 |
输入形态 |
并行性 |
主要用户指标 |
|---|---|---|---|
Prefill |
一次处理整段 prompt |
token 维可以并行,矩阵通常较大 |
TTFT |
Decode / generation |
每轮为每个请求生成 1 个新 token |
时间维严格串行,单轮矩阵偏“瘦” |
TPOT 与总吞吐 |
**KV cache 的数据流。**缓存后的推理不再重复计算整段前缀,而是复用历史 token 已经生成的 key/value;代价是每条活跃序列、每一层、每个 KV head 都要保留状态。
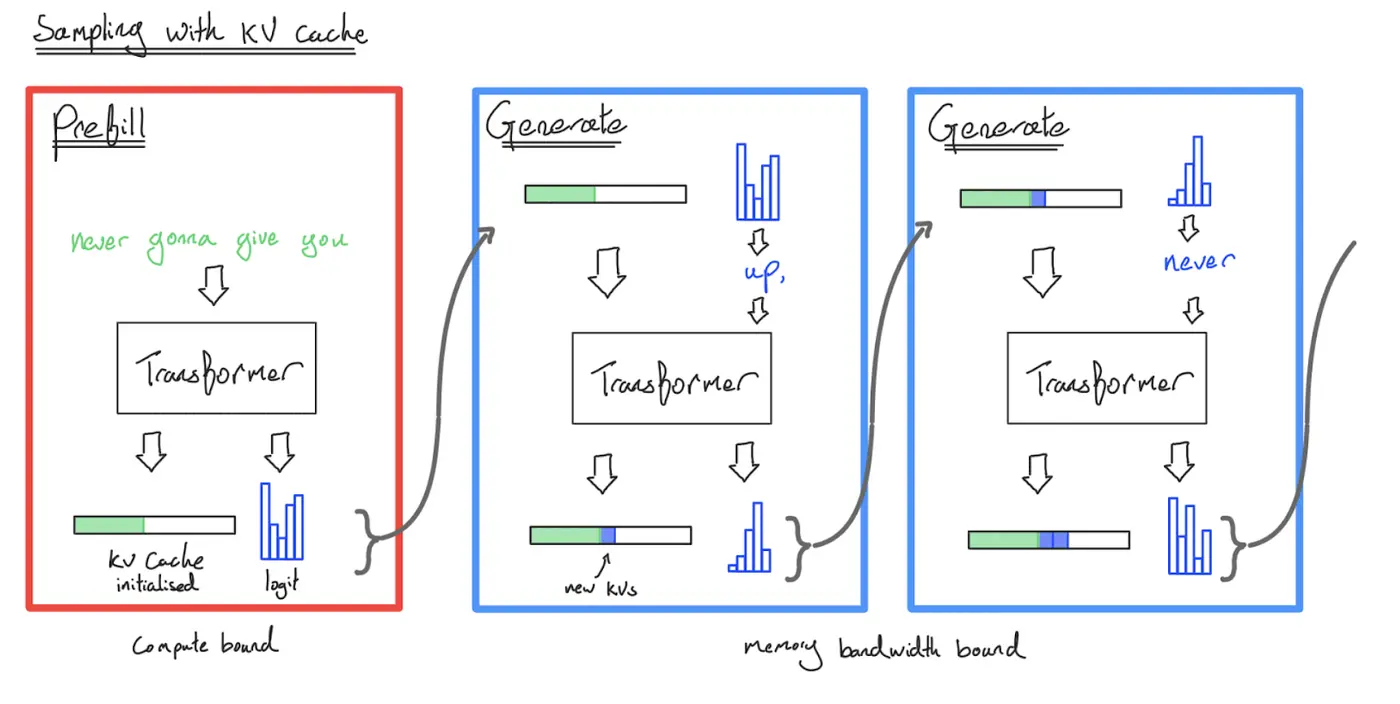
设上下文长度为 \(S\),KV head 数为 \(K\),每个 head 维度为 \(H\),层数为 \(L\)。若 key 和 value 都用 bf16 保存,每个元素 2 bytes,则单条序列的 KV cache 为:
这条公式非常重要:上下文越长、并发越高、层数越深、KV head 越多,显存占用都会线性增长。后面几乎所有 serving 优化,都可以看成在改变这份账本。
Roofline 视角:瓶颈取决于每搬一个字节做多少计算
GPU 的峰值 FLOP/s 只代表计算上限,HBM bandwidth 则代表数据供给上限。判断一个算子更可能被哪一边限制,常用指标是 arithmetic intensity(算术强度):
以 bf16 矩阵乘 \(XW\) 为例,令 \(X\in\mathbb{R}^{B\times D}\)、\(W\in\mathbb{R}^{D\times F}\)。一次乘加记作 2 FLOPs,则:
当 \(B\ll D,F\) 时,权重矩阵 \(W\) 的读取占主导,算术强度近似为 \(I\approx B\)。直觉上,每次把同一份权重从 HBM 搬进来,batch 中有多少样本就能复用多少次;\(B=1\) 的矩阵向量乘几乎没有复用,因此很容易 memory-bound。
以下算例采用 H100 SXM 的 dense BF16 Tensor Core 峰值约 \(989\times10^{12}\) FLOP/s,以及 \(3.35\times10^{12}\) bytes/s HBM 带宽,得到理想 roofline 平衡点:
在这组具体硬件规格、精度和理想化假设下,只有当算术强度超过约 295 FLOPs/byte,算子才更可能进入 compute-bound。这个阈值不是“H100 的永恒常数”:SKU、数据类型、稀疏性、实际 kernel 效率和可达到的带宽都会改变它。
为什么 Prefill 容易吃满算力,Decode 却被内存拖住
现在把同样的账本应用到 Transformer。记 \(B\) 为 batch,\(S\) 为已有上下文长度,\(T\) 为本轮同时处理的新 token 数,\(D\) 为模型宽度,\(F\) 为 FFN 中间维度。
MLP:batch 和 token 都能复用同一组权重
对包含 up、gate 和 down 三次矩阵乘的 gated MLP,忽略逐元素操作,可近似得到:
当 \(BT\ll D,F\) 时,权重读取主导,算术强度趋近:
Prefill 一次处理 \(T=S\) 个 token,因此 \(I\approx BS\),长 prompt 或较大 batch 都能提高权重复用;decode 每次只有 \(T=1\),于是 \(I\approx B\),只能依靠并发请求让同一组 MLP 权重服务更多 token。
Attention:每条序列都必须读取自己的 KV cache
在 bf16、标准 MHA(K/V 总宽度均按 \(D\) 计)、采用 FlashAttention 类数据流,并忽略投影层、softmax、kernel 开销及其他中间读写的简化模型下,attention 主体可近似核算为:
代入两个阶段:
这就是本讲最关键的结论。Prefill 的矩阵较大,通常更接近 compute-bound;decode attention 每生成一个 token,都要扫描每条序列自己的历史 KV,做的计算却很少,因此强烈 memory-bound。与 MLP 不同,扩大 batch 并不能提高这里的算术强度:新增请求同时带来一份新的 KV cache,没有共享同一状态的复用收益。
模块 |
Prefill 算术强度 |
Decode 算术强度 |
batch 是否直接改善强度 |
|---|---|---|---|
MLP |
\(BS\) |
\(B\) |
是,共享模型权重 |
Attention |
\(S/2\) |
\(S/(S+1)<1\) |
否,每条请求读取自己的 KV |
“decode memory-bound”不是说所有推理 kernel 永远都不受计算限制,而是说在这里的标准 dense attention 数据流和给定近似下,HBM 流量是首先要解决的问题。架构压缩、稀疏化、量化和专用 kernel 正是在改变这些约束。
延迟与吞吐为什么天然冲突:Llama 2 13B 的理论账本
为了把公式落到量级上,下面用 Llama 2 13B 与单张 H100 做一个理想化模型。配置为 \(S=1024,D=5120,F=13824,N=K=40,H=128,L=40,V=32000\),带宽取 \(3.35 \mathrm{TB/s}\)。参数量、总显存、单 token 延迟和吞吐近似为:
配置 |
总内存 |
理论 TPOT |
理论吞吐 |
解释 |
|---|---|---|---|---|
MHA,\(B=1\) |
26.87 GB |
8.02 ms/token |
124.7 tok/s |
单请求延迟最低,权重复用最少 |
MHA,\(B=64\) |
79.72 GB |
23.80 ms/token |
2689 tok/s |
吞吐提高,但理论显存已逼近 80 GB |
MHA,\(B=256\) |
240.78 GB |
71.87 ms/token |
3562 tok/s |
单卡放不下,且吞吐收益递减 |
这里的结果是“只按内存流量计算”的理论上限,不是实测 benchmark:它假设计算与通信完美重叠,并忽略 kernel launch、同步、调度、allocator、网络与框架开销。即便如此,它仍清楚展示了基本矛盾——batch 越大,权重读取摊得越薄,总吞吐越高;但 KV cache 随 \(B\) 增长,单请求延迟与显存压力也一起上升。实践中,79.72 GB 也不能真的塞进一张标称 80 GB 的卡,因为运行时和临时张量还需要空间。
因此,prefill 和 decode 往往需要不同的调度策略:prefill 用较小批次控制 TTFT,decode 则尽量聚合活跃请求提高吞吐。更进一步的系统会把两个阶段拆到不同资源池中,分别优化计算密集和带宽密集的负载。
第一条路线:让 KV cache 更小
既然 decode 的主要成本来自反复读取 KV cache,最直接的思路就是减少每个 token 必须缓存的状态。不同方法压缩的是不同维度:有的跨 head 共享,有的先投影到低维 latent,有的跨 layer 共享,还有的直接截断可见历史。
从 MHA 到 GQA / MQA:减少 KV head
Multi-Head Attention(MHA)为每个 query head 配一组独立的 key/value head,即 \(K=N\)。Multi-Query Attention(MQA)把所有 query head 都连接到同一组 KV,即 \(K=1\)。Grouped-Query Attention(GQA)位于两者之间:\(N\) 个 query head 分成 \(K\) 组,每组共享一对 key/value head。
**GQA 的共享关系。**当 \(N=40\)、\(K=8\) 时,每 5 个 query heads 共享一组 KV,单序列 KV cache 相对 MHA 缩小 \(N/K=5\) 倍。
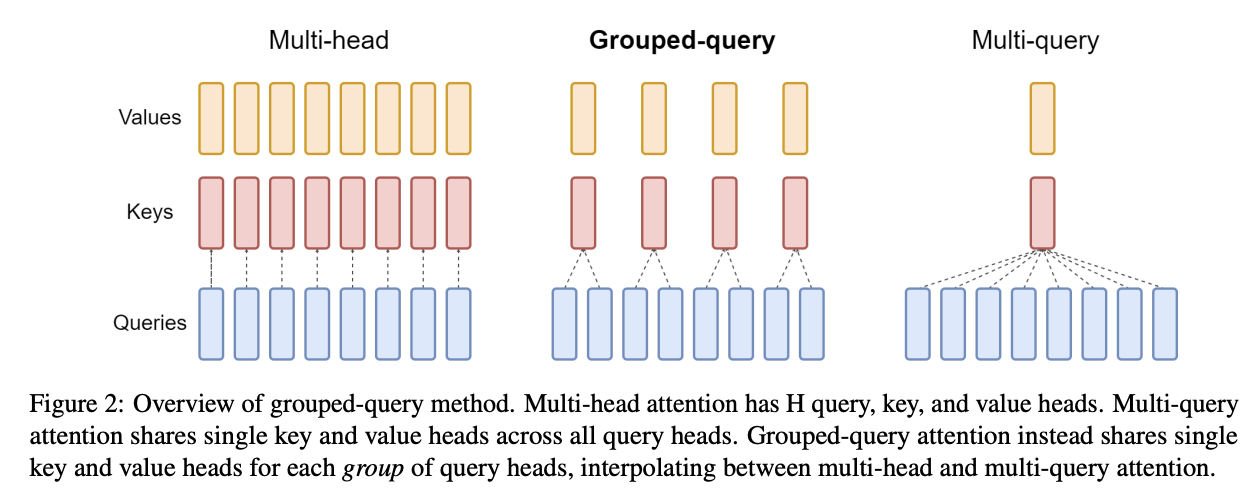
作为理论对照,保持上述配置的其他维度不变,仅把 KV head 数从 \(K=40\) 改为 \(K=8\)。这会同时缩小 KV cache 和 K/V projection 参数;按上述参数公式,该假想模型约为 11.34B 参数。下表仍是理想内存带宽模型,而不是实际 GQA checkpoint 的 benchmark:
配置 |
总内存 |
理论 TPOT |
理论吞吐 |
|---|---|---|---|
GQA,\(K=8,B=64\) |
33.41 GB |
9.97 ms/token |
6417 tok/s |
GQA,\(K=8,B=256\) |
65.63 GB |
19.59 ms/token |
13068 tok/s |
按上述公式复算,相同 batch 下的延迟也会显著下降。真正需要重新验证的是模型质量,以及实际 kernel 是否能把理论带宽收益兑现出来。
MLA:缓存 latent,而不是完整 K/V
Multi-head Latent Attention(MLA)不直接缓存完整 \(K=W_Kh\) 与 \(V=W_Vh\),而是先把隐藏状态压到低维 latent:
**MLA 的压缩路径。**缓存的是低维 \(c\),所需的 K/V 表示由低秩路径提供。以 DeepSeek-V2 为例,每个 K 或 V 的总 head 宽度为 \(NH=16384\),传统 MHA 的完整 K+V cache 是 \(2NH=32768\) 个元素。
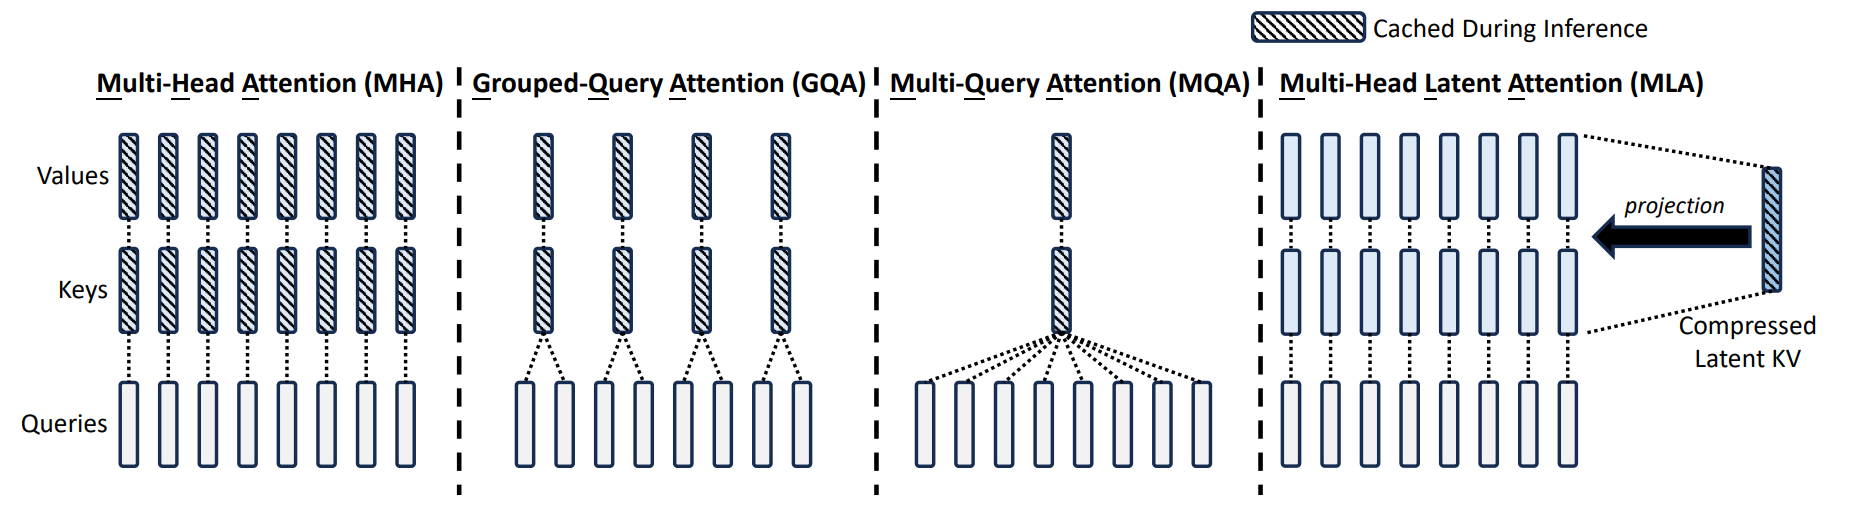
这里有一个不能略过的 RoPE 细节。RoPE 对 key 引入位置相关旋转,使某些投影无法像普通线性层那样完全吸收到相邻矩阵中。DeepSeek-V2 因此把内容通道与 RoPE 通道解耦,每个 token、每层缓存 512 维 KV latent 与 64 维 decoupled RoPE key,共 \(512+64=576\) 个元素;相对传统 MHA,元素数约缩小 \(32768/576\approx56.9\) 倍。MLA 通过低秩表示及可吸收到相邻投影中的变换,换取显著更少的 HBM 状态读取。
CLA、滑动窗口与稀疏注意力:继续压缩层和时间维
Cross-Layer Attention(CLA)沿 layer 维共享 KV,可以理解为把 GQA 的“跨 head 共享”再推广到“跨 layer 共享”。Local / sliding-window attention 则只保留最近窗口的 KV;当序列长度超过固定窗口后,局部层缓存的上界由窗口大小决定,不再随更长的总上下文增长。代价是远距离依赖可能受损,因此常与少量 global attention 层交错使用。
再以 2026 年 DeepSeek-V4 技术报告为例,压缩、筛选和重压缩可以组合:Compressed Sparse Attention 先聚合一段 token,DeepSeek Sparse Attention 再选择重要位置,Heavily Compressed Attention 进一步降低长上下文状态。这些方法都在回答同一个问题:每生成一个 token,究竟需要从历史中读取多少信息。
方法 |
压缩维度 |
主要收益 |
主要风险 |
|---|---|---|---|
GQA / MQA |
KV head |
KV cache 约缩小 \(N/K\) 倍 |
共享过强可能损伤质量 |
MLA |
head 表示维度 |
缓存低维 latent,降低读写量 |
投影成本与 RoPE 兼容设计 |
CLA |
layer |
多层复用同一 KV |
层间表达能力下降 |
Sliding window |
时间 / 上下文 |
超过窗口后,局部层缓存上界由窗口大小决定 |
长程依赖受损 |
Sparse / compressed attention |
被访问的历史 token |
长上下文读写和计算下降 |
选择机制、训练与 kernel 更复杂 |
第二条路线:让每个字节更便宜
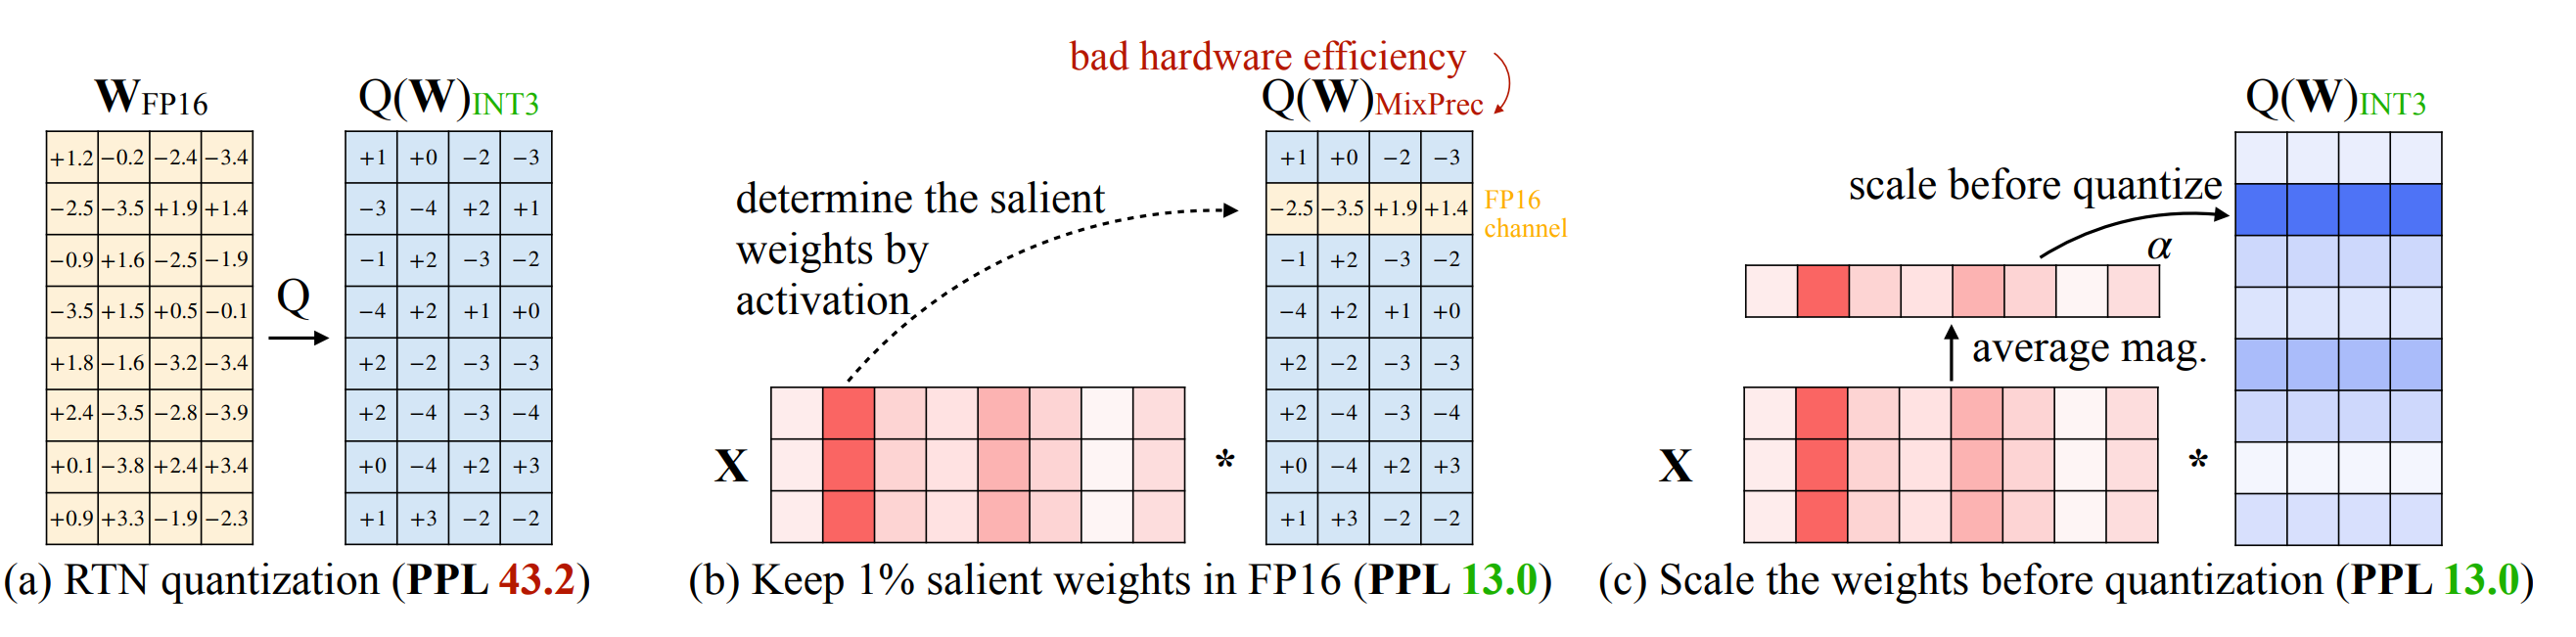
量化可以分别作用于权重、activation 或 KV cache,但具体方法覆盖的对象不同。对于 memory-bound 的 decode,被量化对象从 bf16 的 2 bytes 降到 fp8/int8 的 1 byte,理论带宽压力可近似减半;int4 进一步降到 0.5 byte。但本文随后介绍的 GPTQ 和 AWQ 主要属于权重量化;只有显式启用 KV-cache quantization 时,KV cache 的每元素字节数才会同步下降。位宽下降也会缩小动态范围和有效精度,因此必须显式管理 scale 与 zero point。
例如 \(x=5.2342,s=0.1,z=4\),量化后 \(x_q=56\),反量化得到 \(\hat{x}=5.2\)。误差看似很小,但在数十亿参数和很多层中会累积;scale 是 per-tensor、per-channel 还是 per-group,也会同时影响精度、metadata 开销和 kernel 实现。
方法 |
什么时候做 |
如何控制误差 |
代价 |
|---|---|---|---|
QAT |
训练阶段 |
前向模拟 quantize/dequantize,让权重适应误差 |
需要昂贵训练 |
PTQ |
训练完成后 |
用 calibration data 估计 scale / zero point |
极低位宽下精度更难保持 |
GPTQ |
训练完成后 |
利用二阶/Hessian 信息补偿已量化权重误差 |
校准与离线处理更复杂 |
AWQ |
训练完成后 |
根据 activation 识别重要通道并做 scaling 保护 |
依赖代表性 calibration data |
**AWQ 的保护机制。**少量与大 activation channel 相连的显著权重,对输出误差贡献尤其大。AWQ 通过 activation-aware scaling 保护这些权重,而不是简单把所有值用同一种粒度压缩。AWQ 论文的 TinyChat 系统主要评估 W4A16:仅按权重位宽计算,FP16 到 INT4 约带来 4 倍权重压缩;论文在其测试模型、桌面或移动 GPU 与 Hugging Face FP16 基线上报告约 3.2–3.3 倍平均加速。这是特定 kernel、模型和设备下的结果,不应泛化成任意部署的保证。
第三条路线:剪掉工作,再用蒸馏修复
结构化剪枝直接移除层、attention head 或 hidden dimension,让模型的参数量和实际矩阵形状一起变小。一种典型流程先用 1024 条 calibration samples 评估结构重要性,再删除不重要部分,最后让裁剪后的 student 模型学习原模型的输出或中间表示。
这类方法与单纯 runtime 优化不同:它改变了模型函数,属于有损捷径。正确验收必须同时看两组指标——一组是 TTFT、TPOT、吞吐、显存和成本,另一组是目标任务质量、安全性与长尾能力。若只验证困惑度或少量通用 benchmark,很可能错过业务分布上的退化。
从零训练与蒸馏的区别也可以说得很直接:前者先定义更快的架构,再从头训练;后者先定义更快的架构,用原模型提供初始化或监督信号,再通过知识蒸馏修复删减造成的质量损失。
Speculative Sampling:把慢生成改造成快验证
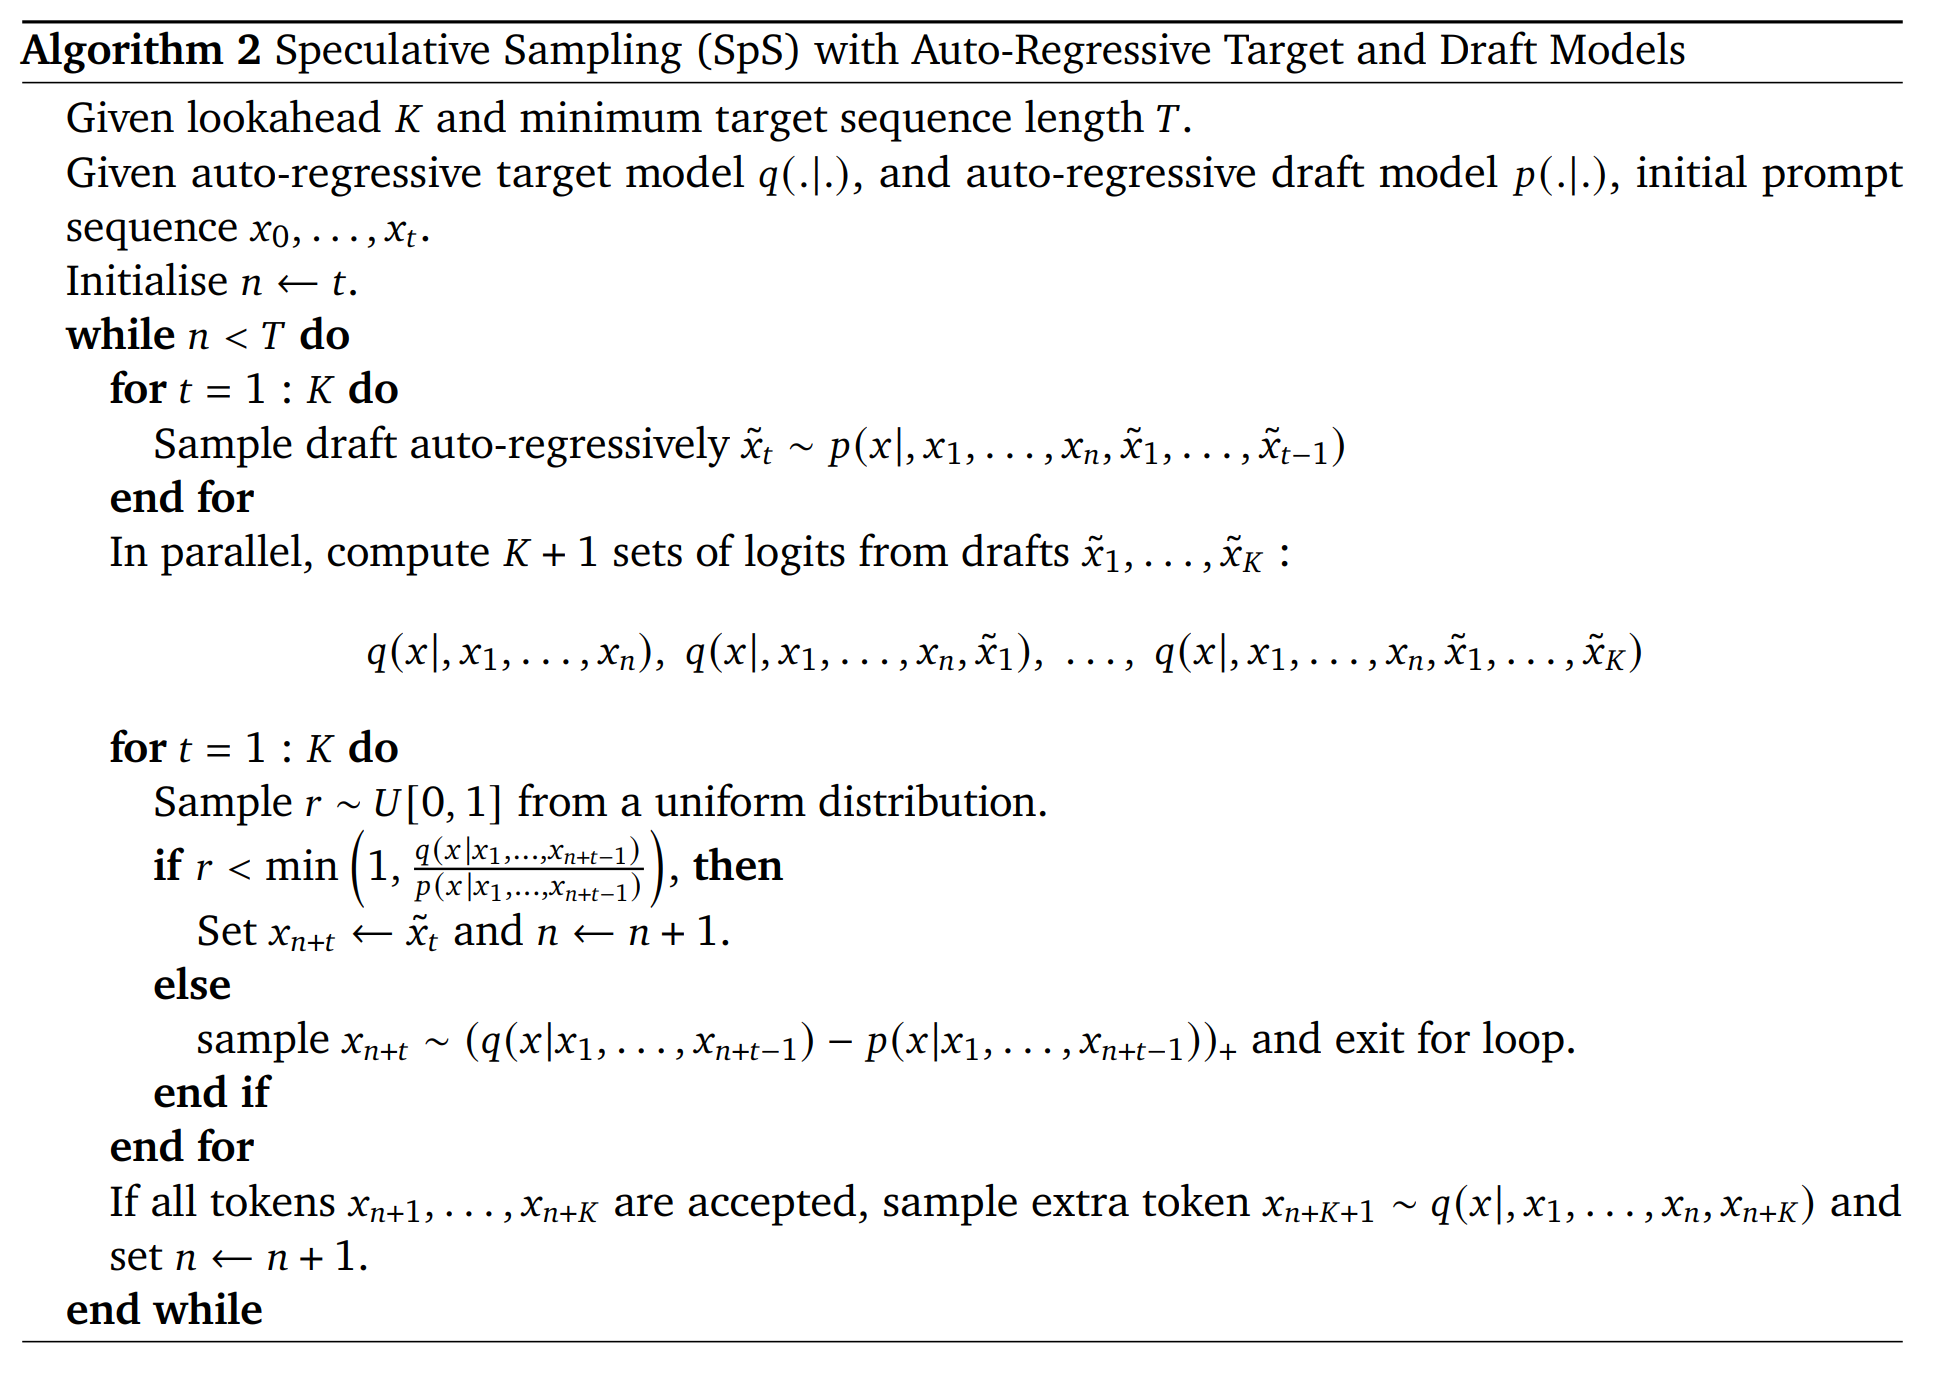
Prefill 能并行检查一串 token,而 decode 只能一次生成一个 token。投机采样利用了这个不对称:让便宜的 draft model \(p\) 自回归猜出 \(K\) 个候选,再让 target model \(q\) 在一次前向中并行给出这些位置的概率。只要 draft 足够便宜、命中率足够高,一次昂贵的 target 调用就能推进多个 token。
**投机采样的完整循环。**候选 token 并不是直接接受。第 \(t\) 个候选 \(\tilde{x}_t\) 以如下概率被接受:
若拒绝,则从归一化后的残差分布 \((q-p)_+\) 中补采样;若 \(K\) 个候选全部接受,还能从 target 的下一个位置再采一个 token。这个修正后的 rejection sampling 保证最终分布仍然严格等于 \(q\),因此它是无损加速,而不是“用小模型近似大模型”。
用二元词表看清为什么分布不变
假设词表只有 \({A,B}\),并且 draft 对 A 过采样:\(p(A)>q(A)\),于是 \(p(B)<q(B)\)。残差 \((q-p)_+\) 只在 B 上有质量。最终生成 A 的概率为:
生成 B 有两条路径:draft 先采到 B 并被接受,或者先采到 A、A 被拒绝后从残差分布补采 B:
于是两个 token 的边缘概率都与 target 完全一致。多 token、一般词表时使用同一接受率与残差校正,结论仍成立。
投机采样的收益取决于三个量:draft/target 的成本比、候选接受率、一次并行验证能覆盖的 token 数。如果 draft 不够快,或者它与 target 差异太大导致频繁拒绝,额外工作会抵消收益。Medusa 通过额外 decoding heads 并行提出候选,EAGLE 则让 draft 利用 target 的高层特征,都是在改善候选质量与生成成本的平衡。
真实流量不是矩形张量:Continuous Batching
训练 batch 通常是一块规则的 \(B\times S\times H\) tensor;在线推理却是一组不断变化的 ragged sequences:请求到达时间不同,prompt 与输出长度不同,有的很快结束,有的持续生成,还有不少请求共享 system prompt 或用户前缀。
**静态批处理的空等问题。**如果必须等整个 batch 中最长的请求结束才能释放和补充请求,已经完成的槽位会闲置,新请求也只能排队;padding 还会把无效位置带进计算。
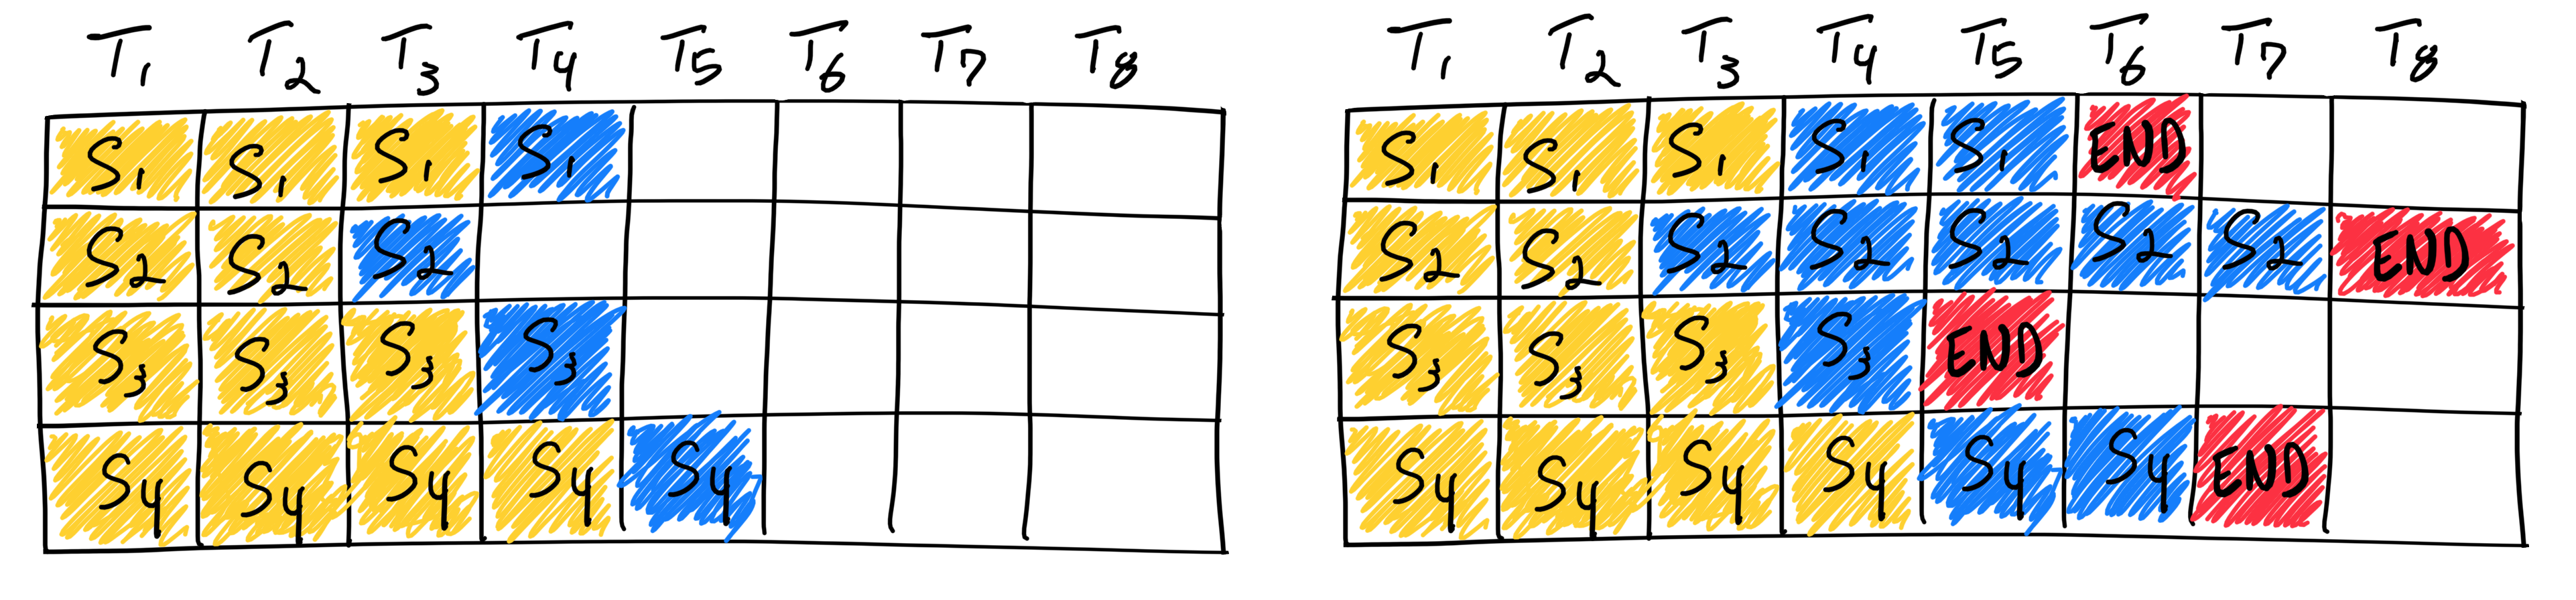
Continuous batching,也叫 iteration-level scheduling,把调度边界从“整个请求”缩小到“一个 decode step”。每完成一轮,就移除结束请求,并把新请求补进 batch。这样,GPU 面前持续有足够多的活跃 token,吞吐不再被最慢请求拖住。
不同长度仍然带来 shape 问题。Selective batching 的处理方式是按算子性质拆开:attention 需要访问各自长度不同的 KV,因此按 sequence 的边界处理;RMSNorm、线性层等不依赖序列边界的操作,则可以把活跃 token 拼成 \((S_1+S_2+\cdots+S_B)\times H\) 的紧凑矩阵统一计算。
Continuous batching 解决的是“什么时候把谁放进本轮计算”,但还没解决“不断增长、长度未知的 KV cache 应该放在哪里”。后者正是 PagedAttention 的问题。
PagedAttention:像操作系统一样管理 KV cache
传统实现常在请求到来时,按最大可能输出长度为它预留一段连续 KV 空间。若请求提前结束,预留但未使用的槽位形成 internal fragmentation;不同大小的分配与释放在物理空间中留下洞,则形成 external fragmentation。即使剩余总空间很多,也可能找不到足够大的连续区间。
**连续预留为什么浪费显存。**请求 A 与 B 都只使用了很少的生成槽位,但为了潜在的最长输出提前占住大块连续区域;真实长度的不确定性被直接转化成显存浪费。
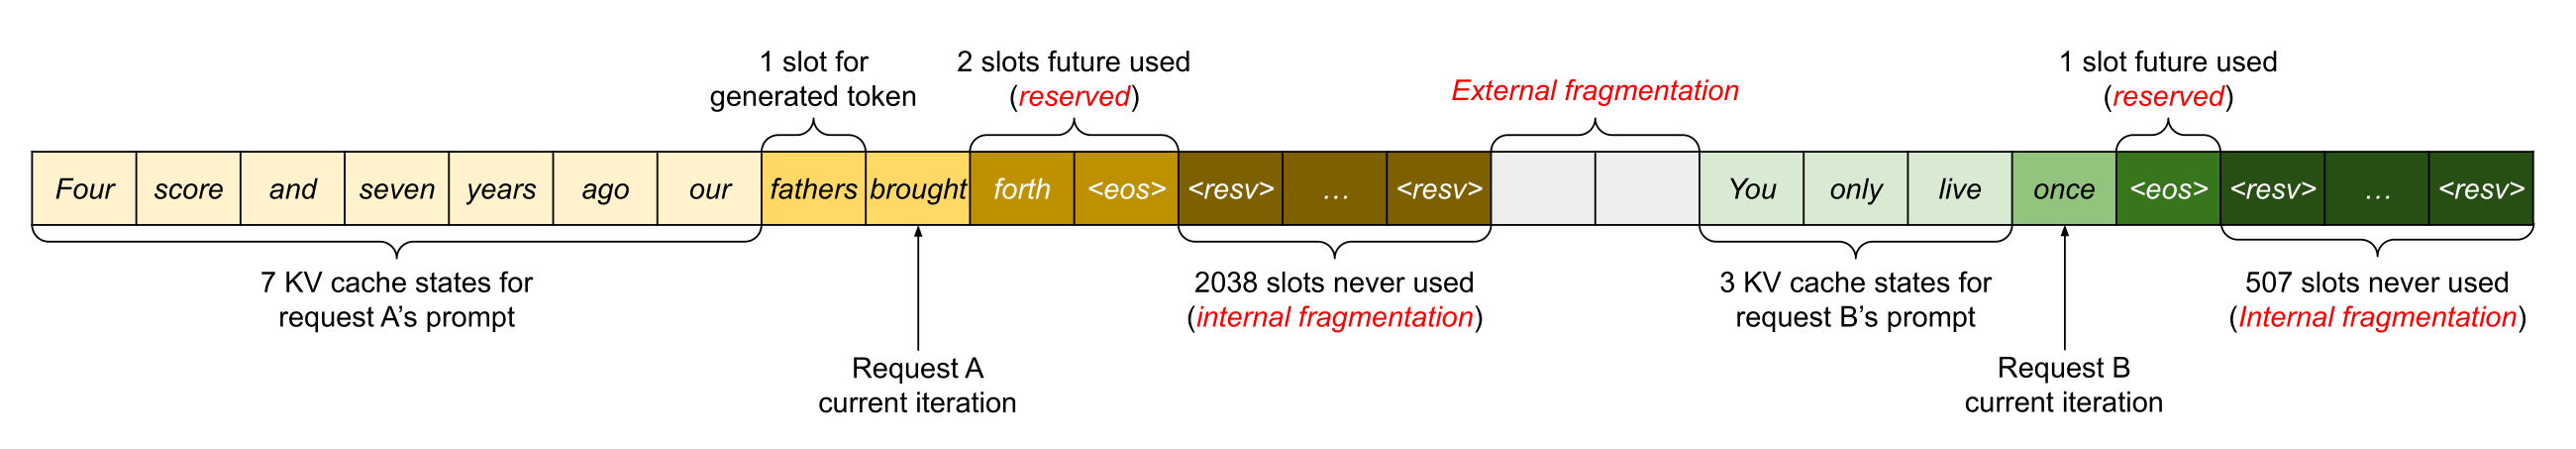
PagedAttention 借用了操作系统虚拟内存的思想:把一条序列的逻辑 KV cache 切成固定大小的 logical blocks,再通过 block table 映射到任意非连续的 physical blocks。系统只在序列增长时按需分配新块,因此大幅减少连续预留和外部碎片。
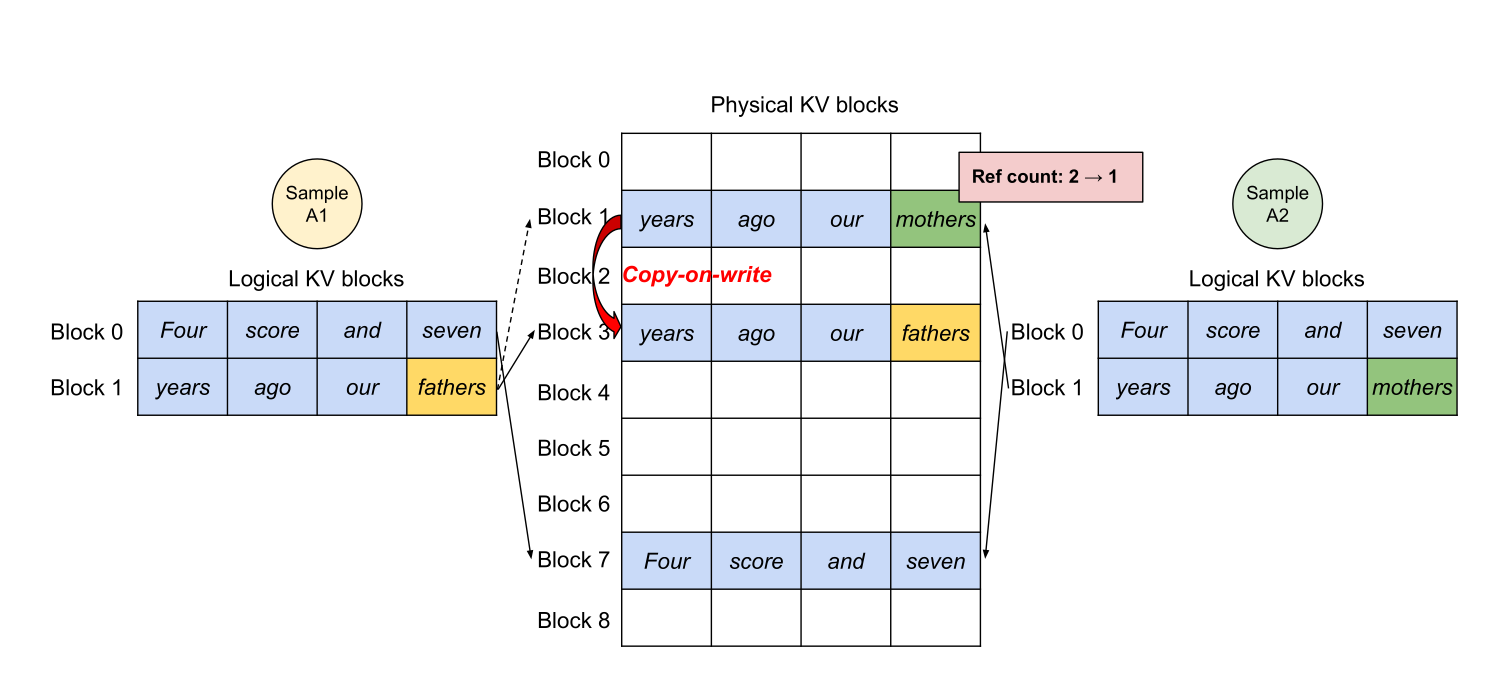
分页还让共享前缀变得自然。多条请求可以让逻辑块指向同一组只读物理块,例如共享 system prompt,或从同一 prompt 采样多个候选答案;只有当某个分支继续写入共享块时,才执行 block-level copy-on-write。
**前缀共享与写时复制。**两条采样路径复用相同前缀的物理 KV blocks,分叉位置才复制并写入各自的新块;引用计数决定共享块何时可以释放。
PagedAttention 与 FlashAttention 名字相似,却优化不同层次。FlashAttention 重排单次 attention kernel 的计算和 I/O,避免 materialize 完整 score/probability matrix;PagedAttention 管理跨请求、跨 decode step 长期存在的 KV cache。前者关注算子内部的数据流,后者关注 serving runtime 的内存虚拟化与调度,两者可以同时使用。
小结
瓶颈 |
改变什么 |
代表技术 |
主要改善 |
必须复核 |
|---|---|---|---|---|
KV cache 过大 |
减少每 token、每 head、每 layer 的状态 |
GQA、MLA、CLA、sliding/sparse attention |
显存、TPOT、可承载并发 |
模型质量与长上下文能力 |
权重与状态字节过多 |
降低表示精度 |
FP8、INT8/INT4、GPTQ、AWQ |
带宽、容量、成本 |
校准数据、精度、kernel 支持 |
模型本身太大 |
删除结构并修复能力 |
structured pruning、distillation |
FLOPs、权重显存、延迟 |
业务质量与长尾退化 |
自回归步骤串行 |
用便宜生成换昂贵并行验证 |
speculative sampling、Medusa、EAGLE |
有效 tokens / target step |
接受率与 draft 成本 |
请求到达与长度动态 |
按 iteration 重组活跃 batch |
continuous/selective batching |
设备利用率与吞吐 |
TTFT、尾延迟、公平性 |
KV 分配碎片与重复前缀 |
逻辑块到物理块映射 |
PagedAttention、prefix sharing、COW |
有效显存利用率 |
block size、映射与 kernel 开销 |
这张表也解释了为什么现代 serving engine 往往同时包含多个技术层:模型架构决定单 token 状态量,量化决定每个状态的字节数,kernel 决定数据如何在芯片上流动,调度器决定哪些请求一起运行,内存管理器决定 KV cache 如何分配与共享。只优化其中一层,往往会把瓶颈推到下一层。
验证维度 |
至少应记录 |
常见误判 |
|---|---|---|
用户体验 |
TTFT、TPOT、端到端 p50/p95/p99 |
平均延迟变好,但尾延迟或排队恶化 |
系统效率 |
request/s、token/s、GPU 利用率、HBM 带宽 |
只看 token/s,忽略输出长度变化 |
容量 |
峰值显存、KV 占用、碎片率、可承载并发 |
用标称显存减权重,忽略 workspace 与 runtime |
质量 |
任务指标、生成分布、安全与长尾样本 |
把有损量化/剪枝当成纯系统优化 |
可比性 |
相同硬件、dtype、请求分布和 SLO |
拿不同 latency 约束下的最大吞吐直接比较 |
decode 每轮计算少、状态读取多,所以先压缩 KV cache 与权重;单纯增大 batch 会碰到延迟和容量边界,所以需要 continuous batching;动态长度又造成碎片与重复前缀,于是需要 PagedAttention;自回归串行无法直接消失,就让小模型猜、大模型并行验,并用拒绝采样保持精确分布。