SFT-有监督微调
预训练解决的是“模型能续写什么”,有监督微调(Supervised Fine-Tuning,SFT)解决的是“面对一个明确请求,模型应该以什么角色、格式和边界作答”。本章从训练目标、数据构造、知识边界、安全行为和工程配方五个层面,解释预训练模型如何变成可控助手。
后训练流水线
经典后训练流程由三类不同的监督信号组成。第一阶段收集“prompt—理想回答”示范并做 SFT;第二阶段针对同一 prompt 采样多个回答,由标注者给出排序或成对偏好,再训练奖励模型;第三阶段把语言模型当作策略,在奖励信号与参考策略约束下优化。三者不能混为一谈:示范数据告诉模型“如何作答”,偏好数据告诉系统“两个可行回答中更喜欢哪一个”,策略优化才负责把这种比较信号转成新的生成分布。
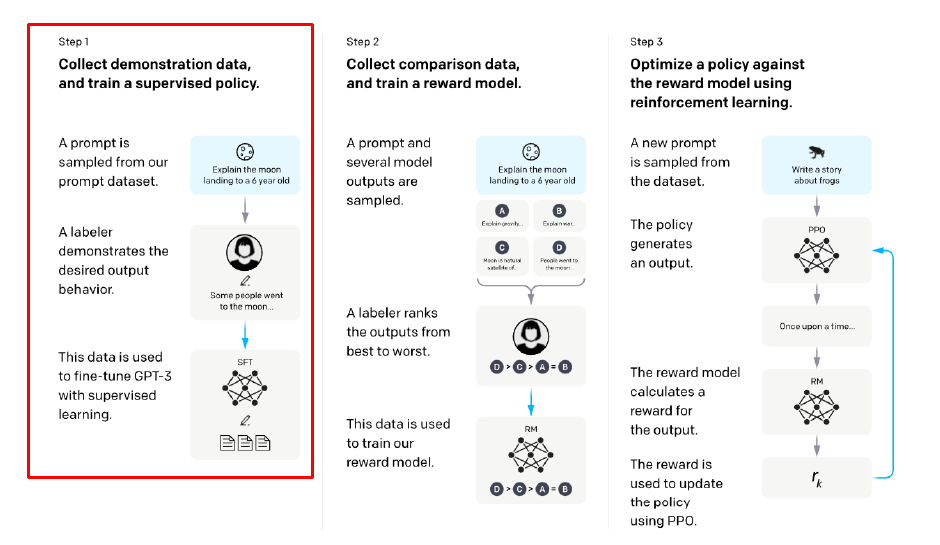
这条流水线也解释了为什么 SFT 仍然是后训练的地基。没有一个格式稳定、基本会遵循指令的初始策略,偏好标注者就要在大量明显错误的回答之间选择,奖励模型只能学习粗粒度差异,后续优化也更容易离开可靠分布。SFT 的目标不是一次完成所有对齐,而是先把预训练中已经存在但难以调用的能力,压缩到稳定、可预测的交互接口中。
SFT 的训练目标
把一段对话序列化为 \(z_{1:T}\),再用 \(m_t\in\{0,1\}\) 表示位置 \(t\) 是否计入损失,一个通用的 token-level 条件负对数似然可以写成:
response-only SFT 是常见选择:system prompt、用户消息和 padding 仍进入上下文,但对应的 \(m_t=0\),assistant 输出对应 \(m_t=1\)。这样训练信号要求模型根据完整上下文预测回答,而不是学习复述用户输入。多轮数据可以让每个 assistant turn 都参与损失,也可以只训练最后一轮;这是数据管线选择,不是 SFT 定义。
labels = input_ids.clone()
labels[assistant_mask == 0] = -100
loss = model(input_ids=input_ids, labels=labels).loss
也有实现除 padding 外对完整序列计损失。attention mask 控制哪些位置能被注意,loss mask 或 labels=-100 控制哪些位置进入交叉熵,两者不能混用;仅看到 outputs.loss 也无法推断采用了哪种 mask。无论选择哪种实现,模型学到的都是数据集的经验条件分布,而不是某个唯一、客观的“正确回答分布”。目标回答可以来自人工撰写、教师模型、规则系统、可执行验证器筛选,或它们的混合;SFT 并不要求样本必须由所谓 reference policy 生成。训练后的自回归模型依旧是归一化概率模型,也可以被解释为策略。SFT 与后续偏好优化真正不同的是监督信号和目标函数,而不是“一个是概率模型、另一个才是策略”。
指令数据如何演进
开放指令数据的演进,本质上是在扩大“可控行为”的覆盖面。FLAN 把已有 NLP 数据集改写成自然语言指令,证明任务模板可以把多任务监督汇聚到一个模型里;Self-Instruct 让强模型从少量人工种子扩写指令;Alpaca 进一步用 175 个种子构造约 5.2 万条教师示范;ShareGPT/Vicuna 与 OpenAssistant 则把数据重心推向更自然的多轮对话。到了 Tülu 和后续开放配方,数据不仅包含问答,还开始系统覆盖代码、推理、安全、结构化输出、函数调用和 Agent 工具轨迹。
数据形态 |
主要教会模型什么 |
常见风险 |
|---|---|---|
任务模板与 benchmark 改写 |
理解明确任务、输出短答案或固定标签 |
语气像考试题,难覆盖真实交互 |
教师模型合成示范 |
快速扩展任务与表达方式 |
继承教师偏差、幻觉和单一风格 |
真实多轮对话 |
上下文承接、澄清、详细解释 |
隐私、许可、噪声和不可验证事实 |
工具调用与 Agent 轨迹 |
何时调用工具、参数如何组织、怎样利用反馈继续行动 |
工具协议泄漏、执行环境漂移、错误轨迹被模仿 |
数据规模只是其中一维。相同数量的样本,如果 prompt 分布、回答长度、是否多轮、是否带引用、是否包含拒答和工具反馈不同,训练出的“助手人格”和可执行能力会明显不同。真正可复用的数据合同至少应记录消息角色、模板版本、样本来源、教师模型与采样参数、工具 schema、验证结果以及许可证;否则模型行为变化很难追溯。
多维度评价
预训练模型已经见过列表、长文、引用、代码和对话,但 SFT 决定在什么请求下调用哪一种表达模式。回答长度、项目符号、开场白、引用格式、拒答语气以及是否主动补充背景,都会被 token-level loss 当作正式训练目标。因此,“chattiness”并非推理能力之外的一层皮肤,它直接进入生成分布。
这也造成评测错位。人类或 LLM judge 往往偏好更长、更完整、结构更清楚的回答;选择题、精确匹配和代码单测却未必奖励这些风格。在 Wang 等人对 LLaMA 13B 的特定实验中,不同单一指令集在 MMLU、GSM、BBH、TyDiQA、Codex-Eval 与 AlpacaEval 上互有胜负;Human+GPT 混合数据在表中平均指标为 45.2,高于同表各单一来源。它支持的是“多源混合在该设置下更均衡”,而不是“某个固定配比对所有模型都最优”。
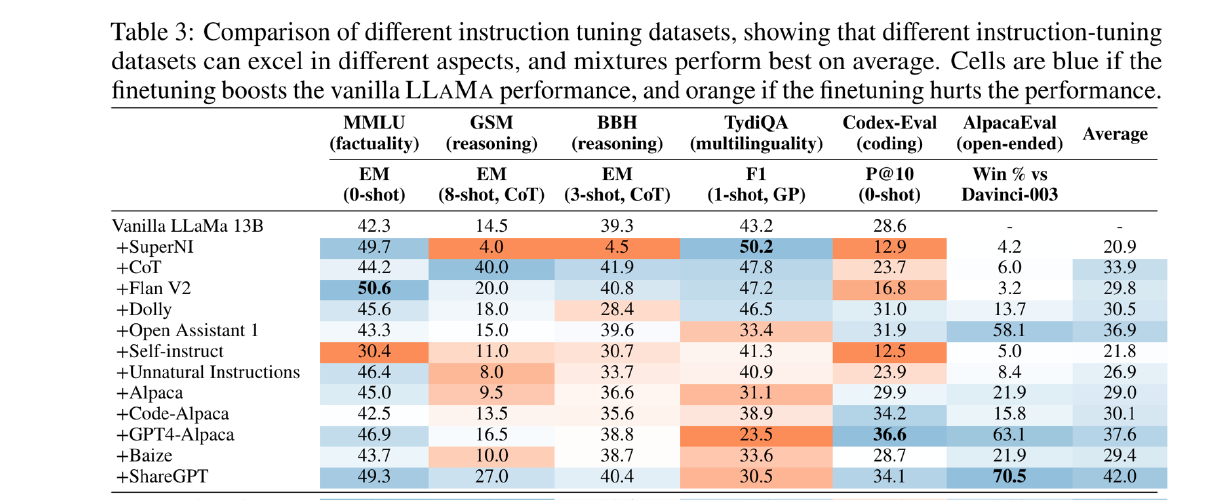
因此评测至少要把能力与呈现拆开:既报告可验证任务的正确率、通过率或事实性,也报告偏好胜率、平均长度、格式服从率与 length-controlled win rate。只看偏好分数,可能把“更啰嗦”误当成“更聪明”;只看短答案 benchmark,又可能漏掉真实产品需要的解释质量和交互稳定性。
SFT 更擅长抽取已有能力,而不是可靠写入陌生事实
一个带引用的高质量示范同时携带两种信号:回答应该引用资料,以及资料本身的事实内容。前者通常是行为模式,后者可能是模型预训练中从未稳定掌握的长尾知识。token loss 不会主动区分二者,它只要求目标序列更可能出现;于是模型可能学会“看起来像在引用”,却没有形成可验证的知识检索机制。
Gekhman 等人的受控实验进一步揭示了风险:与模型已有知识一致的微调样本学得更快;包含模型未知事实的样本学得更慢,而当这些未知样本最终被强行记住时,实验中模型的幻觉倾向随之上升。这不意味着“加入正确事实一定有害”,而是说明 SFT 不是可靠的知识数据库写入接口,尤其不适合把大量长尾、快速变化事实直接压进权重。
工程上可以把问题拆成三类。稳定、广泛且需要内化的知识,优先进入预训练或较长的 mid-training;可更新、可追溯的事实,优先由检索、数据库或工具在推理时提供;SFT 则重点教会模型何时检索、如何引用、如何承认不知道,以及如何把工具结果组织成回答。若确实要用 SFT 注入知识,应按“模型已知/未知”分层评测,配合 early stopping、事实验证和拒答测试,而不是只检查训练集 loss 是否下降。
安全行为很适合解释“少量高价值数据”的作用。模型并非完全不会拒绝危险请求,而是需要明确哪些场景应拒绝、拒绝到什么程度、怎样在不泄露危险细节的前提下提供安全替代方案。Safety-Tuned LLaMAs 的实验显示,在其数据与模型设置中,把约 3% 的安全示范——数百条样本——加入指令微调,就能显著改善多个安全评测;课程中的消融图显示,约 500 条后多项指标的边际收益已明显趋缓。
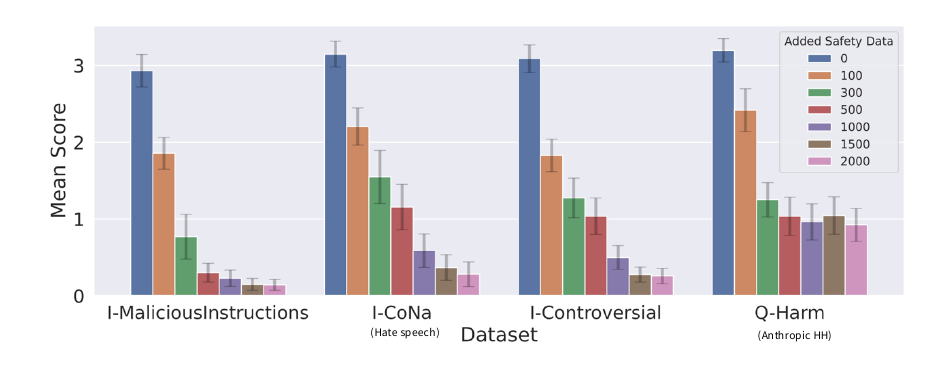
安全数据也不是越多越好。论文同时观察到,过强的安全微调会让模型对表面相似但无害的请求过度拒答。更稳妥的目标不是最大化拒答率,而是在 harmfulness 与 helpfulness 之间建立条件边界,并分别报告有害请求拦截率、良性请求误拒率和可用替代答案质量。
把 instruction tuning 前移:mid-training 的机会与代价
当指令数据和算力都足够多时,只在预训练结束后做一个很短的 SFT 阶段,可能遇到两类问题:高学习率会破坏预训练能力,低学习率又难以吸收复杂的新格式;同一批高质量数据反复训练,还会过拟合风格。两阶段或 mid-training 配方尝试把一部分指令、领域与长上下文数据提前混入预训练后段,再做较短的最终 SFT:
先用大规模通用语料学习语言、知识与基本能力;
在训练后段逐步混入指令、领域、长上下文或工具数据,同时保留一定通用语料;
最后用更干净、目标更明确的示范做短程 SFT,固定交互接口。
这种做法能让行为数据获得更充足的 token 预算,并用通用语料缓解灾难性遗忘,但它不是无条件收益。混合比例、学习率重启、上下文长度变化、数据重复 epoch 和领域漂移都会影响结果。MiniCPM、JetMoE 等公开工作披露了类似两阶段路线,产业资料仍较稀疏,因此更准确的说法是“它是已公开验证、也被广泛讨论的工业配方”,而不是断言绝大多数模型都采用完全相同的方法。
怎样判断一轮 SFT 是否真的成功
SFT 的损失下降只能证明模型更像训练答案,不能证明它更有用、更真实或更安全。上线前应把评测合同覆盖到至少五个维度:
维度 |
核心问题 |
示例指标 |
|---|---|---|
指令服从 |
是否遵守格式、语言、长度和约束 |
schema 通过率、格式遵循率、多轮状态保持 |
基础能力保留 |
有没有为了“会聊天”而忘掉原有能力 |
知识、推理、代码与多语言回归集 |
事实与校准 |
何时回答、何时检索、何时承认不确定 |
事实正确率、引用可验证率、拒答/置信度校准 |
安全与帮助性 |
有害请求能否拦截,良性请求是否被误伤 |
攻击成功率、误拒率、安全替代答案质量 |
风格与产品体验 |
胜率来自内容还是长度与模板偏好 |
raw/length-controlled win rate、平均 token 数、重复率 |
最终可以把 SFT 的职责压缩成一句话:它把预训练模型的潜在能力映射成产品需要的行为接口。样本越像目标交互、标签越可验证、数据合同越清晰,这个映射越稳定;若把陌生知识、价值判断和所有安全长尾都寄托在同一个交叉熵目标上,训练损失再漂亮,也很难得到可靠系统。