Scaling Laws:用小实验预测大模型
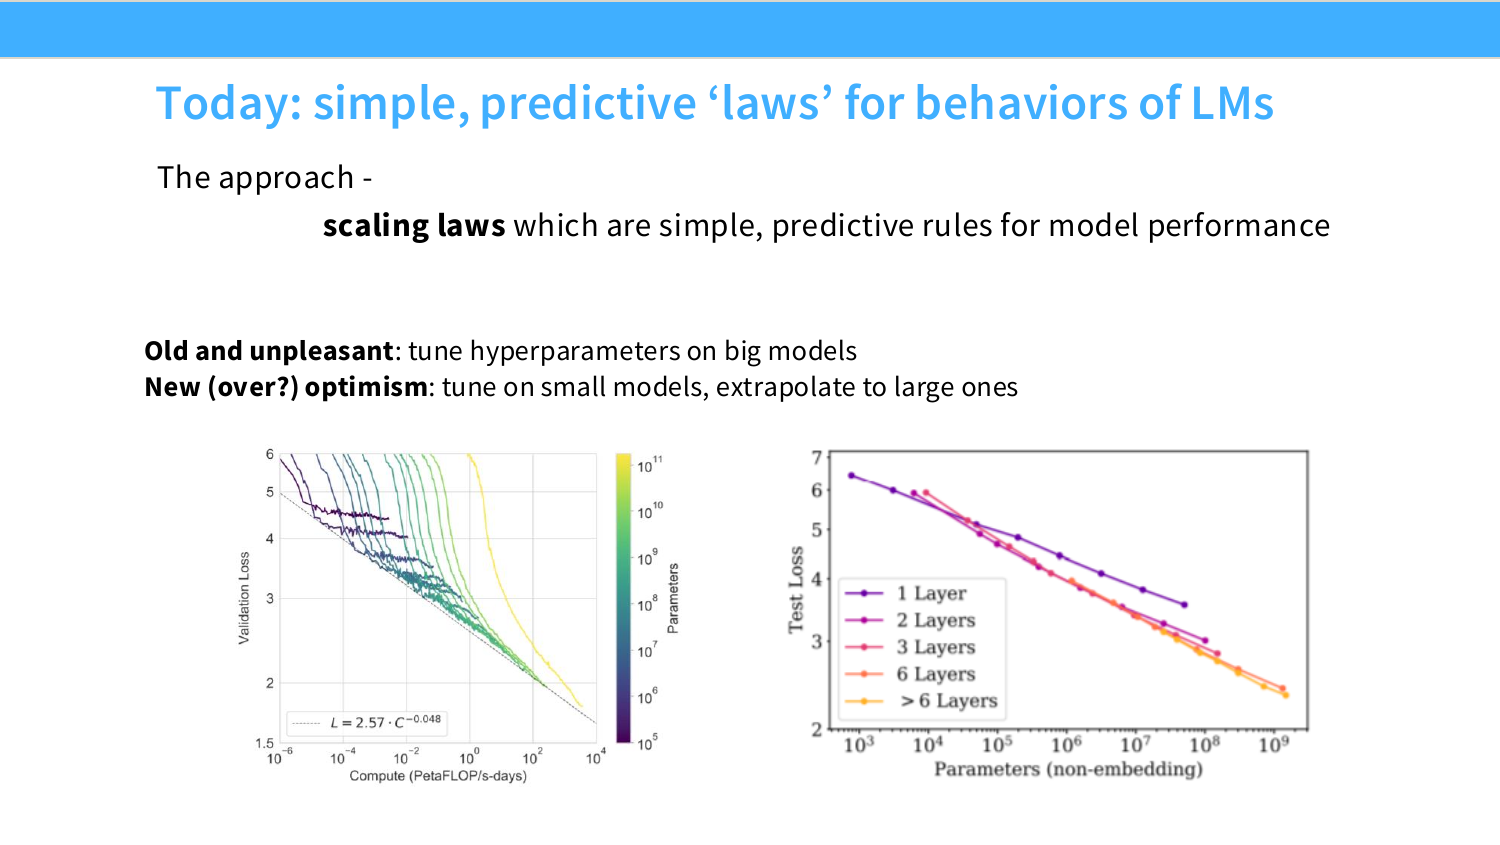
大模型训练最昂贵的地方,不只是一次训练会消耗多少 GPU 小时,而是很多关键选择在真正开跑前就必须决定。给定一批算力,要训练多大的模型、喂多少 token、batch size 该多大、学习率是否要随模型规模调整、Transformer 是否真的比另一种架构更值得投入,这些问题如果都靠大模型全量试错,成本会很快失控。
Scaling laws 的价值就在这里:用一组更小、更便宜的实验,拟合出模型性能随数据量、参数量、计算量变化的规律,再把这个规律外推到大规模训练。它不是“预测未来”的玄学,而是一套工程决策方法:先在可承受的 scale 上训练多个点,观察 loss 是否满足简单函数族,再用这个函数指导资源分配。
下图把问题设定讲得很直接:如果突然有一大批 GPU 可以使用,真正困难的不是“能不能启动训练”,而是如何在开训前做出足够好的模型设计和资源分配。
Scaling law 到底在预测什么
最常见的 scaling law 形式,是把某个误差或 loss 写成数据量 \(n\)、模型参数量 \(N\) 或训练计算量 \(C\) 的幂律函数。以数据 scaling 为例,可以写成:
这里 \(L(n)\) 是数据量为 \(n\) 时的测试 loss,\(L_{\infty}\) 是无限数据下仍然无法消除的不可约部分,\(A\) 是常数,\(\alpha\) 是 scaling exponent。这个式子最重要的含义是:当数据量翻倍时,loss 的下降不是固定减去一个常数,而是按幂律逐渐变慢。
把两边减去不可约项后取对数,可以看到为什么论文和 slide 经常展示 log-log 图:
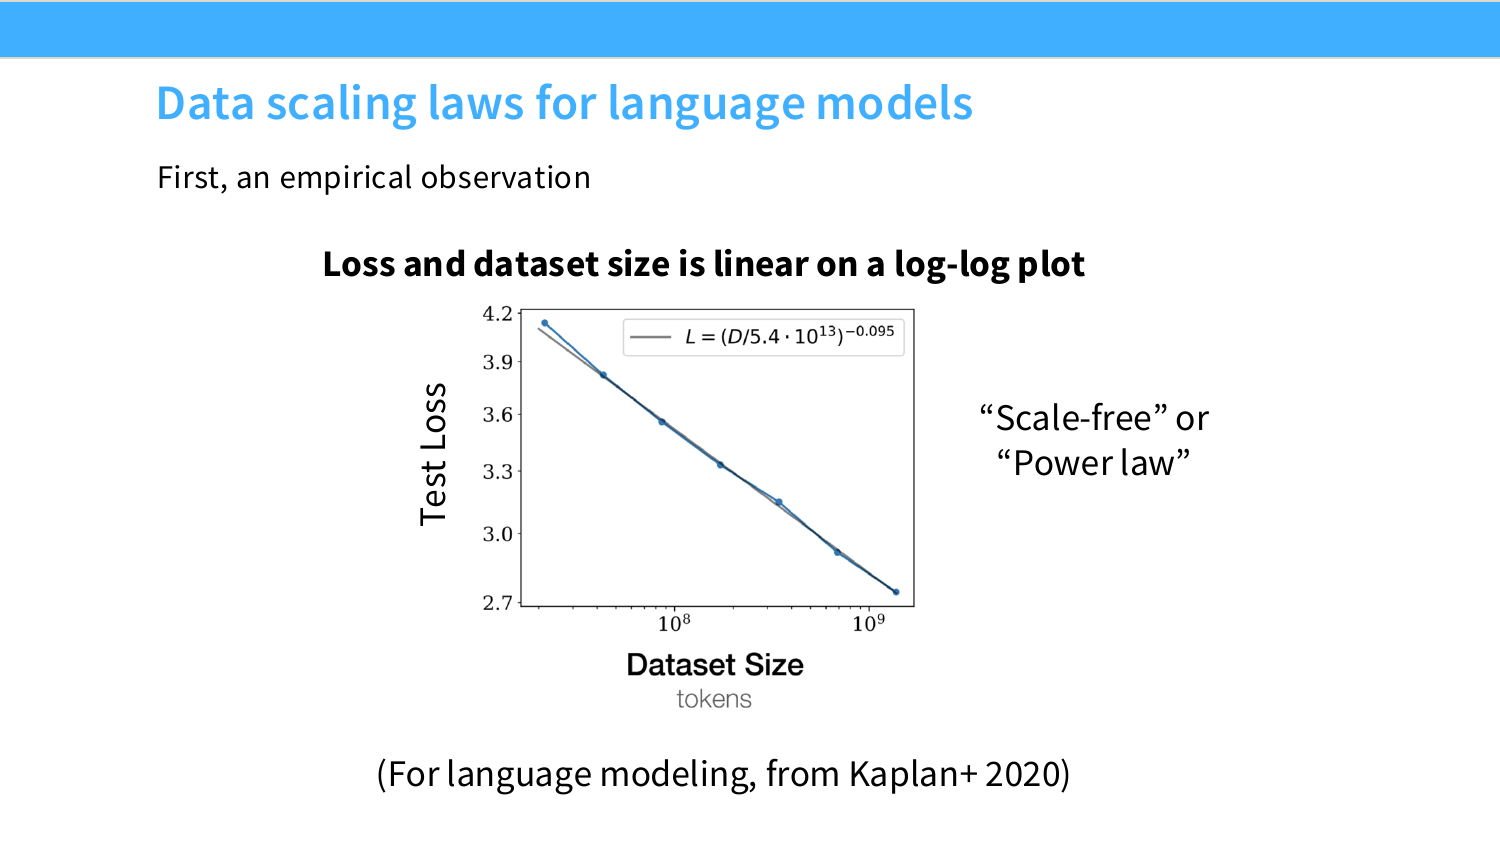
如果横轴是 \(\log n\),纵轴是 \(\log(L-L_{\infty})\),那么幂律会变成一条近似直线。直线斜率就是 \(-\alpha\)。所以 scaling law 的经验判断通常不是“曲线看起来顺滑”,而是“在对数坐标下是否近似线性”。
下图展示了语言模型里的典型现象:测试 loss 和数据量在 log-log 坐标下接近线性,这也是“scale-free”或“power law”说法的来源。
为什么会出现幂律:从均值估计开始
Scaling law 看起来像经验规律,但它和经典统计学习里的误差收敛速度有相通之处。先看一个最简单的均值估计问题。假设样本来自正态分布:
用样本均值估计真实均值:
这个估计器的均方误差是:
取对数后得到:
这就是一个最朴素的 scaling law:数据量增加,误差按 \(1/n\) 下降,在 log-log 图上是一条斜率为 \(-1\) 的直线。
下图用均值估计解释了 scaling law 的一个基础来源:很多统计估计问题天然会给出多项式收敛速度。
不过,神经网络的 scaling exponent 往往不是经典模型里简单的 \(1/n\)。机器翻译、语音识别、语言模型里的实测斜率可能明显不同。这说明“误差会随数据幂律下降”只是第一层直觉,真正的 exponent 还取决于数据分布、任务结构、模型类别、优化过程和表示能力。
数据不是只看数量:composition、重复和有限数据
如果 scaling law 只告诉我们“更多数据更好”,它对工程决策的帮助有限。真正困难的是:不同数据源的质量、分布和重复率不同,新增 token 不一定等价。
可以把数据 scaling 的一个简化形式写成:
其中 \(A\) 不只是数学常数,也可以理解为数据分布和数据质量带来的 offset。改变数据 mixture,可能不改变幂律斜率的大方向,却会让整条曲线上下平移。换句话说,同样数量的 token,如果数据质量更高、分布更匹配,可能从一开始就处在更低的 loss 曲线上。
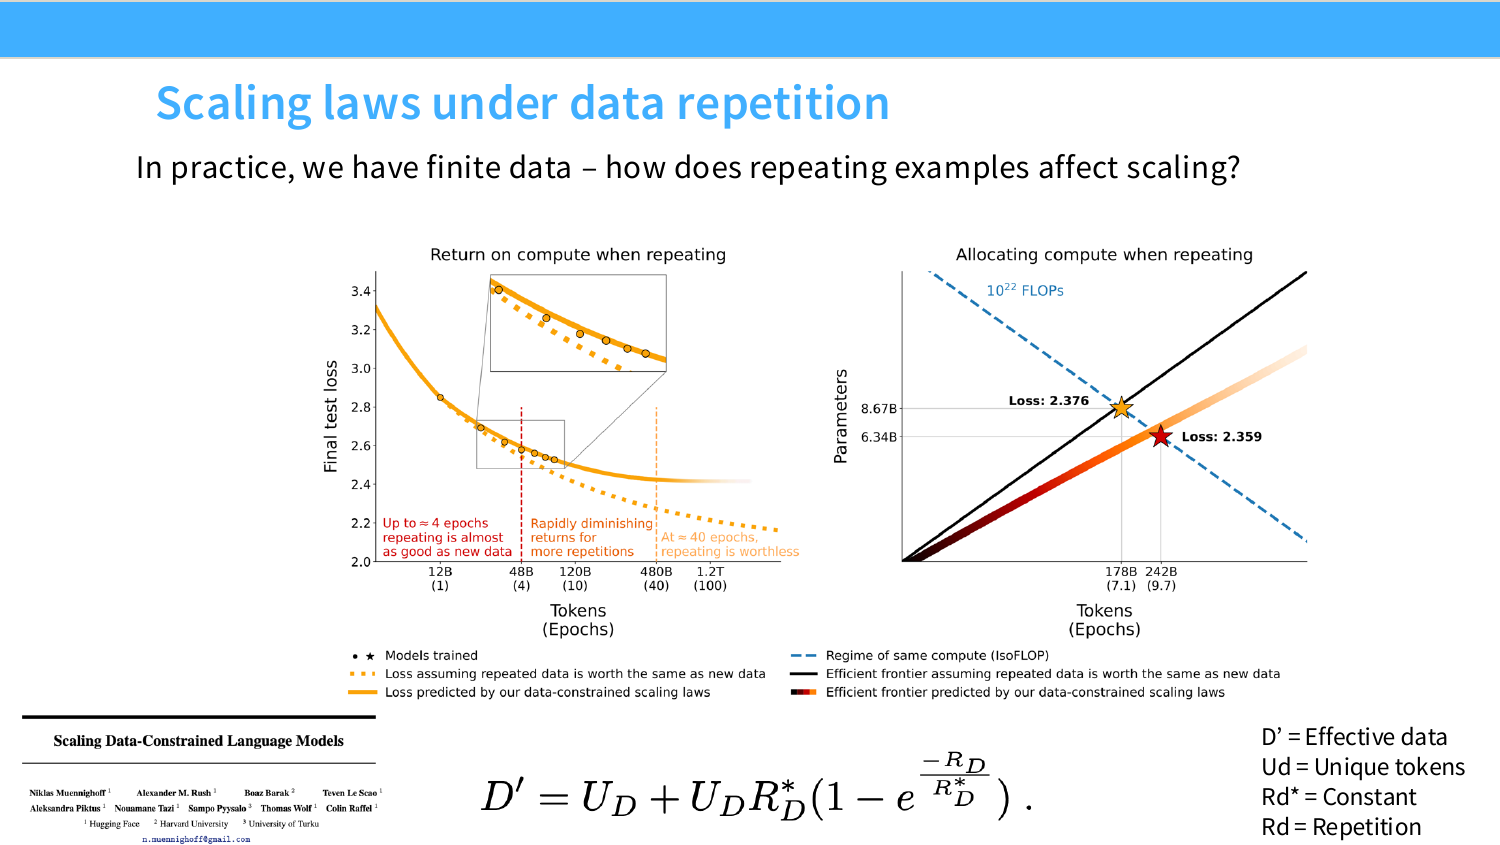
重复数据会让问题更复杂。训练 token 数 \(D\) 增加,不等于唯一信息量线性增加。设唯一 token 数为 \(U_D\),重复次数为 \(R_D\),那么有效数据量 \(D_{\mathrm{eff}}\) 通常小于简单乘积:
这不是说重复一定无用。重复可以帮助优化过程更充分地利用已有数据,尤其在数据稀缺或训练预算较小时。但重复的边际价值会下降,重复到一定程度后,模型看到的是越来越少的新信息。工程上应把“训练 token 数”和“唯一、高质量、覆盖目标分布的数据量”分开记账。
下图展示了有限数据和重复训练下的 scaling 问题。它提醒我们,数据选择不能只按小模型上的最佳结果静态决定,而应随目标 scale 调整。
这也是为什么数据 selection scaling 很难。小模型上表现最好的数据 mixture,不一定在大模型或更长训练上仍然最优。小模型可能更偏好高密度、容易拟合的数据,大模型则可能更需要覆盖更广、更难、更丰富的分布。Scaling law 能给出预测框架,但数据策略本身仍然需要实验闭环。
从数据 scaling 到模型工程:小模型实验可以回答大模型问题
Scaling laws 更直接的工程用途,是减少大模型设计的盲试成本。比如要比较 Transformer 和 LSTM,最粗暴的方式是分别训练一个 GPT-3 规模模型,然后看结果;但这基本不可承受。更可行的方法是训练一组小模型,拟合每种架构的 scaling 曲线,再预测它们在大规模计算下的交点或差距。
同样的思路也可以用于 optimizer、深度宽度比例、batch size、学习率策略等问题。流程可以抽象成:
在较小 scale 上训练多个候选配置,覆盖模型大小、数据量或计算量的不同点。
为每个候选配置拟合相同形式的 scaling law。
把曲线外推到目标训练预算,选择预测 loss 更低、成本更可控的配置。
这个方法的前提是候选配置之间的 scaling 行为足够稳定。比如 optimizer A 在小模型上只是略好,但它的曲线斜率更优,那么大模型上优势可能变大;反过来,小模型上领先的配置如果斜率差,到了大模型可能被反超。
需要特别注意,“参数量”也不是完全同质的。Embedding 参数、attention/MLP 参数、MoE expert 参数对 loss 的贡献方式并不一样。把所有参数简单加总成 \(N\) 是第一阶近似,但在 tokenizer、词表、MoE、长上下文等设置变化时,参数的“价值”会改变。
Critical batch size:batch 不是越大越好
Batch size 也是 scaling law 能帮助决策的地方。大 batch 会提高硬件利用率,减少每个 token 分摊的调度和通信开销;但超过某个点后,继续增大 batch 对减少训练步数的帮助会变小。这就是 critical batch size 的直觉:在某个目标 loss 附近,batch 增大到一定值后出现明显 diminishing returns。
更精确地说,可以固定一个目标 loss,然后用不同 batch size 训练,记录达到该 loss 所需的 optimizer steps \(S\) 和训练 examples \(E\)。一个常见经验模型是:
对应训练样本数为:
这里 \(S_{\min}\) 表示 batch 极大时仍然需要的最少 step 数,\(E_{\min}\) 表示 batch 极小时接近最优 sample efficiency 所需的样本数。二者平衡的位置给出 critical batch size:
当 \(B=B_{\mathrm{crit}}\) 时:
这个点的意义是折中:步数不会比极大 batch 的理论下限多太多,样本效率也不会比极小 batch 的理论下限差太多。它不是唯一正确的 batch size,但给了一个计算效率和统计效率之间的可解释选择。
随着目标 loss 降低,也就是训练进入更高能力区域,critical batch size 往往会变大。直觉上,模型越强、梯度噪声相对越大,就越能从更大的 batch 中受益;但这仍然要和硬件利用率、显存、并行通信一起算。
学习率和参数化也要随 scale 调整
把一个小模型配置直接放大到大模型,并不保证学习率仍然合适。不同层宽、初始化尺度、残差路径和 optimizer 超参数会改变训练动态。简单地说,模型变大时,参数更新的有效尺度也会变。
如果不考虑这一点,大模型上的“最佳学习率”可能随 scale 漂移,导致小模型 sweep 得出的结论不能可靠外推。muP 和 scale-aware learning rate 的目标,是让不同宽度模型之间的更新尺度具有可比性。这样小模型上的学习率选择,才更有机会迁移到大模型。
可以把这件事理解为 scaling law 实验的控制变量问题。要比较架构、optimizer 或数据配比,首先要确保不同 scale 下的训练动力学没有被学习率和初始化无意中扭曲。否则你拟合到的不是模型能力随规模增长的规律,而是某个不合适训练设置在大模型上崩坏的规律。
联合 scaling:数据和模型要一起优化
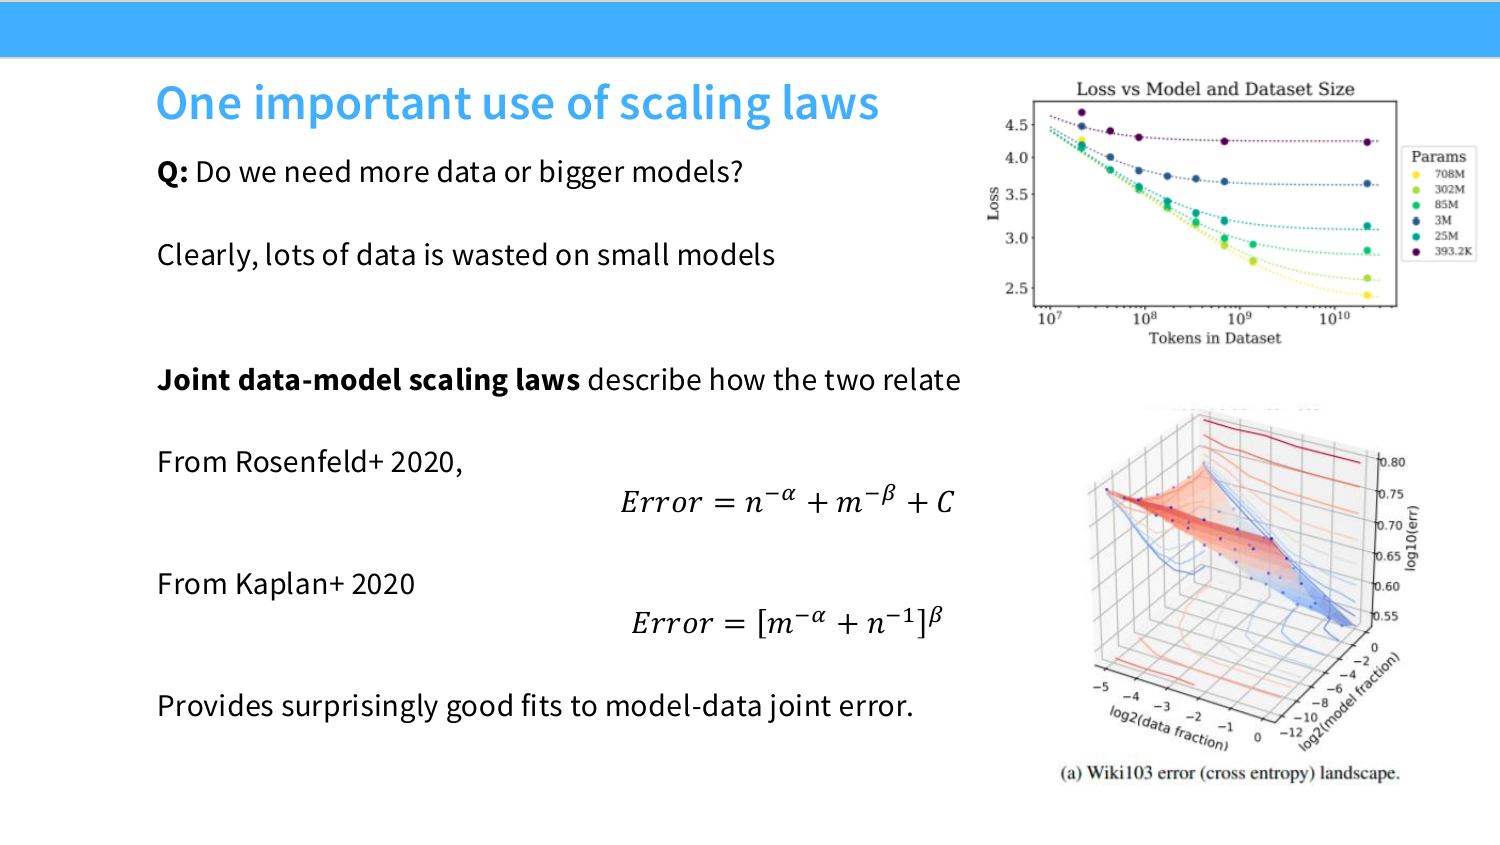
实际训练预算通常不是“只增加数据”或“只增加模型”。更常见的问题是:在固定训练计算量下,应该训练一个更大的模型、喂较少 token,还是训练一个较小模型、喂更多 token?这需要 joint data-model scaling law。
一种简化写法是:
其中 \(N\) 是非 embedding 或总参数量,\(D\) 是训练 token 数,\(\alpha\) 和 \(\beta\) 分别描述模型规模和数据规模带来的边际收益。训练计算量可以粗略写成:
其中 \(k\) 是和架构、前后向计算账本相关的常数。于是问题变成一个受约束优化:
这个形式的直觉很清楚:模型太小,即使用大量数据训练也会受 capacity 限制;模型太大,数据太少时又会欠训练。最优点应该同时平衡模型项 \(A N^{-\alpha}\) 和数据项 \(B D^{-\beta}\) 的边际收益。
下图展示 joint scaling law 的用途:它把“更多数据还是更大模型”变成一个可以拟合、预测和优化的问题。
Chinchilla 和 IsoFLOPS:固定算力下找最优模型大小
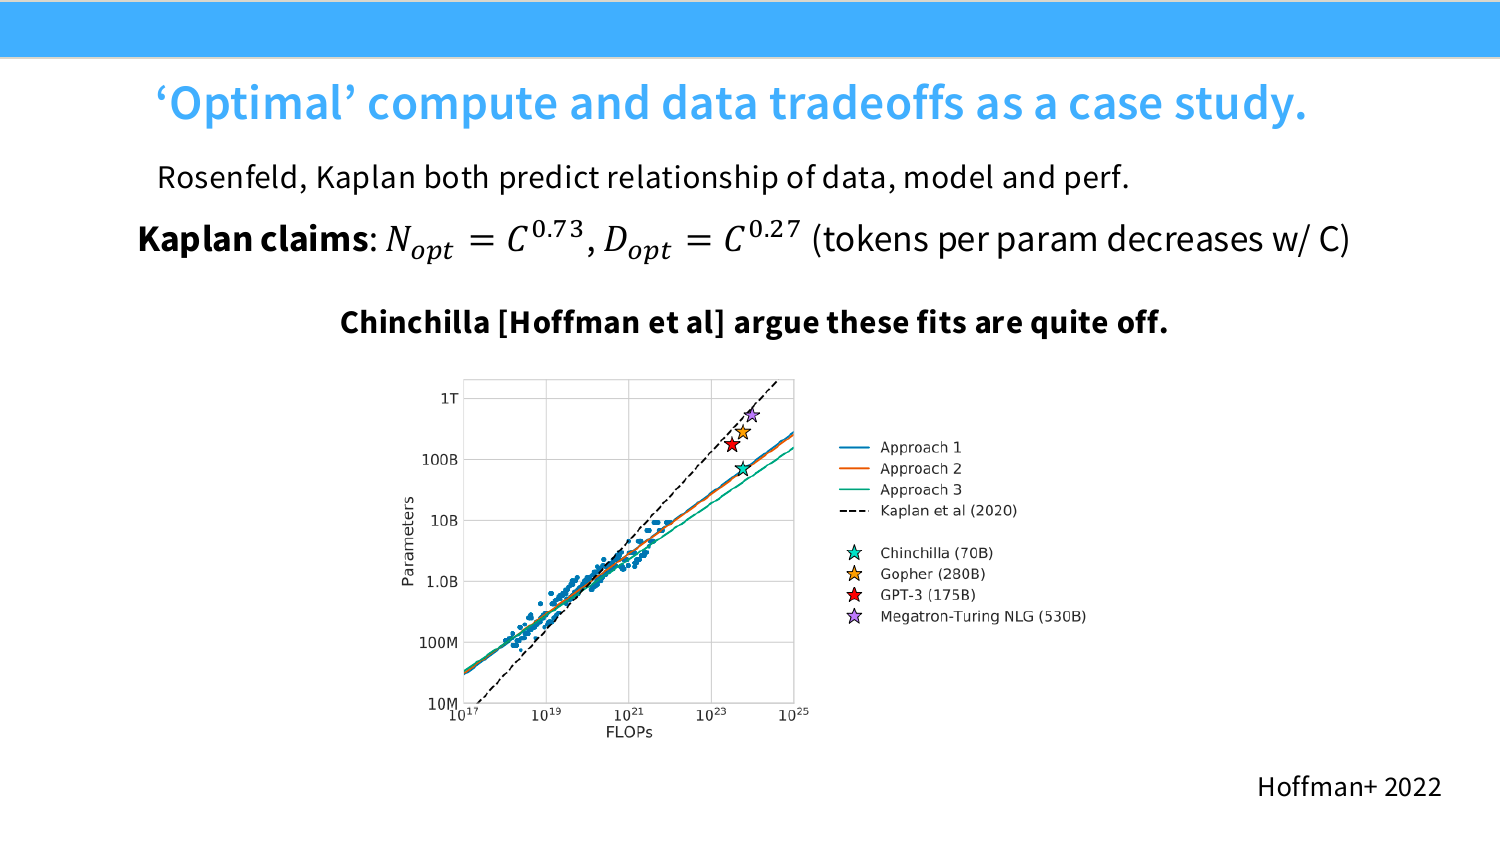
Kaplan scaling laws 和 Chinchilla 的差异,是大模型训练史上最重要的 scaling law 案例之一。Kaplan 的结论可以概括为:随着训练计算量 \(C\) 增长,compute-optimal 参数量增长很快,数据量增长较慢:
这意味着 token per parameter 会随算力变大而下降。Chinchilla 则认为这个结论明显低估了数据量的重要性,实际 compute-optimal 训练更接近同时扩大模型和数据,也就是常见说法里的约 \(20\) tokens per parameter。
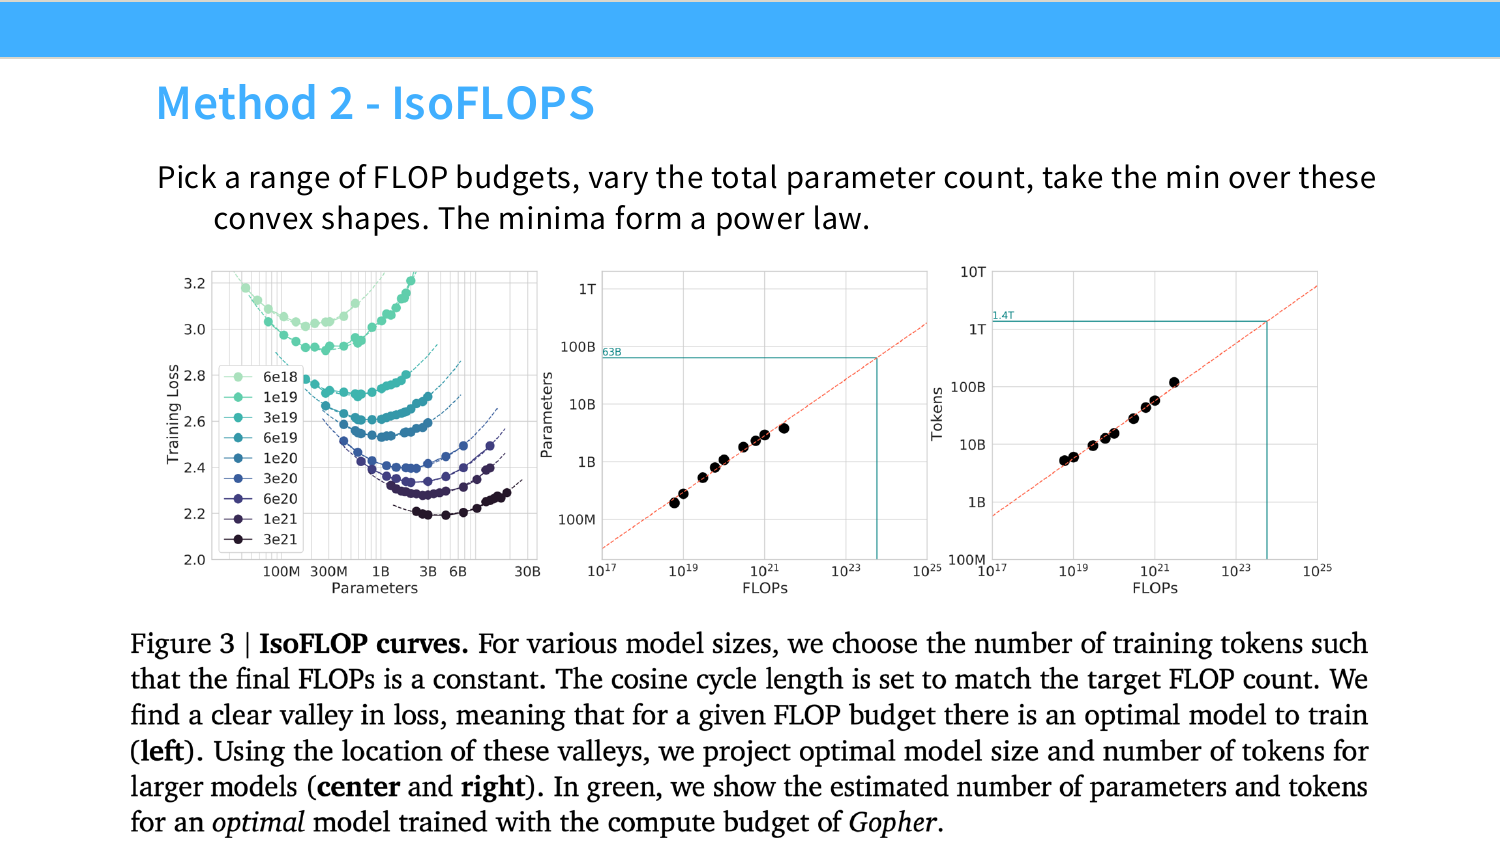
Chinchilla 使用了三类拟合方法。第一类是 minimum over runs:把不同训练曲线放在一起,在每个 compute budget 下取最低 loss,观察这些最优点是否形成幂律。第二类是 IsoFLOPS:固定一组 FLOP budgets,在每个预算内扫不同模型大小,取 loss 最低的模型,再看这些最优模型大小如何随 compute 增长。第三类是 joint fits:在模型大小和数据量网格上训练多组模型,用最小二乘拟合联合 scaling law。
下图展示 Kaplan 和 Chinchilla 在 compute-data tradeoff 上的核心分歧:同样是拟合 scaling law,数据处理、参数计数、warmup 和拟合方法差异都可能改变最终结论。
IsoFLOPS 的好处是工程上很直接。给定一个 FLOP 预算 \(C_j\),训练多个不同 \(N\) 的模型,并让数据量满足近似约束:
在这个预算下,loss 随 \(N\) 往往呈现一个凸形趋势:模型太小,capacity 不够;模型太大,token 不够。取每个预算的最小点,就能得到 compute-optimal 的模型规模曲线。
下图展示 IsoFLOPS 的做法:每条曲线对应固定计算预算,曲线最低点构成新的 scaling law。
Joint fit 则更像直接拟合前面的二维函数:
它利用更多网格点,但也更依赖函数形式和数据质量。后续有工作指出,原始 Chinchilla method 3 的数据处理可能存在问题,重新恢复数据再拟合后,结果更接近 method 1 和 method 2。这提醒我们:scaling law 不是只要画出直线就结束,数据选择、计数口径和拟合细节会直接影响结论。
Train-optimal 不等于产品最优
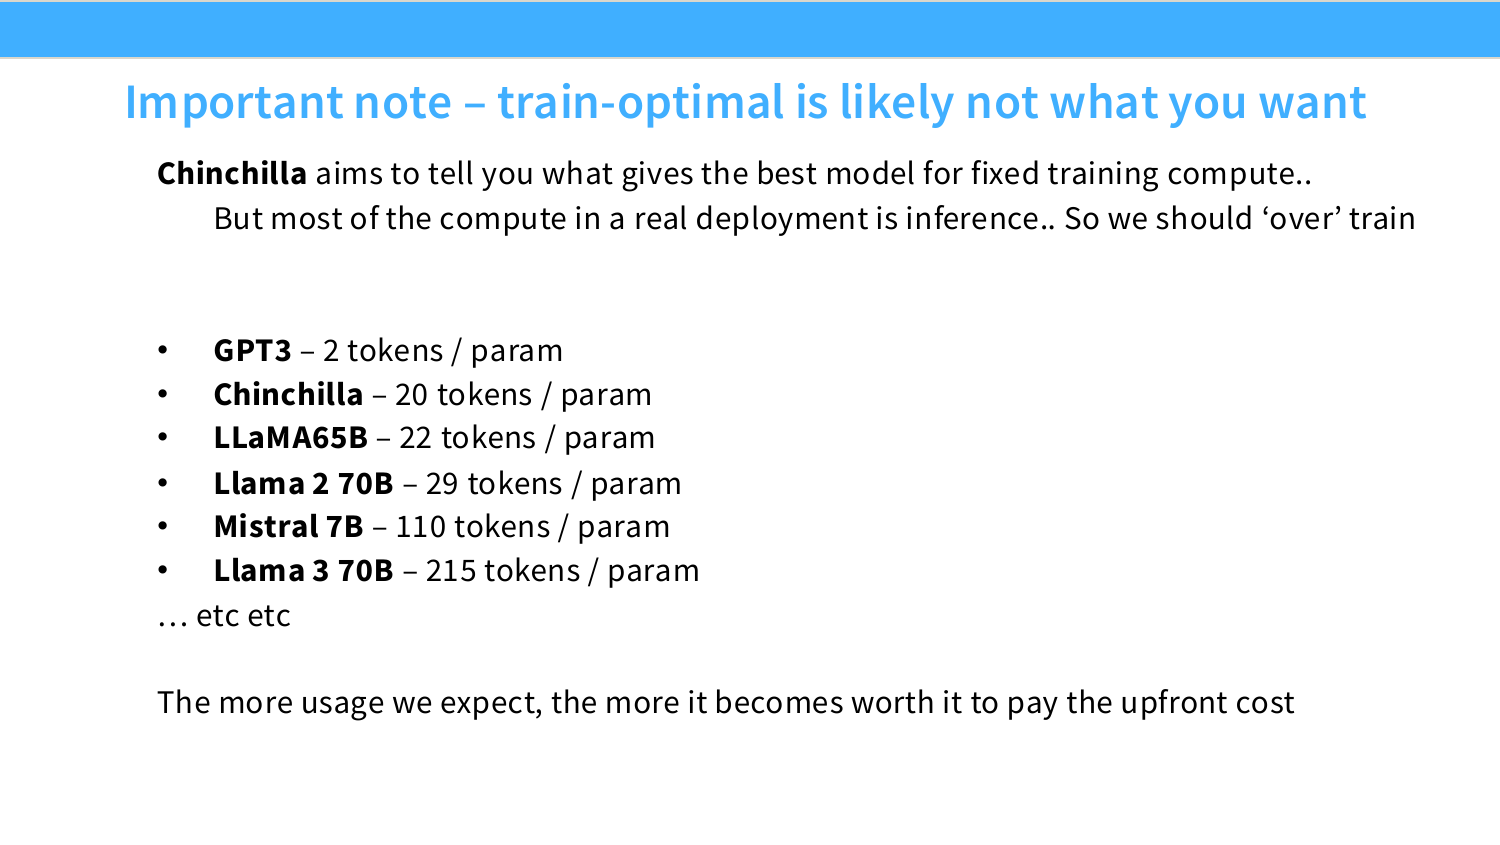
Chinchilla 讨论的是固定训练计算量下,怎样得到训练 loss 最优的模型。但真实产品还要考虑推理计算。训练只做一次,推理会发生很多次;如果预期模型会被大量调用,训练一个更小但喂更多 token 的模型,可能在总成本上更划算。
可以把总成本粗略写成:
其中 \(Q\) 是未来推理请求或 token 数,\(C_{\mathrm{infer}}(N)\) 随模型参数量增加。对于训练最优点来说,增大模型可能更快降低训练 loss;但对部署来说,较大的 \(N\) 会让每次推理都更贵。如果 \(Q\) 很大,就值得多花训练 token,把模型“overtrain”到更高 token per parameter,从而降低推理侧成本。
下图列出了一些模型的 tokens per parameter。可以看到,从 GPT-3 到 Llama 3,许多真实模型明显超过 Chinchilla 的训练最优比例,这背后很大一部分原因就是部署侧推理成本。
怎么把 scaling laws 用到训练决策里
把 scaling laws 当成工程工具时,最稳妥的流程不是直接套某篇论文的 exponent,而是用自己的模型、数据和训练栈拟合一版局部规律。
先定义要预测的指标。通常用 validation loss 或 held-out loss;如果关心下游任务,要单独记录下游指标,因为下游 scaling 往往更不稳定。
设计小规模实验网格。至少覆盖多个模型大小、数据量或 FLOP budget,保证能观察斜率,而不是只比较两个点。
控制训练动力学。学习率、warmup、batch size、optimizer、参数化方式要随 scale 合理调整,否则拟合会混入训练不稳定因素。
拟合简单函数族。优先从 \(L_{\infty}+A N^{-\alpha}+B D^{-\beta}\) 这类可解释形式开始,再检查残差是否系统性偏离。
用外推做决策,但保留验证点。在接近目标规模的位置训练少量中等模型,确认外推没有明显失效。
下图总结了 scaling laws 的工程收益:它能帮助选择 optimizer、架构、模型大小,也能回答大模型和更多数据之间的资源权衡。
最后要保留一个边界意识。Scaling laws 对预训练 loss 往往很有用,但它不能自动解决数据质量、评测污染、对齐训练、工具使用、推理延迟、长上下文质量和产品指标等问题。它给的是资源分配的坐标系,不是完整的模型成功保证。
Scaling laws 最重要的直觉可以压缩成一句话:先用小实验估计斜率,再用斜率决定大预算该投向哪里。没有这张图,训练大模型很容易变成凭经验押注;有了这张图,至少可以把“更大模型”“更多数据”“更久训练”“更小推理成本”放进同一个可计算的决策框架里。