多模态大模型的编码、对齐与统一生成
语言模型最熟悉的世界,是一串离散文本 token。现实世界却由像素、声音、视频和动作共同构成。要让 Transformer 处理这些信号,关键并不是给它贴上“多模态”标签,而是解决三个接口问题:非文本信号怎样压缩成 token,token 怎样保留空间与时间结构,以及模型怎样把内部表示重新还原成非文本输出。
本章以 CLIP、SigLIP、LLaVA、LLaVA-OneVision、Qwen-VL 系列和 Chameleon 的一手论文,从损失函数、张量形状、视觉 token 预算与训练稳定性出发,拆解现代多模态模型的两条技术路线。第一条把图像编码成连续语义特征,接入语言模型完成理解;第二条把图像量化成离散视觉 token,让同一个自回归模型既能理解,也能生成。二者共享 Transformer 接口,却优化着不同的信息目标。
多模态理解与多模态生成
多模态理解的典型任务,是输入图像或视频,输出文本答案。它更关心语义:画面里有什么、物体之间是什么关系、文档中的文字表达了什么。只要视觉编码器能把这些信息变成语言模型可消费的连续向量,模型就可以继续使用熟悉的自回归文本解码。
多模态生成则要求模型输出图像、音频或视频。连续视觉特征本身不是像素,也没有天然的逆变换;典型的“视觉编码器 + projector + LLM”系统因此还需要额外生成头,例如扩散解码器。另一种做法是先把图像量化成有限词表中的离散索引,再像生成文本一样逐 token 预测,最后用图像解码器恢复像素。
路线 |
进入 Transformer 的表示 |
最自然的能力 |
主要代价 |
|---|---|---|---|
连续视觉编码 |
ViT/CLIP/SigLIP 的浮点特征 |
分类、检索、问答、OCR、视觉推理 |
需要 projector;若要生成图像,还需额外解码路径 |
离散视觉 token |
码本中的整数索引 |
统一的图文理解与自回归生成 |
量化带来重建瓶颈,视觉序列长、熵高 |
这一区分解释了为什么“统一 token 接口”并不等于“统一信息表示”。用于检索的表示可以主动丢弃纹理、字号和像素级细节,只保留语义;用于生成的表示则必须保留足够细节,使解码器能够重建图像。理解与生成可以共享骨干,但对 tokenizer 的要求并不相同。
CLIP:用双向对比学习建立视觉—语言坐标系
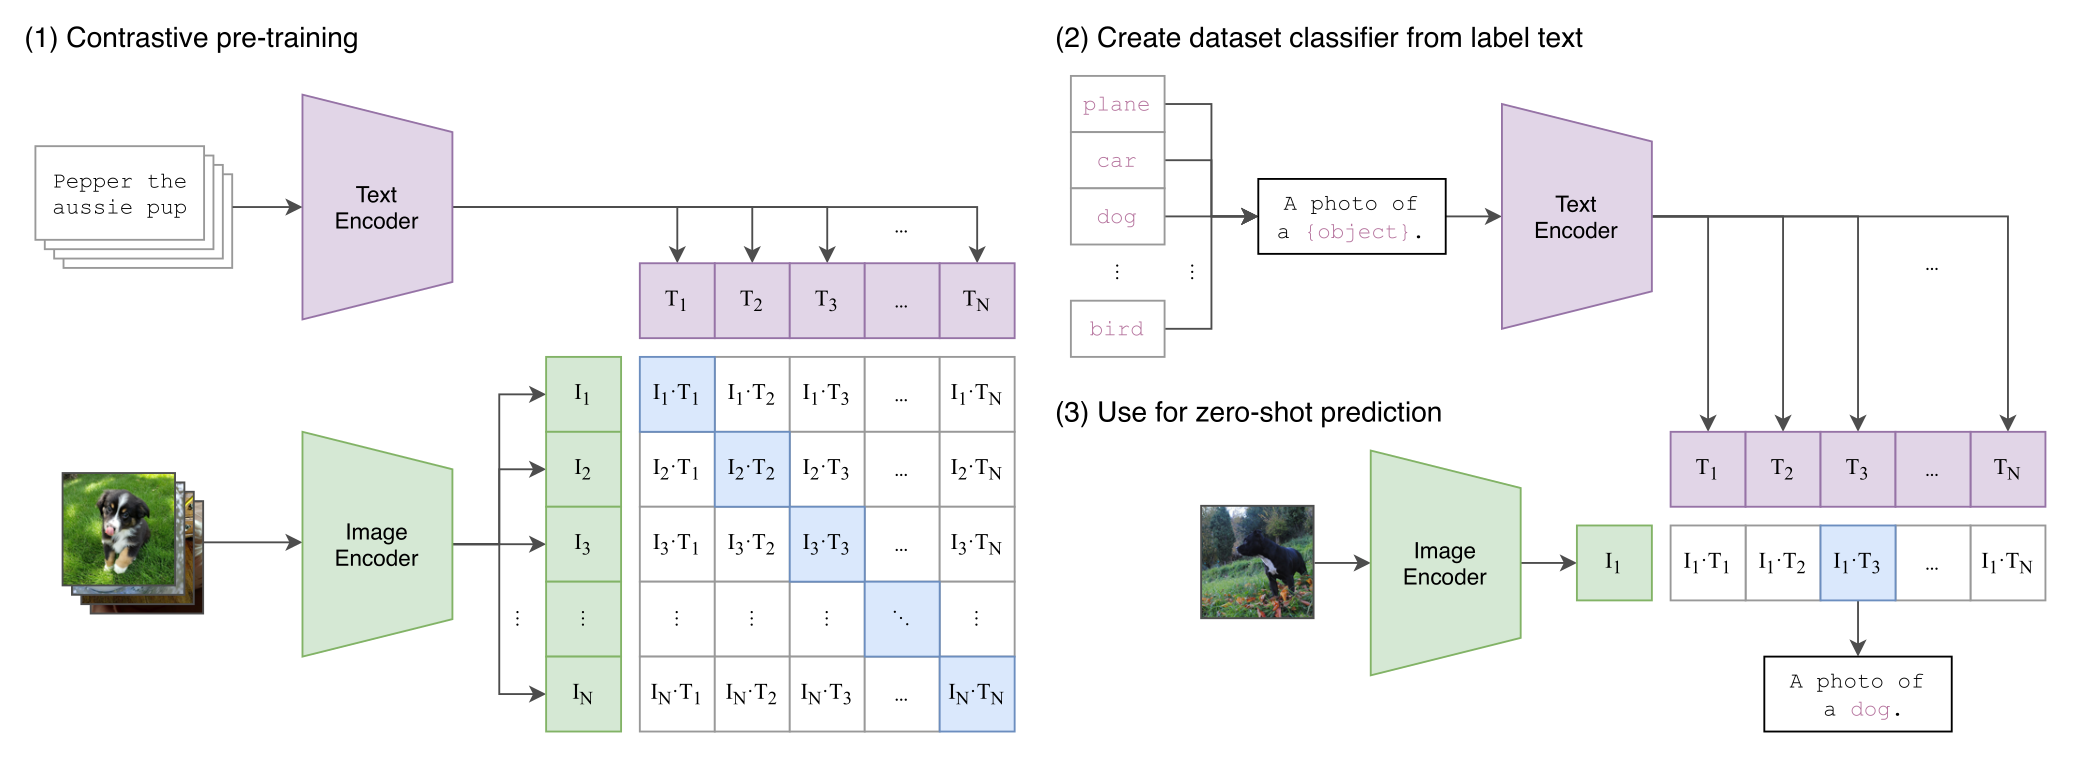
CLIP 的起点不是为每张图片人工标注一个封闭类别,而是利用互联网上已有的图文配对。给定一个包含 \(B\) 对样本的 batch,图像编码器和文本编码器分别输出向量,再做 L2 归一化:
第 \(i\) 张图与第 \(j\) 段文本的相似度为:
其中 \(\tau\) 是温度。一个 batch 会形成 \(B\times B\) 的相似度矩阵;对角线是观测到的正配对,其余位置被当作 batch 内负样本。CLIP 同时做“给图找文”和“给文找图”两次交叉熵:
这比“看图逐词生成 caption”更直接:训练信号只要求配对样本在共享空间里彼此靠近,不必为每个 caption 的所有 token 建模。CLIP 使用 4 亿图文对、32,768 的大 batch 训练;论文中的最佳版本为 ViT-L/14@336px,即先在 224 像素分辨率训练 ViT-L/14,再以 336 像素额外训练一个 epoch。大 batch 的价值在于一次更新能看到更多错配候选,但代价是全局相似度矩阵、跨设备通信和假负样本。
零样本分类由同一空间自然导出。把类别写成模板文本,例如 “a photo of a dog”,编码为向量并与待测图像比较相似度,类别文本就相当于动态生成的线性分类器权重。CLIP 在 ImageNet 上达到 76.2% 零样本准确率,与原始监督训练的 ResNet-50 相当;这个结果证明自然语言监督可以迁移到新类别,却不意味着其表示保留了 OCR、定位或细粒度计数所需的全部信息。
SigLIP:把全局 softmax 改成逐对二元判断
CLIP 的每一行和每一列都需要在整个 batch 上归一化。SigLIP 把问题改写成独立二元分类:图文是否配对?定义 \(y_{ij}=1\) 表示正配对、\(y_{ij}=-1\) 表示负配对,并令 \(t\) 与 \(b\) 为可学习的尺度和偏置:
这里仍然存在 \(B^2\) 个正负配对,计算并没有凭空消失。真正改变的是依赖关系:每个配对项不需要知道全局 softmax 的分母,于是可以把相似度矩阵切成小块。设备先计算本地正样本和负样本,再轮转另一模态的 embedding 覆盖跨设备负样本,最后归约局部 loss;不必同时物化完整矩阵,也不必为数值稳定计算全局最大值。
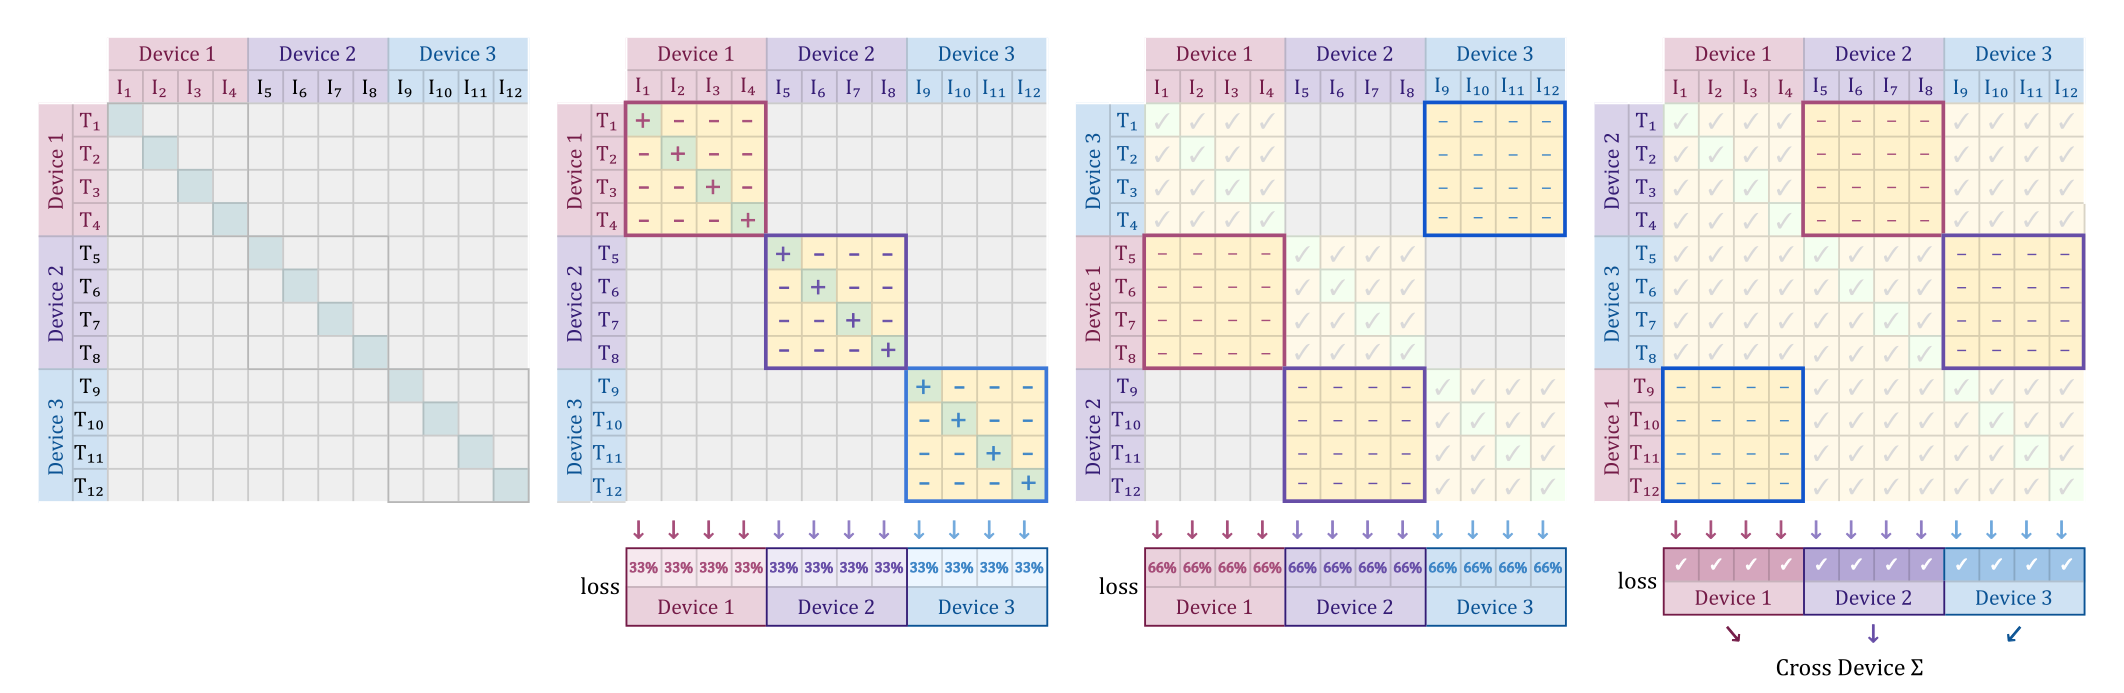
在小于约 16K 的 batch 下,sigmoid loss 明显优于对应的 softmax 基线。需要区分的是,100 万 batch 的极限规模实验采用 SigLiT:锁定预训练图像塔,只训练文本塔;这并不是 from-scratch SigLIP 的百万 batch 结果。综合 SigLiT、SigLIP 与多语言实验,两类损失随 batch 增大的收益都会较快饱和,约 32K 通常已是足够合理的规模。SigLIP 的 from-scratch 配置以 32 个 TPUv4 训练 5 天达到 73.4% ImageNet 零样本准确率,而论文引用的 CLIP 训练约使用 256 个 TPUv3、10 天。硬件代际、模型、数据和精度并不相同,因此这组数字说明的是更友好的分布式损失与资源可达性,不能直接写成严格的端到端加速倍数。
CLIP 与 SigLIP 学到的都是被文本监督塑形的视觉语义。caption 若只说“狗在草地上”,编码器没有理由完整保留毛发纹理或角落的小字;而 batch 内不同图片也可能描述同一概念,被误当成负样本。它们非常适合作为多模态理解的视觉底座,但表示能力仍受数据文本、裁剪策略与对比目标共同约束。
视觉 token 账本:分辨率如何变成计算量
Vision Transformer(ViT)把一张 \(H\times W\) 图像切成边长为 \(P\) 的 patch。若尺寸都能整除,patch 数为:
以 patch size 14 为例,224×224 图像产生 \(16\times16=256\) 个 patch;336×336 则产生 \(24\times24=576\) 个 patch。线性提高边长会平方增加 token 数,而标准全注意力的主要交互量又近似随序列长度平方增长:
因此,提高分辨率不是免费的“看得更清楚”。它既增加视觉编码器内部成本,也会在视觉 token 接入 LLM 后挤占上下文窗口和 KV cache。工程设计通常要在三种手段间权衡:缩小或裁剪输入、合并相邻视觉 token、保留高分辨率局部切片但对最终序列做预算控制。
Qwen2-VL 的 66 token 是一个很好的手算例子。一张 224×224 静态图像在论文的统一时空预处理下复制为两个相同帧,经 temporal patch depth 2 后时间维仍为 1;patch size 14 的 ViT 得到 \(16\times16=256\) 个空间特征,随后每个 2×2 邻域合并成一个 token,得到 \(256/4=64\) 个视觉 token。再加 <|vision_start|> 和 <|vision_end|> 两个边界 token,总数才是 66。这里的 224×224 指整张图,而不是“每个 patch 有 224×224 像素”。
LLaVA:一个 projector 如何让 LLM 开始“看图”
LLaVA 展示了最简洁、也最有影响力的视觉语言模型模板。视觉编码器把图像 \(X_v\) 变成网格特征:
训练一个投影矩阵 \(W\in\mathbb R^{d_v\times d_{\mathrm{LM}}}\),把视觉特征映射到语言模型词向量空间:
这些连续向量不是词表中的离散 ID,却与文本 embedding 具有相同维度,因此可以作为一段“软 token”插入提示词前后。LLM 无需新增一种注意力算子,只需在同一个因果序列里同时关注视觉 token 与用户问题,再逐 token 生成文本回答。
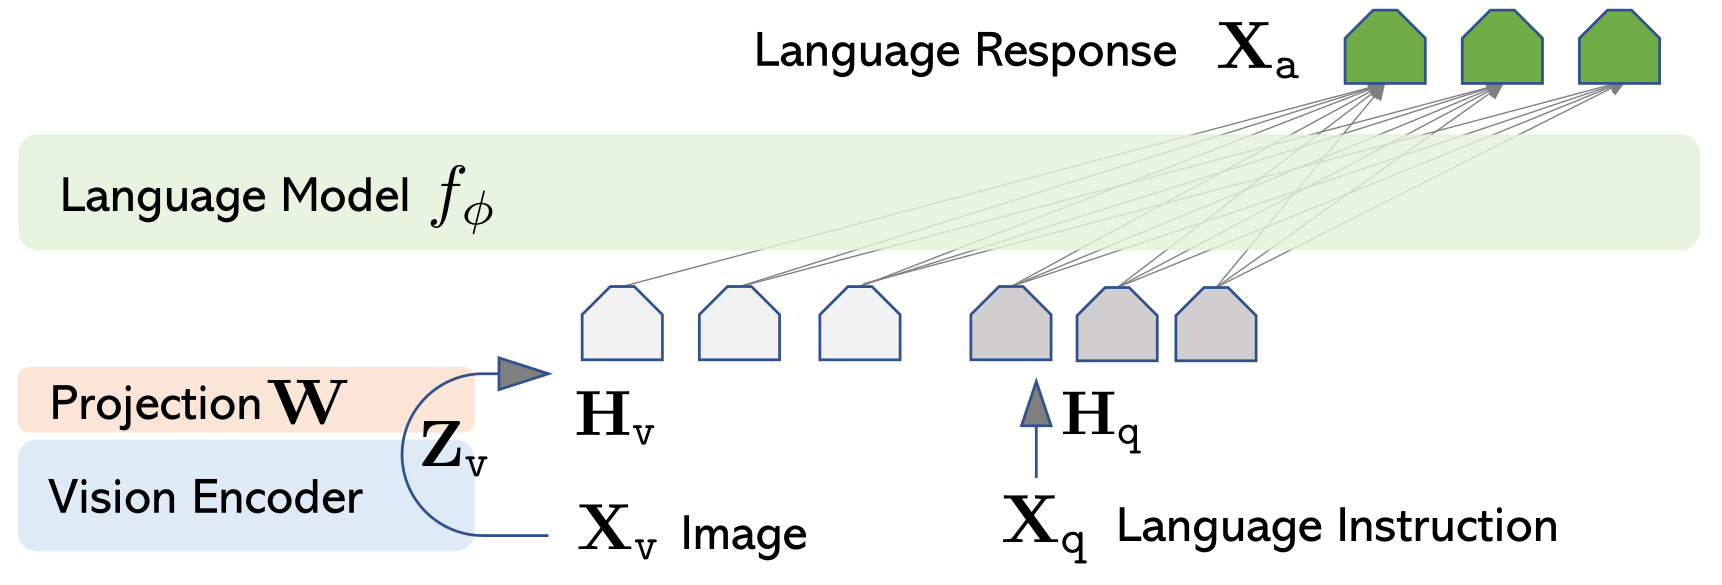
两阶段训练把“接口对齐”和“指令遵循”分开。第一阶段使用过滤后的 CC3M 595K 图文对,冻结 CLIP 视觉编码器和 Vicuna,只训练 \(W\),让图像特征先落入 LLM 可解释的 embedding 区域。第二阶段始终冻结视觉编码器,更新 projector 与 LLM,并使用 158K 视觉指令样本学习问答和多轮交互;自回归 loss 只计算 assistant 回答与停止 token。这里的 595K 与 158K 不是同一批数据;后者由 GPT-4 根据 COCO caption 和 bounding box 等符号描述生成,当时的文本 GPT-4 并没有直接读取原图。
这个模板的优势是模块化:更强的视觉编码器、更好的 projector 和更强的 LLM 可以分别替换。局限也同样清楚。若视觉编码阶段裁掉边缘、缩小文字或丢弃细节,projector 无法凭空恢复;若只在输入层注入一次,深层语言表示可能逐渐稀释视觉证据;若视觉 token 过多,语言模型的上下文与推理吞吐又会迅速承压。
AnyRes:用局部切片换细节,再用 token 预算收口
固定方形输入对自然图像并不友好。把长文档、网页截图或宽幅照片统一缩放、中心裁剪到 336×336,会丢失小字和边缘内容。LLaVA 系列的 AnyRes 同时保留一个全局缩略图,并按原始宽高比选择 \(a\times b\) 个高分辨率局部切片;每个切片独立经过视觉编码器,再按空间布局拼接。
若每个视图产生 \(T\) 个视觉 token,未经压缩时总长度近似为:
其中额外的 1 来自全局视图。以 3×4 网格为例,视觉序列达到 \(13T\);细节保住了,序列成本却线性放大。实际系统因此会限制可选网格,或对局部特征图做双线性插值,把过长网格压到预算内。插值发生在特征空间,减少的是进入 LLM 的 token 数,不等于原始细节完全无损。
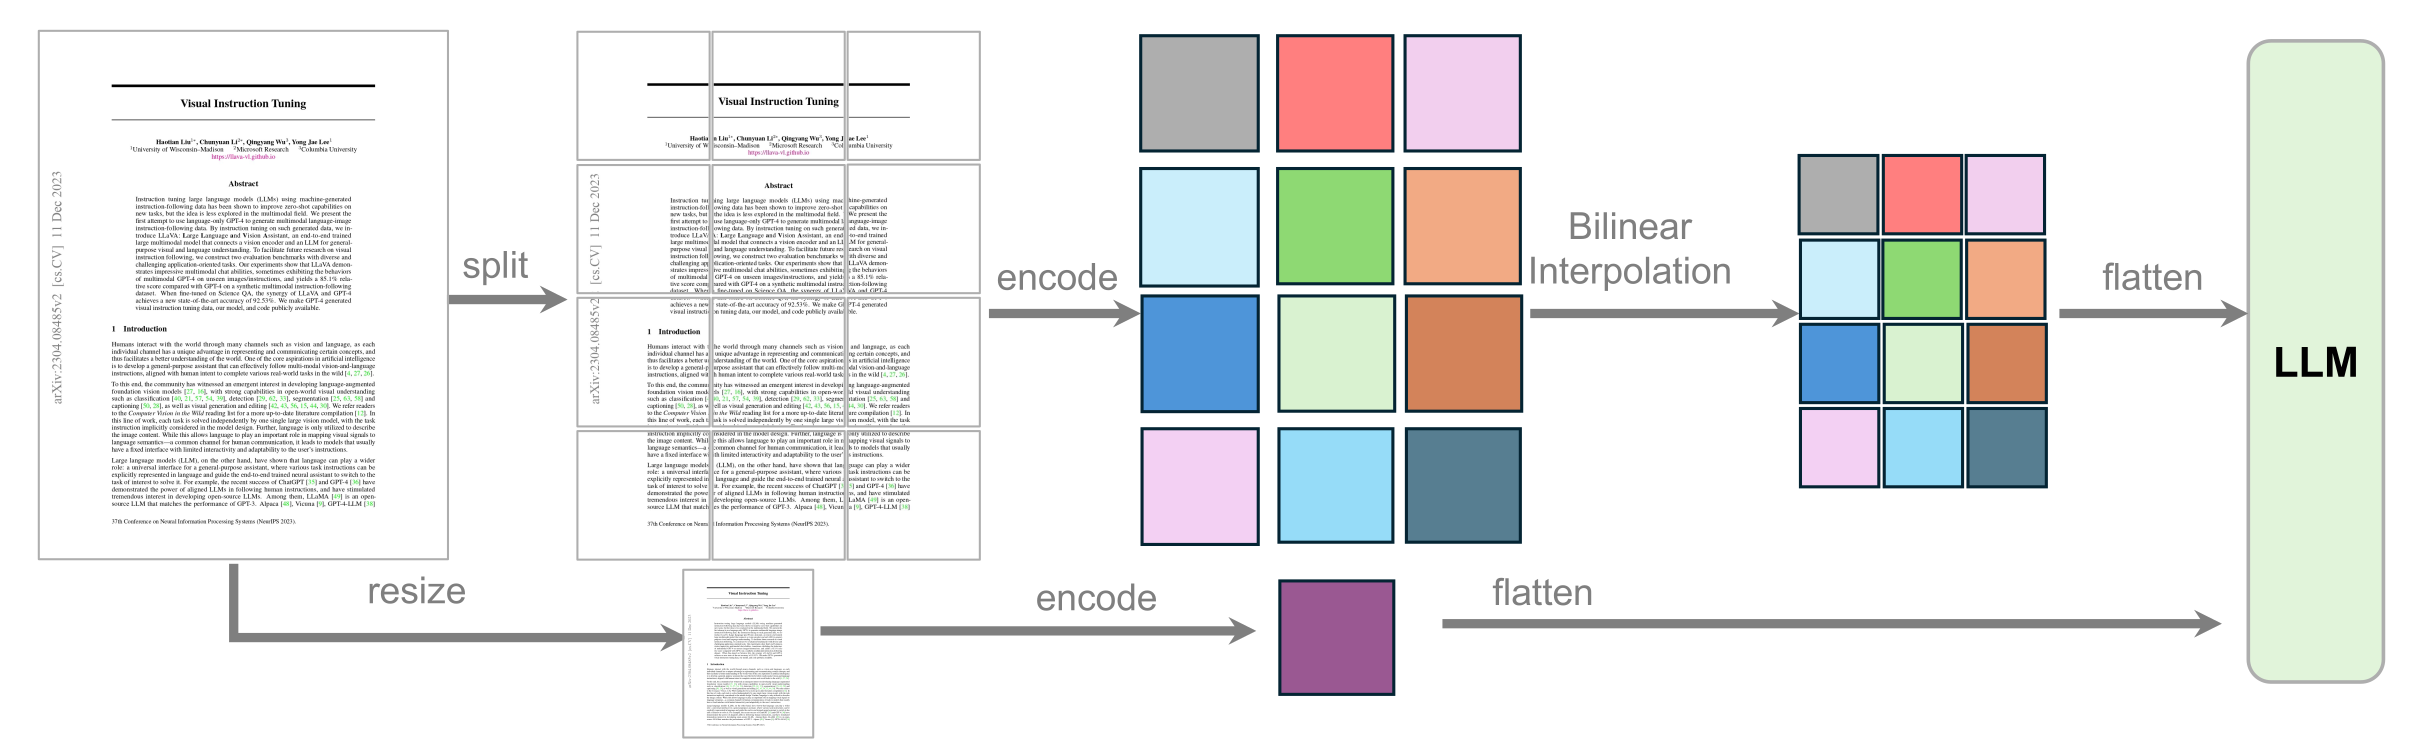
LLaVA-OneVision 还需要统一单图、多图和视频。单图可以用较高分辨率;多图对每张图采用较低基础分辨率;视频帧同样先缩放到基础图像分辨率并经过视觉编码器,再在特征空间用双线性插值减少每帧视觉 token,以便在相近的总 token 预算下容纳更多帧、扩大时间覆盖。论文配置的上限大致为单图 \(10\times729=7290\)、多图 \(12\times729=8748\)、视频 \(32\times196=6272\) 个视觉 token。目标不是让三种输入拥有相同像素数,而是把序列成本控制在同一量级;只要总 token 预算固定,空间分辨率、图像数量、帧率和视频时长就必然互相竞争。
从固定压缩到动态分辨率:Qwen-VL 的接口演进
Qwen-VL 使用带二维位置信息的 cross-attention adapter,将视觉特征序列压缩为固定 256 个 token,并用 <img>、<box>、<ref> 等特殊 token 表达图像、框与文本指代。其各训练阶段仍把图像统一 resize 到固定分辨率:第一阶段为 224×224,后两阶段为 448×448;adapter 分别将对应的 256 或 1,024 个 ViT 特征压缩到 256 个 token。固定输出长度让 LLM 成本可预测,但高分辨率输入的更多视觉特征必须共享同一组 256-token 容量。
Qwen2-VL 改用 native dynamic resolution:输入按自身尺寸切成 patch,视觉 token 数随图像面积变化,再用 2×2 merger 压缩。模型不再把小图强行放大到固定尺寸,也不必把大图一律缩小;代价是每个样本长度不同,batching、显存和延迟都更难预测。论文的训练配置以每秒 2 帧采样视频,并通过动态调整每帧分辨率把每个训练视频的视觉 token 上限控制在 16,384;这属于训练时的效率权衡,并非模型推理或部署时不可突破的硬限制,论文还测试了最高 80K token 的推理长度。
动态长度需要配套的数据课程。Qwen-VL 先在清洗后的 14 亿图文对上冻结 LLM、训练视觉编码器与 adapter,再把输入从 224×224 提高到 448×448 并进行全参数多任务训练,最后冻结视觉编码器、使用 350K 指令样本训练 LLM 与 adapter。Qwen2-VL 也采用由视觉对齐到全参数训练、再到指令跟随的阶段化方案。阶段划分的目的,是先让模态接口可用,再让语言模型承担复杂任务,避免随机视觉表示在一开始就扰乱成熟的文本分布。
MRoPE 与 DeepStack:不仅要有 token,还要保留结构
把二维图像展平成一维序列后,普通位置 \(0,1,2,\ldots\) 只告诉模型先后顺序,却没有显式区分“向右一格”和“换到下一行”。视频还多出时间轴。Qwen2-VL 的 Multimodal Rotary Position Embedding(MRoPE)为视觉 token 分配三元坐标:
图像只有一个时间索引,视频帧沿 \(t\) 变化,patch 在 \(h,w\) 上形成网格;文本 token 则让三个坐标同步递增。RoPE 的旋转维度被分成时间、高度、宽度三个子空间,于是注意力中的相对相位能表达时空距离。后续文本从视觉块三个坐标的最大位置之后继续编号,使文本和视觉仍处在一个连续上下文中。
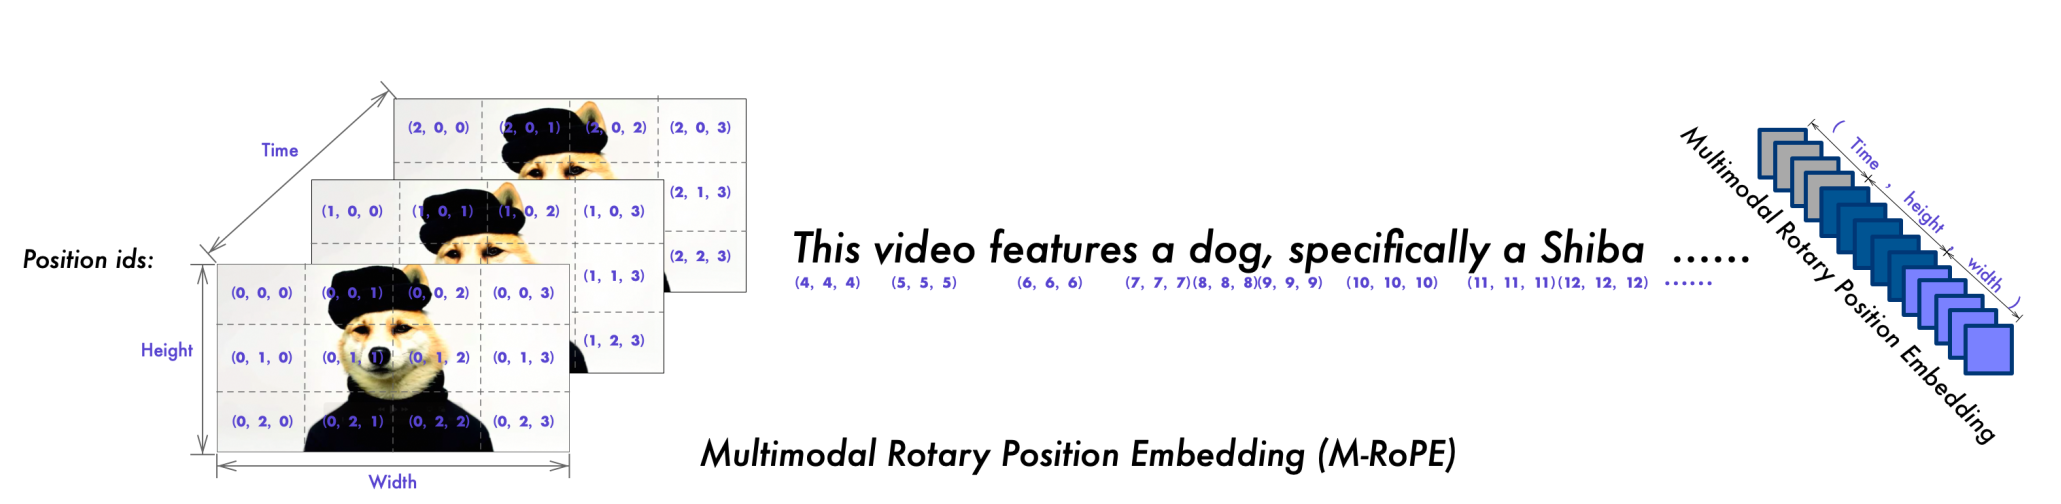
Qwen3-VL 发现,把低频维度整块分给某一轴、把高频维度整块分给另一轴,会造成三轴频谱不均。Interleaved MRoPE 将 \(t,h,w\) 维度交错分散到低频与高频带,而不是按连续区间切块;视频时间还以可读的文本时间戳显式插入,减少“位置索引就是绝对秒数”的隐式负担。
位置编码回答“token 在哪里”,DeepStack 则回答“视觉信息在哪一层进入”。早期 LLaVA 只把最终视觉特征投影到 LLM 输入端;Qwen3-VL 从 ViT 的三个中间层取出不同抽象级别的特征,经专用 merger 映射后,以残差方式注入 LLM 前三层对应 hidden states。低层纹理、边缘和文字不必全部先被压缩成最终语义特征,也不会增加主序列的 context length。
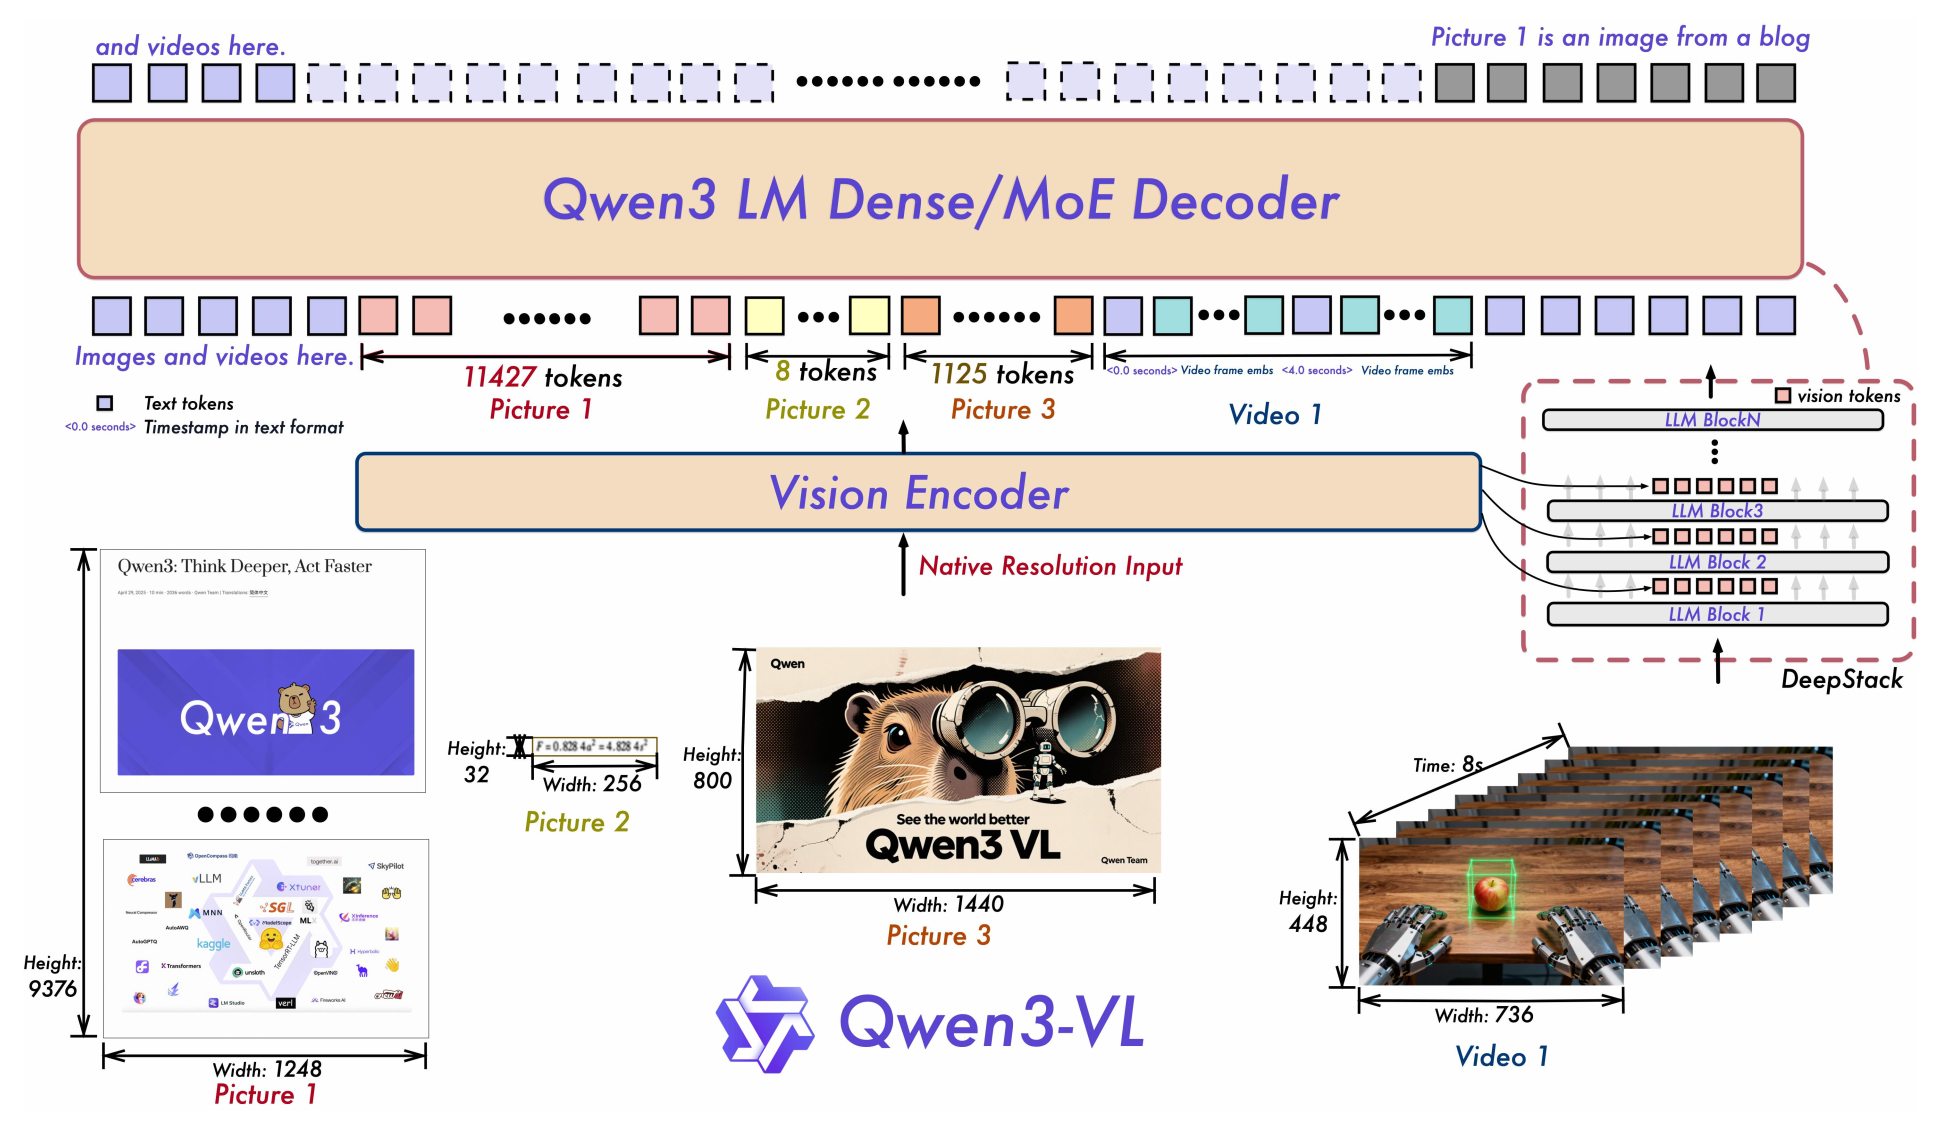
Qwen3-VL 的预训练由 merger-only 对齐开始,随后进行全参数 8K、32K 和 262,144 长度训练;技术报告给出的家族覆盖 2B、4B、8B、32B dense 模型以及 30B-A3B、235B-A22B MoE,并原生支持 256K 图文视频交错上下文。这些规模描述的是 2025 年 11 月版本技术报告中的模型家族与训练阶段,不代表每个请求都应使用最大分辨率或最大上下文。
多模态训练不是简单拼接:谁在主导梯度
视觉样本往往比文本样本长。一张高分辨率图片可能贡献数千视觉 token,一段视频可能贡献数万 token;但视觉 token 的监督含义、熵与文本 token 并不相同。若对 batch 内所有 token 直接求平均,长视频更容易主导梯度;若先对每个样本求平均,短文本与长视频表面等权,但每个视觉 token 的权重会被显著稀释。
因此,必须把数据采样比例、token 预算与 loss reduction 视为同一个设计问题。Qwen3-VL 报告从 per-sample loss 改为 square-root-normalized per-token loss,以平衡纯文本与多模态目标;报告没有公开足够明确的公式,不能自行把这一名称扩写成某个确定实现。可审计的训练日志至少应记录:每种模态的样本数与有效 token 数、分模态 loss、梯度范数、截断率、分辨率/帧率分布以及纯文本能力回归。
另一个常见误区是把“视觉 token 更多”理解成“监督信息更多”。重复视频帧、大片背景和相邻 patch 高度相关,序列很长但有效监督密度可能不高;文本 token 较少,却直接参与下一 token 预测。合理的课程学习通常从短、干净、容易对齐的数据开始,再逐步增加高分辨率、长视频和复杂指令,而不是一开始就把所有模态按原始长度混在一起。
Chameleon:把图像也变成可生成的离散词表
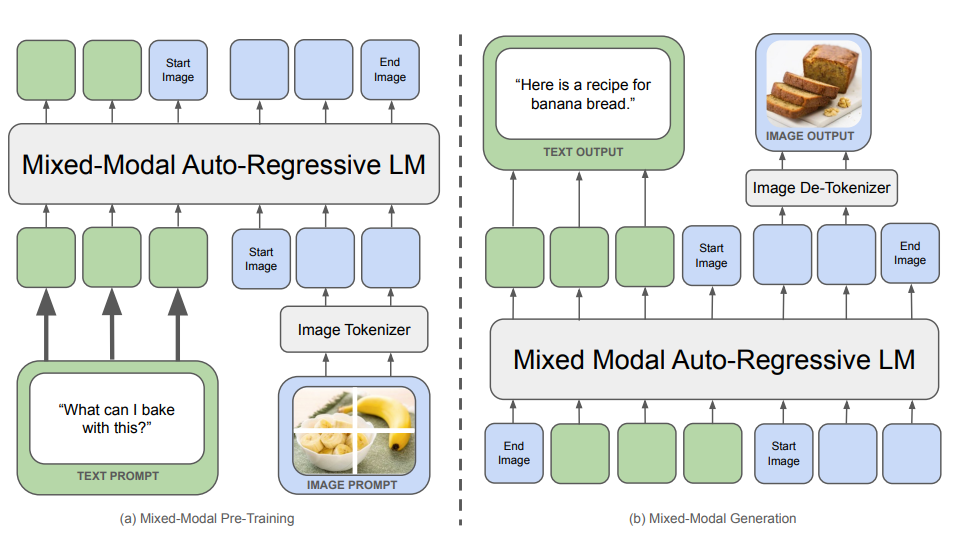
连续视觉特征擅长理解,但典型 encoder-projector-LLM 本身没有像素解码器。Chameleon 选择另一条路线:先把图像变成离散索引,与文本 token 混合成同一个序列,再训练统一的自回归 Transformer。模型既可以读取图像 token 后回答,也可以在文本之后生成图像 token,并由 image de-tokenizer 还原像素。
离散视觉 token 来自向量量化。编码器先产生连续潜变量 \(z_e(x)_{r,c}\),对每个空间位置,在码本 \(E=\{e_1,\ldots,e_K\}\) 中寻找最近向量:
索引 \(k^*_{r,c}\) 就是可预测的视觉 token;查回码本向量后,图像解码器重建像素。训练 tokenizer 时常用的最小化目标可以写成:
第二项更新 codebook,第三项约束 encoder 对选中码字的 commitment;\(\operatorname{sg}\) 表示 stop-gradient,离散选择则用 straight-through estimator 把 decoder 输入梯度传回 encoder。VQ-VAE 论文实验采用 \(\beta=0.25\)。
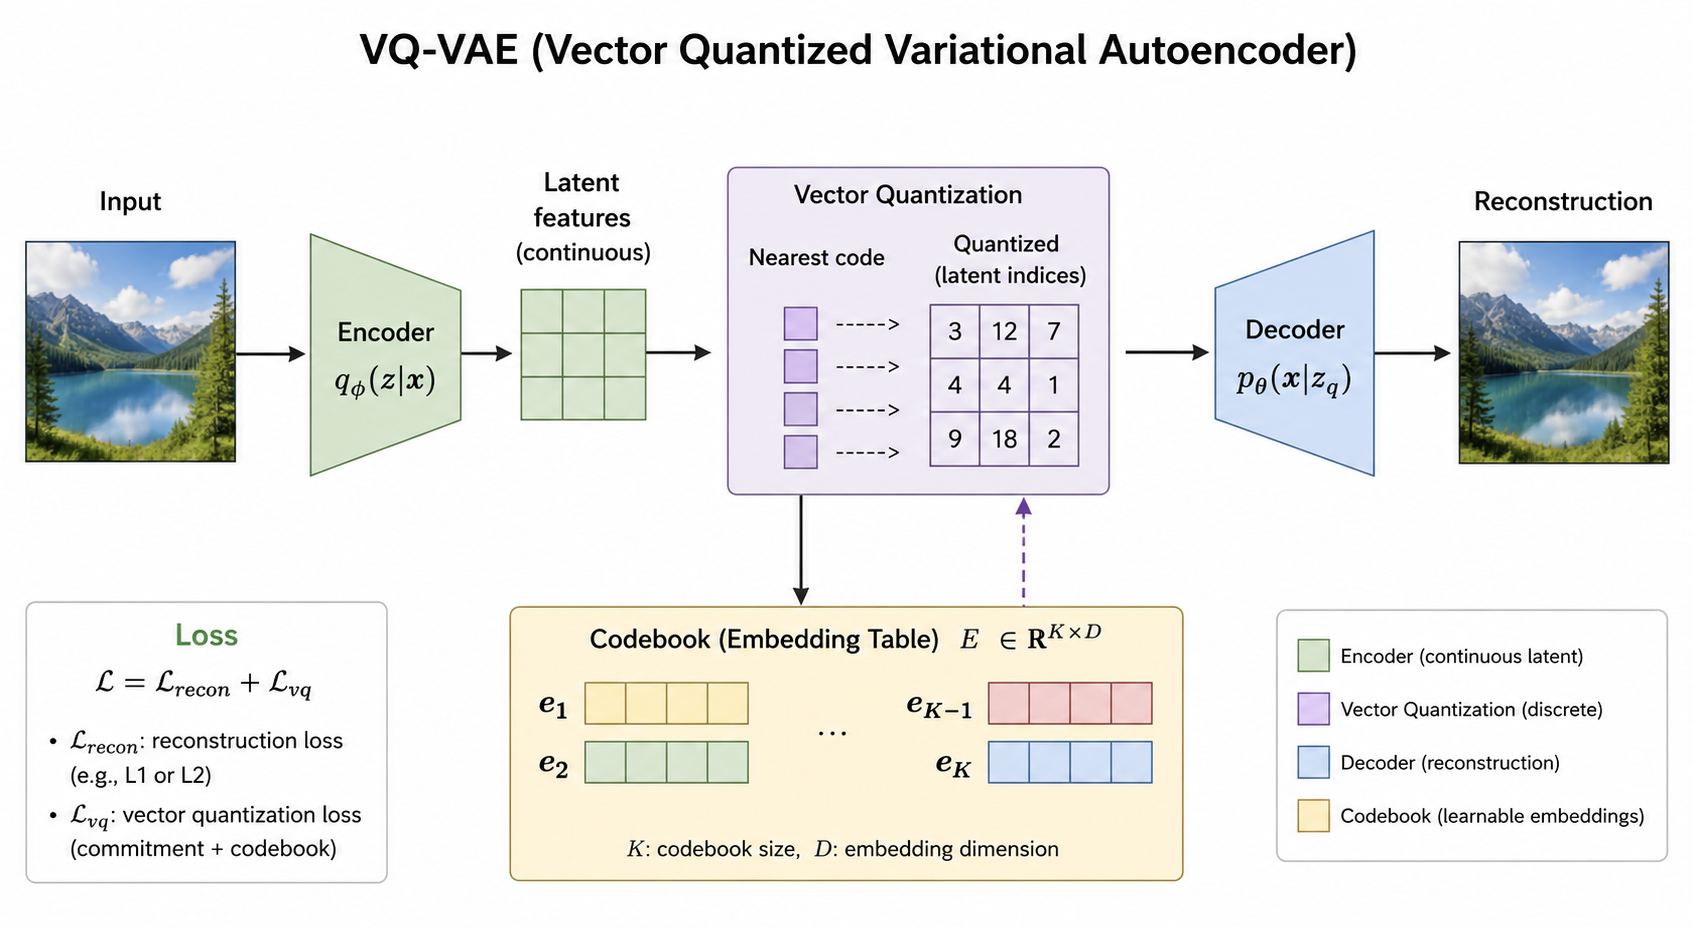
Chameleon 将 512×512 图像编码成 1,024 个视觉 token,图像码本大小为 8,192;其 65,536 大小的统一 BPE 词表包含这些视觉码。混合序列的概率仍是标准自回归分解:
优雅之处在于,理解和生成终于共享同一种输出接口;代价是图像 tokenizer 决定了能力上限。论文明确指出,其 tokenizer 对含大量文字的图像重建较弱,因此 OCR 能力在进入 Transformer 之前就已受限。离散化并非必然劣于连续表示,但码本大小、下采样率和重建目标会决定哪些视觉细节被永久丢弃。
统一自回归训练为何更容易不稳定
文本和图像 token 的统计分布差异很大。自然语言有强语法约束,下一 token 的候选通常集中;视觉码本在纹理和局部细节上具有更高熵。两种 token 共享同一输出 softmax 后,梯度尺度、hidden-state norm 与 logit 分布会互相竞争。Chameleon 的实验观察到,输出范数失控增长与后续 loss 发散高度相关。
QK-Norm 在注意力 softmax 前归一化 query 与 key,用来控制注意力 logits 的尺度;但它管不到最终词表 softmax。Chameleon 因此还加入 z-loss,对 partition function 施加正则:
其中 \(\ell_k\) 是词表 logit。7B 的论文主配置使用 0.1 dropout,34B 需要调整 Transformer block 中 normalization 的顺序且不使用 dropout;两种规模都需要 QK-Norm 和 z-loss。这些差异说明,“统一成 token”只统一了接口,没有自动统一数值尺度。
数据配方同样需要精确阅读。Chameleon 第一阶段占训练进度前 80%,论文列出的数据池包括 2.9T 纯文本 token、由 14 亿图文对形成的 1.5T 图文 token,以及 400B 图文交错 token。后 20% 将第一阶段数据的采样权重降低 50%,再混入更高质量数据,并维持相近的图像—文本 token 比例。需要注意的是,上述三个数据池的名义规模合计为 4.8T,而论文 Table 1 将模型训练数据的 Tokens 列记为 4.4T,正文未解释两者的统计差异;论文另明确报告两个模型均训练 2.1 个 epoch、累计见到 9.2T token。因此不应把数据池名义规模、表中 Tokens 数和训练期间累计 seen tokens 当作同一口径。
如何选择架构
选型不应从模型名字开始,而应从任务需要保留的信息开始。只做粗粒度图片问答或检索,可以优先使用强对比学习视觉塔和较激进的 token 压缩;文档 OCR、GUI、图表和细粒度定位,需要高分辨率、二维位置与低层视觉特征;长视频还必须在帧率、每帧分辨率和时间覆盖间做预算;若要原生生成图像,则需要离散视觉词表或独立生成解码器。
设计问题 |
必须量化的指标 |
常见失效方式 |
|---|---|---|
视觉 tokenizer 保留什么 |
OCR、定位、重建误差、跨分辨率表现 |
语义正确但小字、边界和数量丢失 |
视觉 token 有多少 |
分辨率到 token 的公式、长度分位数、KV cache |
训练可跑,线上长尾延迟和显存失控 |
结构怎样编码 |
二维/三维位置、时间戳、切片顺序 |
能识别物体,却不能稳定回答方位与时序 |
模态在哪里融合 |
输入层、cross-attention、跨层注入的消融 |
视觉证据在深层被稀释,或 projector 成为瓶颈 |
loss 怎样归一化 |
分模态 loss、token 数、梯度范数、文本回归 |
长视觉样本压过文本,或视觉梯度被过度稀释 |
输出怎样解码 |
生成质量、重建上限、吞吐与安全约束 |
把理解编码器误当成可逆生成器 |
一条可靠的实验链路应固定数据切分与 token 预算,分别报告纯文本、单图、多图、文档、视频和生成任务;再对视觉塔、projector/merger、位置编码、分辨率策略、融合层与 loss reduction 做消融。平均榜单分数不能替代成本曲线:至少还要画准确率随视觉 token 数、上下文长度和端到端延迟的变化,才能看出模型是在更聪明地使用视觉信息,还是仅仅消费了更多 token。
多模态模型的发展,可以概括为四次接口升级:CLIP/SigLIP 先把视觉投到语言语义空间;LLaVA 用 projector 把连续视觉特征接入自回归 LLM;AnyRes、MRoPE 与 DeepStack 补上分辨率、时空结构和跨层融合;Chameleon 再把图像变成可生成的离散词表。真正的 omni model 不只是“支持更多文件格式”,而是让每种模态都拥有可控的信息保真度、可解释的 token 成本和稳定的训练权重。