训练数据预处理
前面的章节讨论了模型结构、训练系统与算力扩展;但当这些方法逐渐公开并被复现,真正难以观察、也最难复制的部分往往变成了数据。开放权重模型通常会披露网络结构、优化器和训练流程,却很少给出足以重建训练集的文档清单、抓取时间、过滤器版本与混合比例。以 Llama 3 为例,架构与训练方法高度透明,数据细节却仍然有限。原因既包括竞争压力,也包括版权与隐私责任。
“减少人工标注”也不等于“减少数据工作”。基础模型主要从海量非结构化内容中学习,工程投入从逐条标注转向采集、解析、语言识别、质量判断、去重、敏感信息处理与数据混合。架构代码可以复用,数据中的异常却呈长尾分布:模板页、镜像站、乱码、广告、被截断的代码、错误许可、泄露的个人信息,都需要持续识别和修正。
训练阶段还决定了数据目标的变化。预训练通常使用规模较大的原始文本;mid-training 用更集中、更高质量的数据强化知识或能力;post-training 再使用指令、对话或强化学习信号塑造行为。阶段边界并不绝对,但整体趋势很清楚:数据量逐步减少,单位样本的质量和目的性逐步提高。OLMo 2 与 Tülu 3 提供了这一分阶段路径的开放案例。
从在线服务到静态快照
网页首先是运行在服务器上的在线服务,而训练需要可重复读取的静态输入。Crawler 从一批 seed URL 出发,把待访问地址放入队列;每下载一个页面,就提取其中的链接并继续扩展队列。实际系统还必须决定三类策略:selection policy 决定抓什么,politeness policy 控制访问频率并尊重站点规则,re-visit policy 决定多久重新检查变化的页面。
Common Crawl 把这套过程做成了周期性公共快照。 2026 年 4 月快照包含 21.9 亿页面、约 372.2 TB;这已经非常庞大,却仍不能代表“整个 Web”。动态应用需要点击或提交表单,Facebook、LinkedIn、新闻付费墙等内容需要身份或订阅,Cloudflare、CAPTCHA、IP 限制和速率限制也会阻止自动访问。抓取到什么,从一开始就是访问条件与采样策略共同决定的结果。
快照本身也不是训练文本。Common Crawl 的 WARC 保存原始 HTTP 响应,例如 HTML;WET 则是已经抽取出的文本,使用方便但有损。导航栏、正文、表格、代码块、评论与页脚怎样被识别,会直接改变训练分布。DataComp-LM 的实验进一步说明,HTML-to-text 工具的选择会影响最终模型的下游准确率。因此,正文抽取不是无关紧要的文件格式转换,而是数据选择的第一道模型化决策。
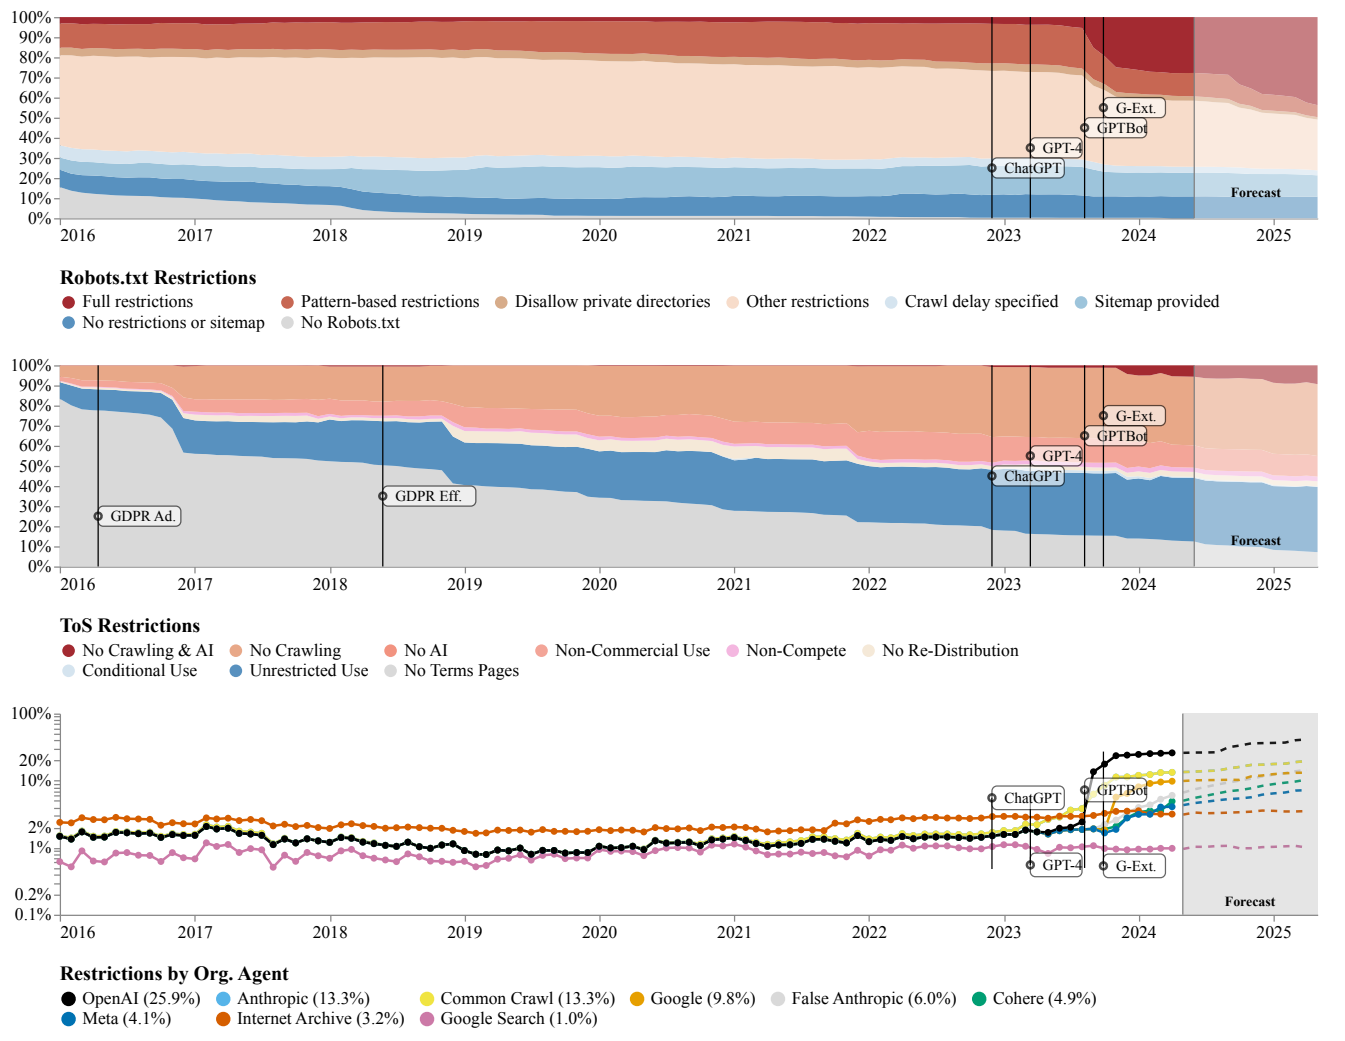
Consent in Crisis 检查了 C4、RefinedWeb 与 Dolma 等语料涉及的 URL,观察到通过 robots.txt 与服务条款表达的限制随时间增加。这意味着历史上抓取得到的数据,并不能自动推出今天仍可按同样方式重新取得;数据快照必须同时记录时间、来源和当时适用的访问条件。
技术上能够下载一份内容,不代表已经获得复制和训练它的权利。
一条更容易审计的路线,是优先使用公有领域和开放许可材料。Common Pile 汇集约 8 TB 此类文本,用来检验能否仅依赖许可较明确的数据训练有竞争力的模型。
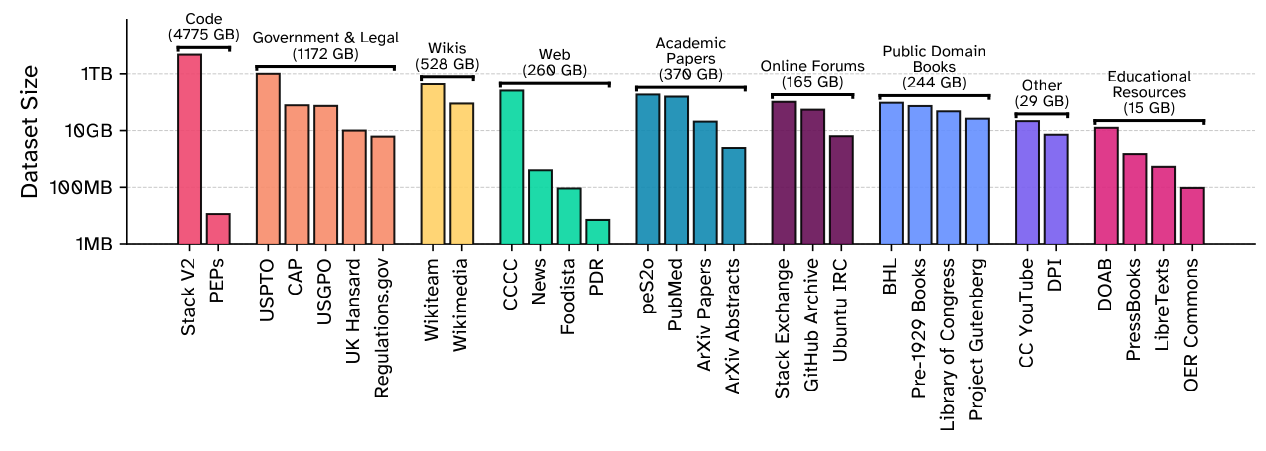
常用数据源地图:不同来源携带不同结构与风险
通用网页只是训练数据的一部分。不同来源提供的信号、获取方式和风险并不相同,不能用一套过滤器无差别处理。
来源 |
主要价值 |
获取与结构 |
主要风险 |
|---|---|---|---|
规模巨大、覆盖长尾网页 |
周期性 WARC/WET 快照,需要正文抽取 |
噪声、模板页、重复、授权不一、时间漂移 |
|
百科知识、语言和主题覆盖较清晰 |
定期 dump,无需逐页抓取 |
编辑偏差、破坏性修改、dump 前短时数据投毒 |
|
源码、提交历史、issue、PR 与开发讨论 |
Git 仓库、API 事件流、归档快照 |
fork 与复制、恶意代码、PII、许可证缺失或不兼容 |
|
论文、公式、专业知识及部分 LaTeX 源码 |
元数据与批量下载;许可由作者选择 |
并非所有全文都采用开放许可,也不等同于同行评审 |
|
书籍与问答社区 |
长篇连贯文本、问题—答案与偏好信号 |
Project Gutenberg、Stack Exchange dump、商业或历史抓取集 |
影子图书馆、ToS、版权期限与用户内容许可 |
即使是通常被视为高质量的来源,也不能跳过验证。Wikipedia 可能在定期 dump 前遭到短时恶意编辑;GitHub 的 public repository 不等于 permissively licensed repository;arXiv 的标题和摘要采用较开放的元数据许可,也不代表每篇论文全文都采用同一许可。来源名称只能提供初始先验,不能代替逐来源的规则和 provenance。
从数据集演进看预处理方法
过去数年的代表性数据集,可以看作一系列不断变化的数据选择实验。WebText 用 Reddit 外链帖子至少 3 个 karma 作为质量代理;CCNet 组合段落去重、fastText 语言识别和 Wikipedia 风格的 KenLM 5-gram 评分;C4 则大量依赖标点、句长、坏词、模板词和语言概率等人工规则。规则容易扩展,却会把设计者对“好文本”的判断直接写入数据分布。
The Pile 转向 22 个领域的人工策划混合;GPT-3、LLaMA 和 Dolma 则把网页、书籍、代码、论文和问答按来源分别处理。随后,RefinedWeb 与 FineWeb 把 HTML 抽取、语言识别、启发式过滤、MinHash 近重复消除和 PII 处理组合成大规模网页流水线。
最新一轮变化是从固定规则走向可学习的数据选择。DataComp-LM 从 240T-token pool 出发,用正负样本训练 fastText 质量分类器,得到约 3.8T tokens 的 baseline;Nemotron-CC 则指出激进质量过滤可能删除约 90% 的数据,并使用分类器集成、教师模型评分蒸馏与合成改写,在质量和长训练周期所需 token 规模之间重新折中。
这些数据集名称背后反复出现的是同一组基础操作:把网页可靠地抽取成文本,识别目标语言,用规则做廉价粗过滤,用分类器估计质量,检测有害内容,处理个人信息,再删除精确或近似重复项。真正的演进不是“数据集越来越大”,而是团队越来越明确地把来源、转换、质量信号和风险边界编码进流水线。
训练器最终消费的是 token 序列,而不是网页 DOM、PDF 页面或 Git 仓库。HTML 转文本要去掉导航、广告和模板,同时保留正文、代码块、表格语义与段落边界;PDF 没有天然的阅读顺序,双栏、公式、图注和扫描页需要由几何位置、OCR 或视觉模型重建;代码仓库则不能简单拼接文件,还需要保留目录、语言、依赖、提交或 PR 的结构。
因此,转换天然有损。把页面线性化后,某段话与哪幅图对应、表头属于哪一列、代码来自哪个文件,都可能消失。更稳健的管线应同时保存原始对象、解析器与版本、抽取结果、内容哈希和失败原因,让后续发现解析缺陷时能够重跑,而不是永久丢失源信息。
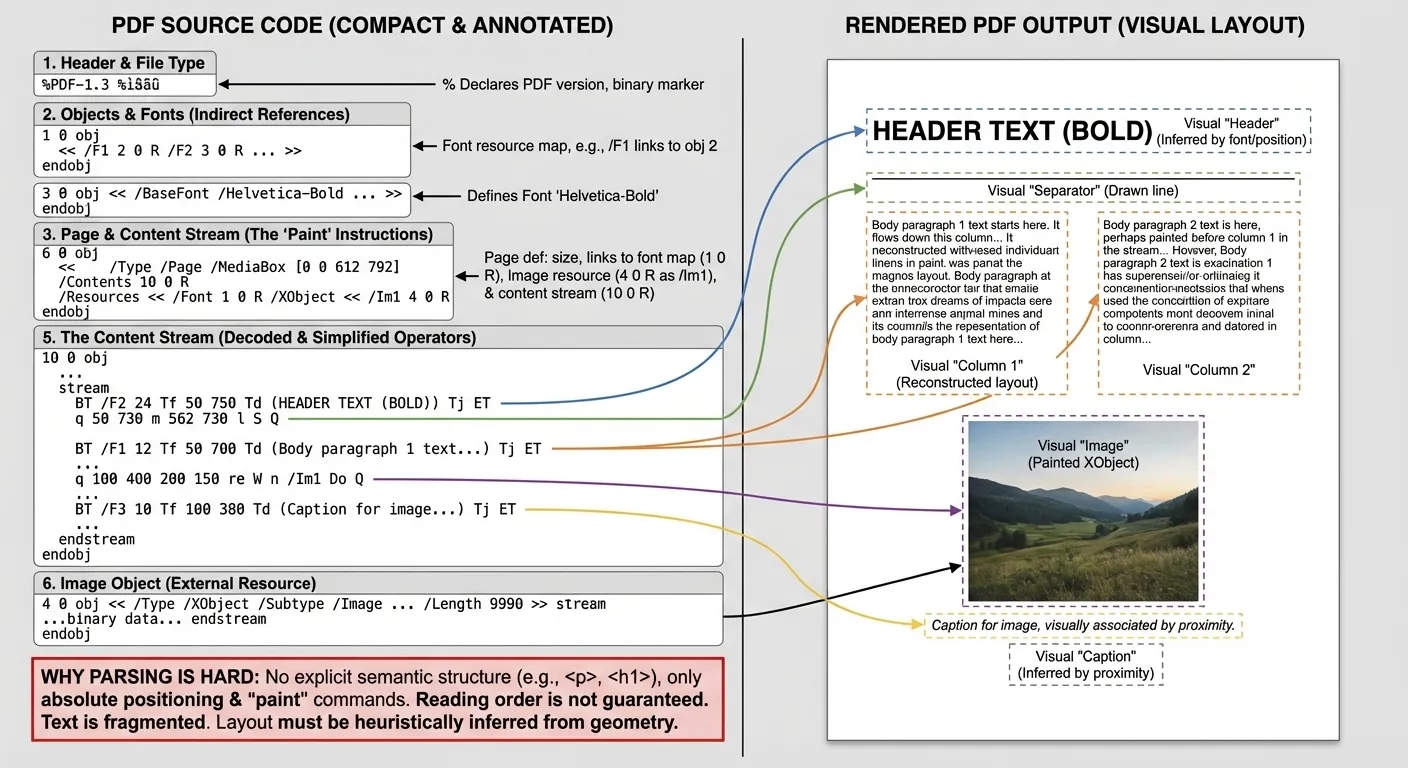
FinePDFs 展示了 PDF 场景的典型难点:Common Crawl 中的大文件可能被截断,需要重新抓取;文本既可由 Docling 等解析器恢复,也可由 RolmOCR 一类视觉模型识别;之后仍要清洗与过滤。下方现有的网页正文抽取代码,是同一“原始对象 → 规范化文本”问题在 HTML 上的最小实现。
过滤:把“什么是好数据”变成可扩展的选择器
语言识别、质量分类和有害内容检测看似是不同任务,其实可以统一成同一个选择问题:给定少量目标数据 \(T\) 和大规模原始数据 \(R\),定义评分函数,并从 \(R\) 中选出更接近目标的子集 \(T'\)。
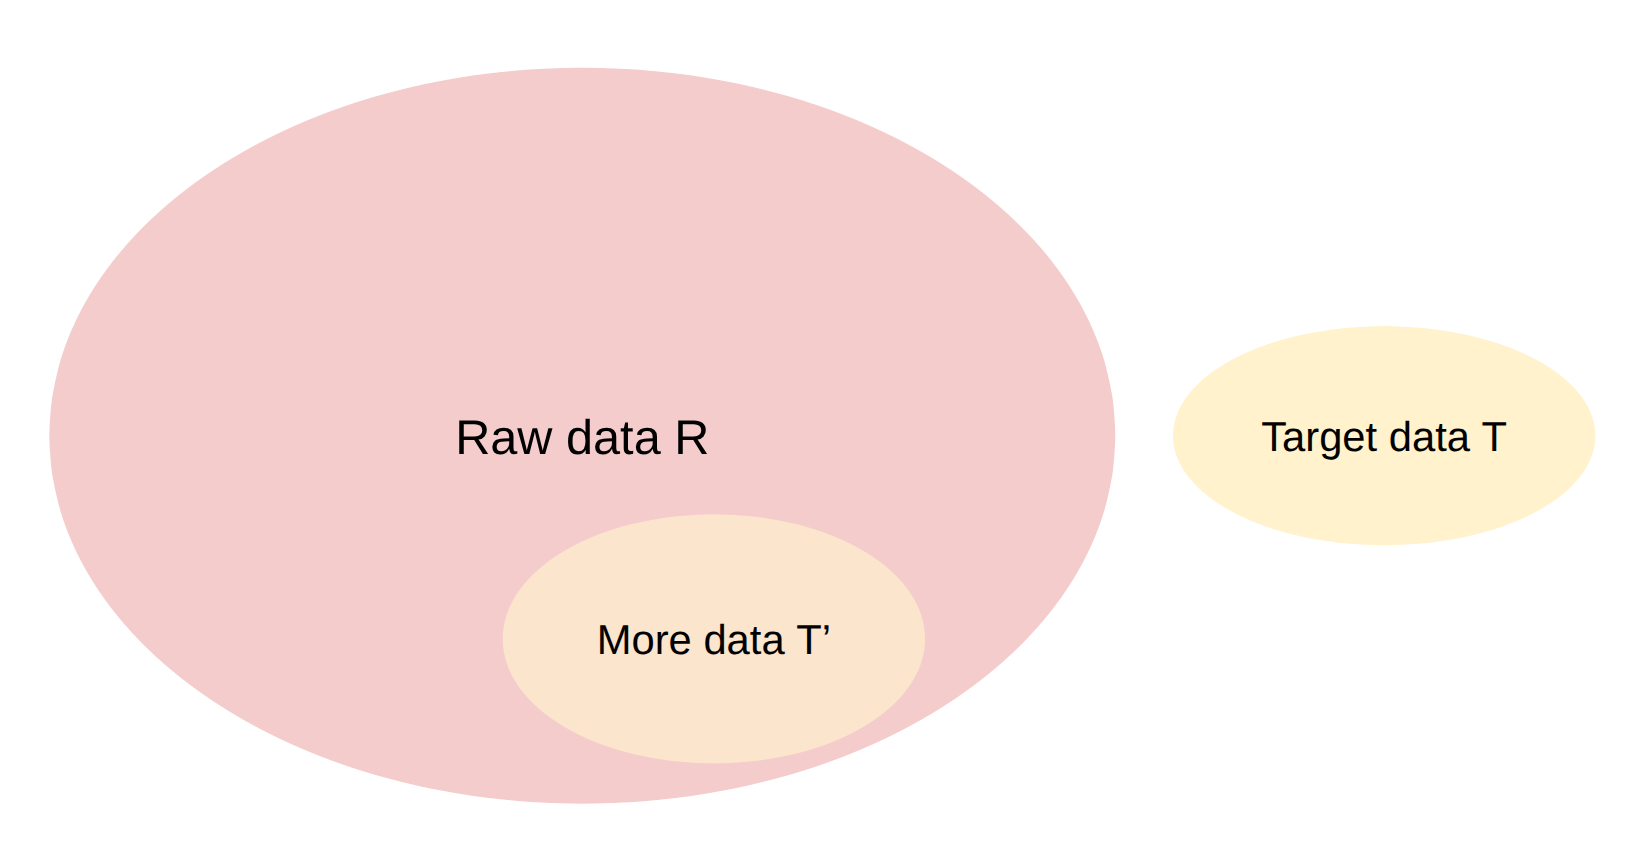
生成式方法学习目标分布本身,例如用 KenLM 给文本打分:
判别式方法则直接估计样本是否像目标数据,例如 fastText 分类器:
规则过滤速度快、含义直观,适合先去掉乱码、过短页面、模板词和明显格式异常;模型过滤能组合更多特征,却会把目标样本的覆盖范围和偏见外推到全量语料。两者通常是串联关系,而不是二选一:先用便宜规则缩小数据,再用可校准的模型分数决定保留概率或阈值。
阈值也不能脱离训练预算讨论。严格过滤会提高平均质量,却缩小可用 token 池;短训练可能因此受益,长训练却会更早耗尽数据并反复 epoch。最优阈值随模型、目标能力、token budget 和允许重复次数变化。
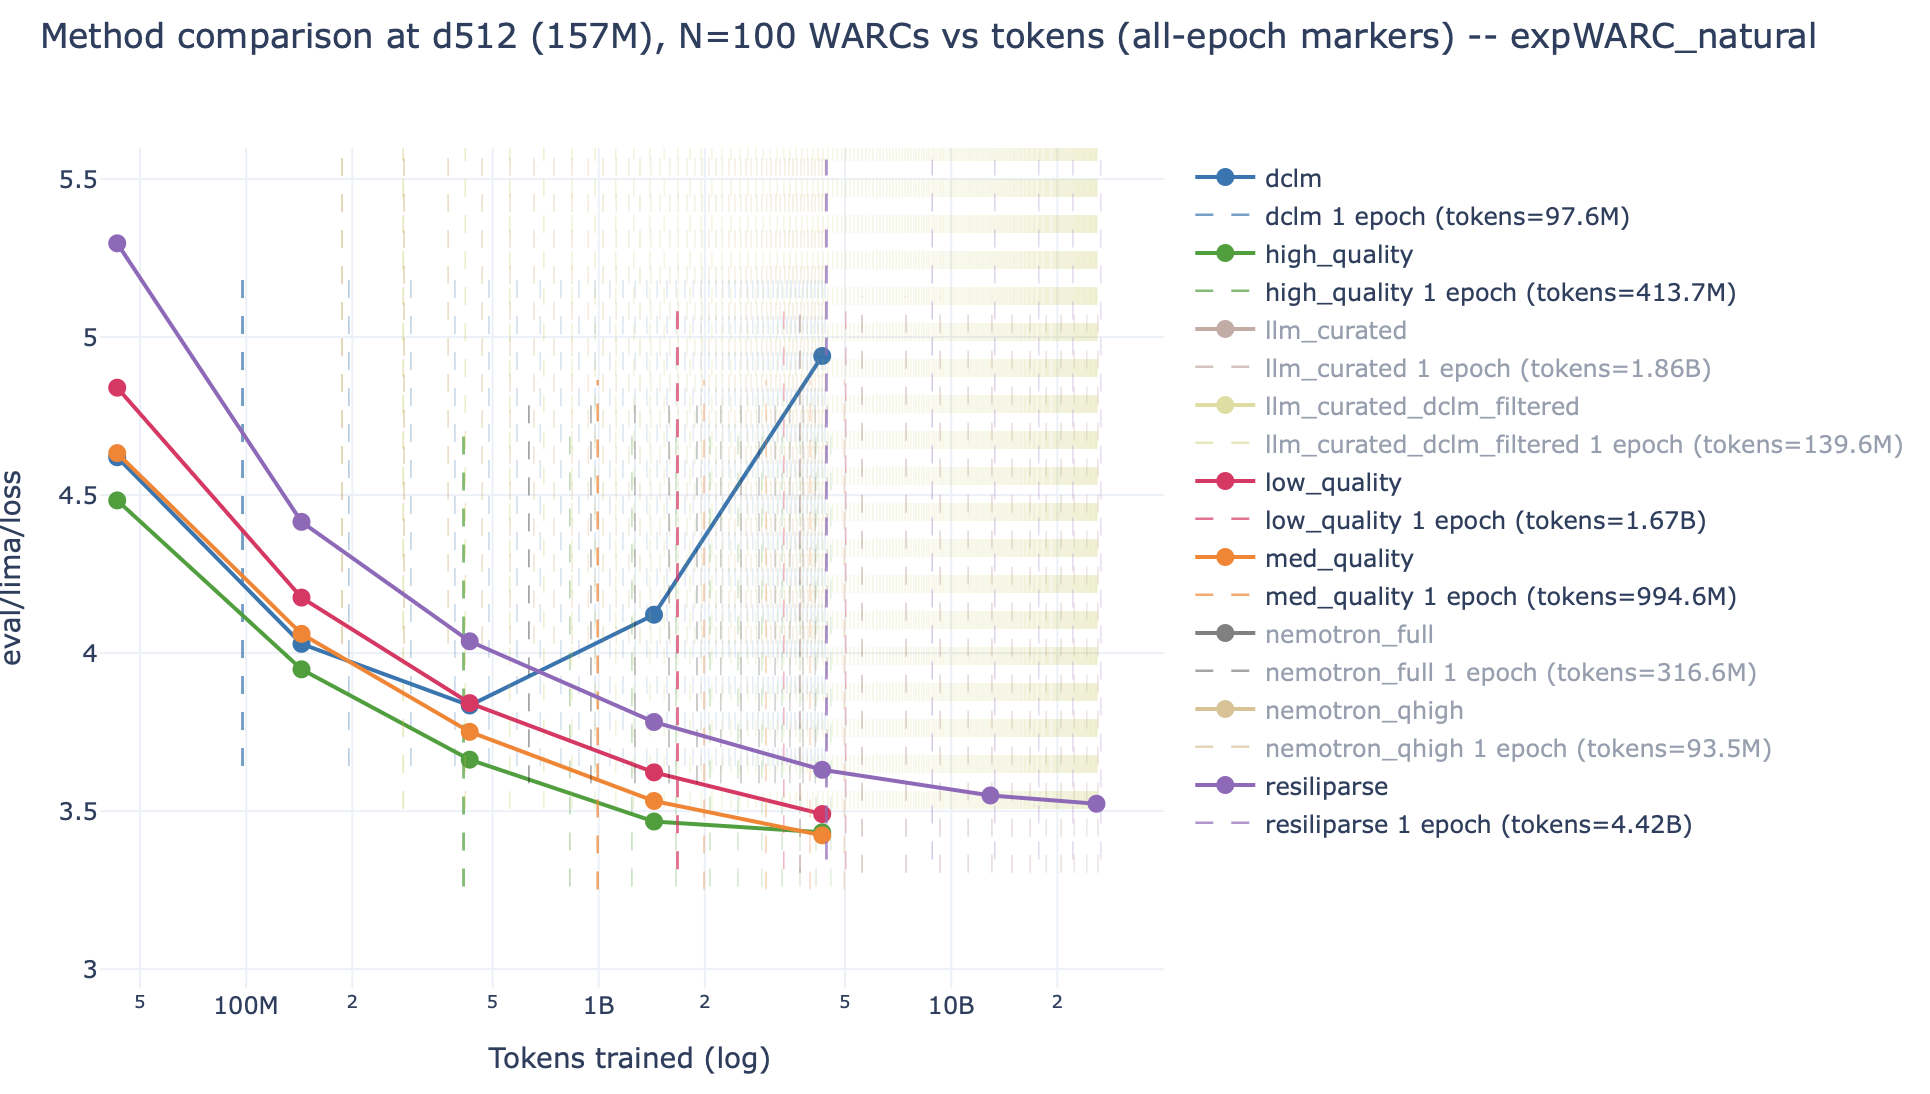
接下来的语言识别、粗规则、质量分类、有害内容检测与 PII 遮蔽代码,正是这一统一框架的不同实例。它们应共同回答三个问题:目标分布如何定义,错误保留与错误删除怎样权衡,以及阈值在训练规模变化后是否仍然成立。
海量数据去重
精确去重并不难:为每个句子、段落或文档计算哈希,把哈希相同的对象分到同一组,每组只保留一个即可。问题在于,网页中的重复往往不完全相同。模板页会替换标题和日期,转载会改变标点与空白,代码仓库的 fork 也可能只修改少数文件。此时,仅比较完整字符串会漏掉大量语义上近似、结构上高度重合的样本。
一种常见做法是先把文档表示成 token shingle 的集合。对集合 \(A\) 与 \(B\),Jaccard 相似度定义为:
例如 \(A=\{1,2,3,4\}\)、\(B=\{1,2,3,5\}\),交集有 3 个元素,并集有 5 个元素,因此 \(J(A,B)=3/5=0.6\)。直接为所有文档对计算这个值仍然需要近似平方级比较,数据规模上升后不可接受。MinHash 的作用,是把集合相似度变成可采样的碰撞概率:
直观地看,随机打乱全集中的元素,再分别观察 \(A\) 和 \(B\) 中最先出现的元素。只有当这个元素来自交集时,两边的 MinHash 才相等;最先出现的元素在并集内近似均匀,因此相等概率正好对应交集占并集的比例。重复使用多组随机哈希,就能用碰撞频率估计 Jaccard 相似度。
但单个 MinHash 只能告诉我们“相似对象更容易碰撞”,还不能形成清晰的候选阈值。Locality-Sensitive Hashing(LSH)进一步使用 \(n=br\) 个 MinHash,把签名切成 \(b\) 个 band,每个 band 含 \(r\) 个哈希值。两个文档只要在任意一个 band 内的全部 \(r\) 个值都相同,就进入候选集合。若两者 Jaccard 相似度为 \(s\),则固定 band 完全匹配的概率为 \(s^r\),至少一个 band 匹配的概率为:
这条曲线呈 S 形。在固定另一参数时,增大 \(r\) 会让匹配更严格并把曲线向右推;增大 \(b\) 会增加命中机会并把曲线向左推。常用的经验拐点写成:
这里的 \(t\) 只是便于配置的近似阈值,不是某条不可逾越的精确边界。以 \(b=20\)、\(r=450\) 为例,\(t\approx0.99336\);在该点,一个 band 匹配的概率为 \(1/20\),总体候选概率为 \(1-(1-1/20)^{20}\approx0.6415\),接近 \(1-1/e\)。
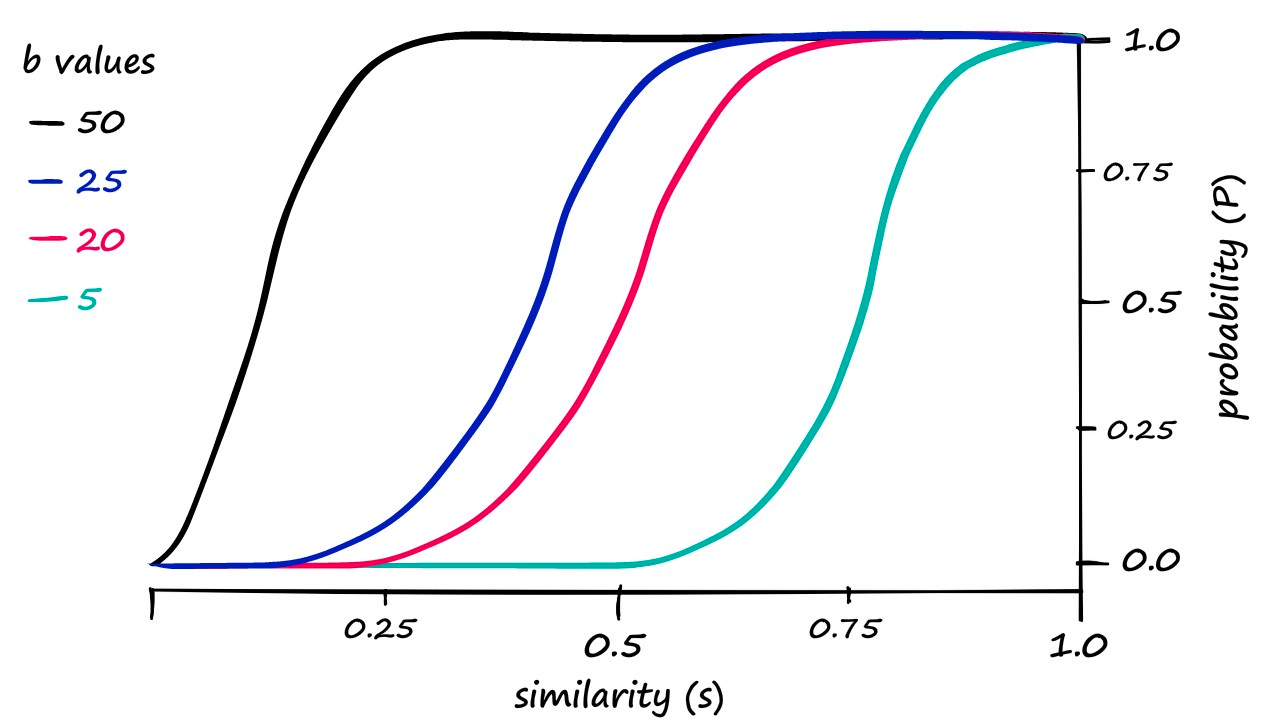
LSH 的输出应被理解为“值得进一步核验的候选对”,而不是最终删除决定。生产管线通常还要计算精确 Jaccard 或更细粒度的相似度,并决定重复簇中保留哪一份。来源可信度、正文完整度、许可证、时间戳和格式质量都可能比“任意保留一个”更重要。使用 MurmurHash 这类快速但不抗碰撞的哈希时,也应在同一哈希桶内再次核对内容,避免把真正不同的样本误删。
这类哈希管线消除了对全部文档对执行 \(O(N^2)\) 精确比较的需求,但不能笼统地宣称整个生产流程严格为 \(O(N)\):签名排序、候选复核以及由模板页造成的热点 bucket 仍可能成为主要成本。删除粒度同样重要——从文档中间移除重复片段,可能留下语义断裂的上下文。
import os
import hashlib
import unicodedata
from unidecode import unidecode
import nltk
from nltk.tokenize import word_tokenize
import re


def exact_line_deduplicate(files: list[os.PathLike], output_dir: os.PathLike):
    line_cnt = {}
    for file in files:
        with open(file) as f:
            for line in f.readlines():
                line_hash = hash(line)
                if line_hash in line_cnt:
                    line_cnt[line_hash] += 1
                else:
                    line_cnt[line_hash] = 1

    for file in files:
        with open(file) as f:
            with open(os.path.join(output_dir, os.path.basename(file)), "a") as f_out:
                for line in f.readlines():
                    line_hash = hash(line)
                    if line_cnt[line_hash] == 1:
                        f_out.write(line)


class Hasher:
    def __init__(self, seed: int):
        self.seed = seed

    def hash(self, content: str) -> int:
        hasher = hashlib.sha256()
        hasher.update(str(self.seed).encode("utf-8"))
        hasher.update(content.encode("utf-8"))
        return int.from_bytes(hasher.digest(), "big", signed=False)


class MinHashDeduplicator:
    def __init__(self, num_hashes: int, num_bands: int, n_gram: int, jaccard_threshold: float = 0.8):
        self.num_hashes = num_hashes
        self.num_bands = num_bands
        assert num_hashes % num_bands == 0
        self.n_gram = n_gram
        self.hasher = [Hasher(i) for i in range(num_hashes)]
        self.jaccard_threshold = jaccard_threshold

    @staticmethod
    def normalize(text: str) -> str:
        # 1. Apply Unicode NFD normalization
        text = unicodedata.normalize("NFD", text)

        # 2. Remove accents/diacritics (convert to closest ASCII)
        text = unidecode(text)

        # 3. Lowercase
        text = text.lower()

        # 4. Remove punctuation, leave:a-z, 0-9, space
        text = re.sub(r"[^a-z0-9\s]", " ", text)

        # 5. Normalize whitespace: 多个空白符 → 单空格,strip首尾
        text = re.sub(r"\s+", " ", text).strip()

        return text

    @staticmethod
    def _tokenize(text: str) -> list[str]:
        nltk.download("punkt")
        nltk.download("punkt_tab")
        tokens = word_tokenize(text)
        return tokens

    @staticmethod
    def shingle(text: str, n_gram: int) -> set[str]:
        tokens = MinHashDeduplicator._tokenize(text)
        shingles = set()
        for i in range(len(tokens) - n_gram + 1):
            shingles.add(" ".join(tokens[i : i + n_gram]))
        return shingles

    def signatures(self, shingle: set[str]) -> list[int]:
        signature = []
        for hasher in self.hasher:
            min_hash = min([hasher.hash(shingle) for shingle in shingle])
            signature.append(min_hash)
        return signature

    def jaccard_similarity(self, f1: os.PathLike, f2: os.PathLike) -> float:
        with open(f1) as f:
            content1 = self.normalize(f.read())
        with open(f2) as f:
            content2 = self.normalize(f.read())
        shingles1 = self.shingle(content1, self.n_gram)
        shingles2 = self.shingle(content2, self.n_gram)
        return len(shingles1 & shingles2) / len(shingles1 | shingles2)

    def deduplicate(self, files: list[os.PathLike], output_dir: os.PathLike):
        signatures = {}
        buckets = {}
        for file in files:
            with open(file) as f:
                content = self.normalize(f.read())
            shingles = self.shingle(content, self.n_gram)
            signatures = self.signatures(shingles)
            for i in range(self.num_hashes - self.num_bands):
                bucket_id = (
                    i,
                    tuple(signatures[i : i + self.num_bands]),
                )
                if bucket_id not in buckets:
                    buckets[bucket_id] = []
                buckets[bucket_id].append(file)

        cadidates = set()
        for fs in buckets.values():
            for i in range(len(fs)):
                for j in range(i + 1, len(fs)):
                    cadidate = tuple(sorted((fs[i], fs[j])))
                    cadidates.add(cadidate)

        deduplicates = set()
        for f1, f2 in cadidates:
            if f1 in deduplicates or f2 in deduplicates:
                continue
            if self.jaccard_similarity(f1, f2) >= self.jaccard_threshold:
                deduplicates.add(f1)

        for file in files:
            if file in deduplicates:
                continue
            with open(file) as f:
                content = f.read()
            with open(os.path.join(output_dir, os.path.basename(file)), "a") as f_out:
                f_out.write(content)
数据混合:比例之外,还要计算每个来源会被看多少遍
训练语料通常来自网页、百科、论文、书籍和代码等多个来源。最简单的做法是人工指定比例、均匀采样,或按来源 token 数成比例采样:
其中 \(N_s\) 是来源 \(s\) 的可用 token 数。按量采样不容易反复消费小数据集,却可能让大规模普通网页压倒高质量小来源;均匀采样能提高小来源权重,却可能让它们被重复几十次。真正需要控制的量不是比例本身,而是来源的期望 epoch 数:
假设普通网页有 \(10\,\mathrm{T}\) tokens,高质量数据只有 \(10\,\mathrm{B}\) tokens,总训练预算为 \(1\,\mathrm{T}\) tokens,并让两者各占 50%。普通网页只会经历 \(0.05\) 个 epoch,而高质量来源会经历 \(50\) 个 epoch。后者虽然“质量高”,却可能因过度重复而过拟合。
UniMax 的关键不是一句笼统的“均匀混合”,而是在尽量均衡覆盖来源时,对每个来源的重复次数设置硬上限。若最大允许 epoch 数为 \(C\),完整约束应写成:
等价地,\(p(s)N_{\mathrm{train}}\le C N_s\)。省略右侧的 \(N_s\) 会让公式失去“重复次数上限”的量纲含义。
RegMix 则把混合比例选择变成回归问题:先从 Dirichlet 等分布采样多个候选 mixture,用每个 mixture 训练较便宜的小模型;再拟合“混合比例到验证损失或下游表现”的映射,最后搜索预测最优点,并把该比例用于更大规模训练。
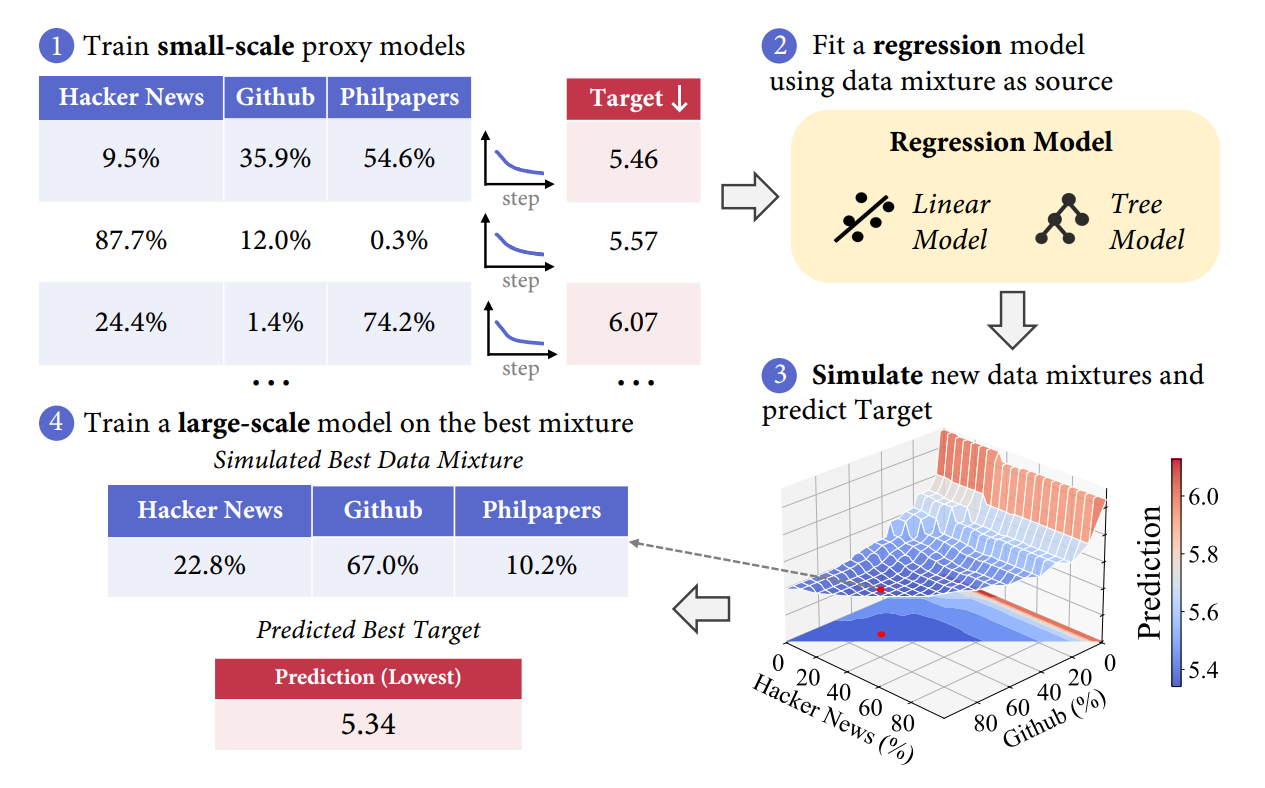
这里有两个不能隐去的假设:回归器必须在最优点附近足够准确,小模型上的最优 mixture 也必须能够迁移到大模型和更长训练。第二个假设尤其容易被 epoch 效应破坏。若小规模试验只训练 \(10\,\mathrm{B}\) tokens,而正式训练为 \(1\,\mathrm{T}\) tokens,可按比例 \(10\,\mathrm{B}/1\,\mathrm{T}=0.01\) 同步缩小各来源的可用数据量,让小实验提前暴露正式训练中的重复风险。这类 simulated epoching 是一种尺度校准手段,不保证消除所有分布迁移。
合成推理数据
进入 mid-training 或监督微调阶段后,数据样本通常不再只是连续文本,而更接近真实评测:一个环境、一项任务或 prompt,以及一条可验证的回答或轨迹。最小生成闭环可以写成“定义环境 → 构造问题 → 从 teacher 采样回答 → 验证与筛选 → 形成训练样本”。其中最昂贵的往往不是调用模型,而是定义什么算有效问题、如何判断回答正确,以及如何保留足够多样的解题路径。
OpenThoughts 提供了一个具体案例:其论文所述版本把 27 个真实与合成来源的问题汇集起来,使用 QwQ-32B 作为 teacher,扩展到约 120 万条样本,并发现每个 prompt 采样多个回答有帮助;课程材料给出的实验设置为每题 16 个回答。
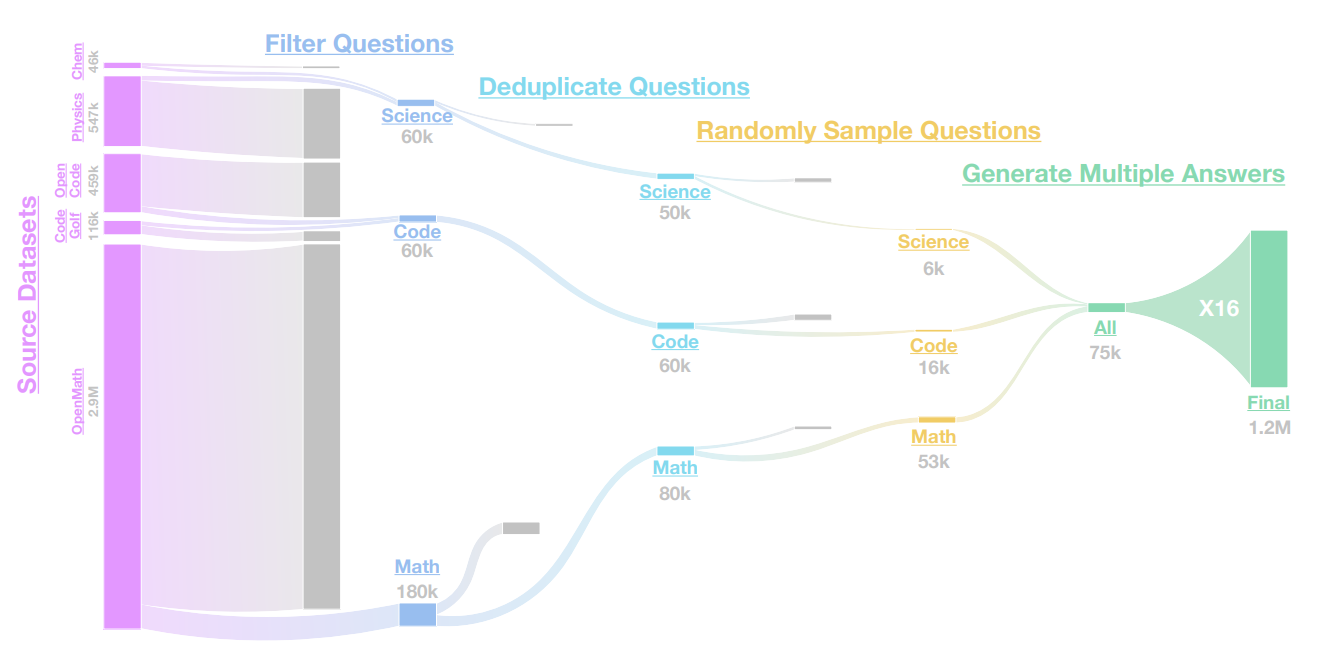
这些观察必须限定在 OpenThoughts 的模型、题源、预算与筛选设置内。Teacher 的价值取决于它能否稳定产生适合学生模型学习的轨迹,而不是只取决于 teacher 自己的最终 benchmark 分数;过滤是否有效也取决于验证器质量、采样温度、每题候选数和错误分布。
一条可审计的合成样本至少应保存:问题来源及版本、teacher checkpoint 或 API 版本、prompt template、采样参数、完整回答、验证器结果、过滤原因和生成时间。若只保留最终答案,就无法区分模型学到的是可迁移的推理过程、偶然猜中,还是评测格式泄漏。
SWE 数据
软件工程数据比数学题更难规模化,因为答案是否正确通常要在特定仓库、依赖和测试环境里执行。环境构建失败、依赖版本漂移、测试本身不完整,都会把“数据生成失败”和“模型能力不足”混在一起。高价值 SWE 数据因此不只是 issue 与 patch 的文本配对,而是仓库快照、任务描述、工具调用、执行反馈、补丁和测试结果组成的状态轨迹。
SWE-smith 采取半合成路线:从真实 Python 仓库出发,让语言模型引入能够破坏现有测试的 bug,再把修复过程转成训练任务。论文报告的数据版本覆盖 128 个 GitHub 仓库并生成约 5 万项任务。真实仓库提供了代码结构和依赖约束,任务本身则由模型合成,从而在真实性与规模之间取得折中。
SWE-Zero 进一步利用强模型对代码语义的先验,在不提供仓库专属执行反馈的条件下生成大规模轨迹,再用数量更少、带执行反馈的 SWE-Hero 轨迹做第二阶段精修。课程引用的论文版本报告约 30 万条 SWE-Zero 与 1.3 万条 SWE-Hero 轨迹。这里的“模型具有代码 world model”应视为对实验现象的解释,而不是已经被独立证明的内部机制。
SWE-rebench 走另一条路线:持续从真实 GitHub PR 中构造新鲜、可执行的 Python 软件工程任务,既扩大训练数据,也减少固定 benchmark 随时间产生的污染。课程材料引用的版本包含约 2.1 万项交互式任务,来自 3400 个仓库和约 45 万个候选 PR。SWE-ZERO-12M 又把无执行轨迹扩展到千万级;这类数字更新很快,引用时应绑定论文或数据集版本与访问日期,而不能写成长期不变的规模。
生成 SWE 数据时尤其要防止未来信息泄漏。用于求解任务的仓库快照不能包含后续修复 commit,agent 也不应通过 git history 直接读取答案。环境镜像、依赖锁文件、测试命令、网络权限、timeout、scaffold 版本和重试预算都应成为样本元数据,否则同一条轨迹很难复现,也无法判断改进来自模型还是工具链。
数据处理pipeline
过滤、去重、混合和合成并不是四个互不相关的脚本。上游转换决定后续算法能看到哪些结构;过滤器改变来源分布;去重改变各来源的有效 token 数;混合比例又决定样本会经历多少 epoch。任何一步重跑,都可能改变最终训练集,因此需要把数据版本和决策过程作为模型产物的一部分管理。
环节 |
至少记录什么 |
重点验证什么 |
|---|---|---|
转换 |
源 URL/快照、解析器与版本、内容哈希、失败原因 |
正文、代码、表格与公式是否被错误截断或线性化 |
过滤 |
目标样本、模型版本、分数、阈值、保留原因 |
按语言和领域统计误杀率、保留率与分布漂移 |
去重 |
item 粒度、shingle 规则、哈希参数、重复簇与保留代表 |
误删、超大 bucket、train/eval 污染与删除后文档连贯性 |
混合 |
来源版本、token 数、采样概率、训练预算与 epoch 上限 |
小规模最优解能否迁移,长尾来源是否被重复过度 |
合成 |
teacher、prompt、采样参数、scaffold、环境与验证轨迹 |
答案正确性、多样性、泄漏、执行可复现性与过滤偏差 |
以下给出常见pipeline的demo实现:
从互联网网页提取纯文本
from fastwarc.warc import ArchiveIterator, WarcRecordType
from resiliparse.parse.encoding import detect_encoding
from resiliparse.extract.html2text import extract_plain_text


def extract_text_from_html(html_content: bytes):
    coding = detect_encoding(html_content)
    content = html_content.decode(coding)
    plain_text = extract_plain_text(content)
    return plain_text
识别目标语言
import fasttext
import numpy as np
import fasttext.FastText


# Monkey-patch fasttext to fix NumPy 2.0 incompatibility
def _patched_predict(self, text, k=1, threshold=0.0, on_unicode_error="strict"):
    """Patched version of FastText.predict to avoid np.array(..., copy=False)"""

    def check(entry):
        if entry.find("\n") != -1:
            raise ValueError("predict processes one line at a time (remove '\\n')")
        entry += "\n"
        return entry

    if type(text) is list:
        text = [check(entry) for entry in text]
        all_labels, all_probs = self.f.multilinePredict(text, k, threshold, on_unicode_error)

        return all_labels, all_probs
    else:
        text = check(text)
        predictions = self.f.predict(text, k, threshold, on_unicode_error)
        if predictions:
            probs, labels = zip(*predictions)
        else:
            probs, labels = ([], ())

        return labels, np.array(probs)


fasttext.FastText._FastText.predict = _patched_predict


class LanguageIdentifier:
    def __init__(self, model_path="pre_trained/lid.176.bin"):
        self.model = fasttext.load_model(model_path)
        self.label_prefix = "__label__"

    def identify(self, text: str, k=1):
        text = text.replace("\n", " ")
        text = text.replace("\r", " ")
        label, probs = self.model.predict(text, k)
        label = [l.replace(self.label_prefix, "") for l in label]
        if k == 1:
            return label[0], probs[0]
        else:
            return label, probs
文本质量粗过滤
词数过滤: 50 <=wc <=100000,太短或异常长的文本直接过滤掉.
平均词长过滤:3 <= avg_len <=10,用来排除大量单字符/乱码或超长“词”的文本.
字母占比过滤:统计每个 token 是否包含字母字符,要求“含字母 token 的比例”≥ 0.8
import nltk
from nltk.tokenize import word_tokenize


class QualityFilter:
    def __init__(self):
        nltk.download("punkt")
        nltk.download("punkt_tab")

    def pass_wc_filter(self, tokens: list[str]) -> bool:
        wc = len(tokens)
        return 50 <= wc <= 100000

    def pass_word_len_filter(self, tokens: list[str]) -> bool:
        lens = [len(token) for token in tokens]
        avg_len = sum(lens) / len(lens)
        return 3 <= avg_len <= 10

    def pass_alphabetic_filter(self, tokens: list[str]) -> bool:
        has_alpha = [1 if any(char.isalpha() for char in token) else 0 for token in tokens]
        return 1.0 * sum(has_alpha) / len(has_alpha) >= 0.8

    def pass_ellipsis_filter(self, content: str) -> bool:
        line_cnt = 0
        ellipsis_cnt = 0
        for line in content.split("\n"):
            line_cnt += 1
            if line.endswith("..."):
                ellipsis_cnt += 1
        return ellipsis_cnt / line_cnt < 0.3

    def pass_all_filters(self, content: str) -> bool:
        tokens = word_tokenize(content)
        return (
            self.pass_wc_filter(tokens)
            and self.pass_word_len_filter(tokens)
            and self.pass_alphabetic_filter(tokens)
            and self.pass_ellipsis_filter(content)
        )
文本质量分类
基于 fastText 实现二分类的“文本质量分类器”,可输出高/低质量分类和置信度分数。
import fasttext


def train(
    input_file="data/quality_classifier/train.txt",
    epoch=25,
    lr=1.0,
    wordNgrams=2,
    verbose=2,
    minCount=1,
    loss="softmax",
    checkpoint_path="checkpoints/quality_classifier.bin",
):
    model = fasttext.train_supervised(
        input=input_file,
        epoch=epoch,
        lr=lr,
        wordNgrams=wordNgrams,
        verbose=verbose,
        minCount=minCount,
        loss=loss,
    )

    model.save_model(checkpoint_path)


class QualityClassifier:
    def __init__(self, model_path="checkpoints/quality_classifier.bin"):
        self.model = fasttext.load_model(model_path)
        self.label_prefix = "__label__"

    def identify(self, text: str, k=1):
        if not text.strip():
            return "low-quality", 0.0
        text = text.replace("\n", " ")
        labels, probs = self.model.predict(text, k=1)

        label = labels[0].replace("__label__", "")
        confidence = float(probs[0])

        if label not in ["high_quality", "low_quality"]:
            return "low-quality", 0.0

        label = label.replace("_", "-")

        return label, confidence


if __name__ == "__main__":
    train()
有害数据检测
import fasttext
import numpy as np
import fasttext.FastText


# Not safe for work detector
class NSFWDetector:
    def __init__(self, model_path="pre_trained/jigsaw_fasttext_bigrams_nsfw_final.bin"):
        self.model = fasttext.load_model(model_path)
        self.label_prefix = "__label__"

    def identify(self, text: str, k=1):
        text = text.replace("\n", " ")
        text = text.replace("\r", " ")
        label, probs = self.model.predict(text, k)
        label = [l.replace(self.label_prefix, "") for l in label]
        if k == 1:
            return label[0], probs[0]
        else:
            return label, probs


class ToxicDetector:
    def __init__(self, model_path="pre_trained/jigsaw_fasttext_bigrams_hatespeech_final.bin"):
        self.model = fasttext.load_model(model_path)
        self.label_prefix = "__label__"

    def identify(self, text: str, k=1):
        text = text.replace("\n", " ")
        text = text.replace("\r", " ")
        label, probs = self.model.predict(text, k)
        label = [l.replace(self.label_prefix, "") for l in label]
        if k == 1:
            return label[0], probs[0]
        else:
            return label, probs
Mask PII
个人身份识别数据遮蔽
import re


class PIIMasker:
    def __init__(self):
        pattern = r"\b[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Z|a-z]{2,}\b"
        self.email_pattern = re.compile(pattern=pattern)
        # self.phone_pattern = re.compile(pattern=r"\b\d{3}-\d{3}-\d{4}\b")

        self.phone_pattern = re.compile(
            r"""
            (?:
                \(?\d{3}\)?[-.\s]?
                \d{3}[-.\s]?
                \d{4}
            )
            """,
            re.VERBOSE,
        )

        self.ipv4_pattern = re.compile(
            r"""
            \b
            (?:
                25[0-5]
                |
                2[0-4][0-9]
                |
                1[0-9]{2}
                |
                [1-9]?[0-9]
            )
            (?:
                \.
                (?:
                    25[0-5]
                    |
                    2[0-4][0-9]
                    |
                    1[0-9]{2}
                    |
                    [1-9]?[0-9]
                )
            ){3}
            \b
            """,
            re.VERBOSE,
        )

    def mask_emails(self, content: str) -> tuple[str, int]:
        """
        Mask emails in the content.
        """

        matchs = self.email_pattern.findall(content)

        masked_content = self.email_pattern.sub("|||EMAIL_ADDRESS|||", content)
        return masked_content, len(matchs)

    def mask_phone_numbers(self, content: str) -> tuple[str, int]:
        matchs = self.phone_pattern.findall(content)
        masked_content = self.phone_pattern.sub("|||PHONE_NUMBER|||", content)
        return masked_content, len(matchs)

    def mask_ipv4(self, content: str) -> tuple[str, int]:
        matchs = self.ipv4_pattern.findall(content)
        masked_content = self.ipv4_pattern.sub("|||IP_ADDRESS|||", content)
        return masked_content, len(matchs)
最终应当能够从任一训练 token 追溯到来源、转换版本、过滤理由、重复簇和混合策略,并能够用冻结配置重建同一份数据快照。数据工程的目标不是得到一个看似干净的目录,而是建立一条可解释的因果链:为什么这个样本进入训练,它被看了多少遍,它对哪些能力有帮助,又可能引入哪些偏差。
去重
不再赘述